Anthropic の Claude API は、問い合わせ対応の自動化からドキュメント処理、社内システムへのエージェント組み込みまで、業務システムに大規模言語モデル(LLM)を組み込むための実装基盤として広く使われています。単発のテキスト生成にとどまらず、ツール使用による外部システム連携、長文コンテキストの読み込み、画像入力への対応など、実務で必要になる機能が Messages API という単一のエンドポイントに集約されているのが特徴です。
本記事では、Claude API を業務システムへ統合する際の設計判断を、モデルの選び方、基本実装、ツール使用によるエージェント化、コストとパフォーマンスの最適化、セキュリティと運用の順に整理します。コード例は公式 SDK(Python)を用いた実装を示し、どの機能をどの場面で使い分けるかという判断基準を中心に解説します。
Claude API の特徴と提供経路
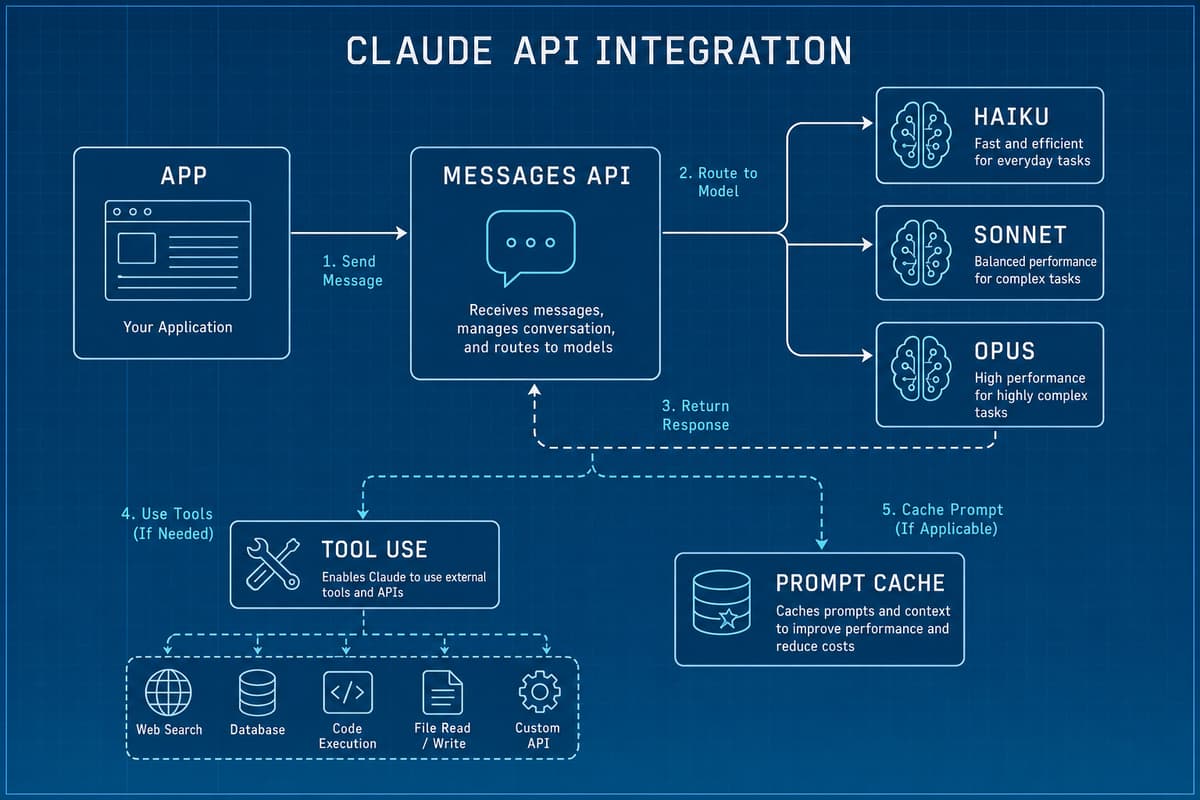
Claude API のリクエストは、基本的に Messages API(POST /v1/messages)に集約されています。会話履歴を messages 配列で渡し、モデルが応答を返すという単純な構造の上に、ツール使用・拡張思考・プロンプトキャッシュといった機能がパラメーターとして重なる設計です。ツールや構造化出力も別エンドポイントではなく、この単一エンドポイントの機能として提供されます。
提供経路は3つあります。Anthropic 自身が運用する Claude API に加え、Amazon Bedrock 経由と Google Vertex AI 経由でも同じ Messages API を利用できます。すでに AWS や Google Cloud 上に基盤を持つ組織であれば、既存の認証・課金・ネットワーク境界の中に統合できるため、クラウド事業者経由を選ぶ判断も現実的です。ただし機能によっては提供経路ごとに対応状況が異なるため、利用したい機能が対象経路で使えるかは事前に確認しておく必要があります。
データの取り扱いも統合判断の前提になります。API 経由で送信したデータがモデルの学習に使われることはありません。この点はエンタープライズ利用で最初に問われる懸念に対する明確な回答であり、機密性の高い社内データを扱うシステムに組み込む際の判断材料になります。
モデルの選び方
2026年時点の主力モデルは3系統です。用途に応じて使い分けることが、品質とコストの両立につながります。
- Claude Opus 4.8 — 最高性能のモデルです。複雑なコード生成、長期にわたる自律的なエージェント処理、高度な推論を要する業務に向きます。
- Claude Sonnet 4.x 系 — 性能とコストのバランスに優れ、日常的な問い合わせ対応や文書処理など、多くのアプリケーションで基準となる選択肢です。
- Claude Haiku 4.5 — 高速かつ低コストで、分類・要約・簡易な抽出といった軽量なタスクを大量に処理する用途に適しています。
実務では単一モデルに固定せず、処理の難易度でルーティングする設計が有効です。定型的な一次応答を Haiku、判断や生成が絡む本処理を Sonnet、最も難しい少数のケースを Opus に振り分けることで、全体のコストを抑えつつ必要な品質を確保できます。モデル ID は文字列で指定するだけで切り替えられるため、この振り分けはアプリケーション側のロジックとして実装できます。
Messages API による基本実装
公式 SDK を使えば、認証・リトライ・型定義が組み込まれた状態で API を呼び出せます。API キーは環境変数 ANTHROPIC_API_KEY から自動的に読み込まれるため、コードにキーを直書きする必要はありません。次の例は、繰り返し使う長文コンテキスト(製品仕様や FAQ など)をシステムプロンプトに置き、プロンプトキャッシュを有効化した基本形です。
import anthropic

client = anthropic.Anthropic()  # ANTHROPIC_API_KEY を環境変数から取得

response = client.messages.create(
    model="claude-opus-4-8",
    max_tokens=1024,
    system=[
        {
            "type": "text",
            "text": PRODUCT_KNOWLEDGE,  # 製品仕様やFAQなど繰り返し使う長文
            "cache_control": {"type": "ephemeral"},
        }
    ],
    messages=[
        {"role": "user", "content": "返品ポリシーを教えてください。"}
    ],
)

for block in response.content:
    if block.type == "text":
        print(block.text)

# キャッシュから読み込まれたトークン数を確認する
print(response.usage.cache_read_input_tokens)
応答の content は種類の異なるブロックの配列である点に注意が必要です。テキストを取り出す際は block.type を確認してから block.text を参照します。また stop_reason には応答が終了した理由が入り、end_turn(正常終了)、max_tokens(出力上限に到達)、tool_use(ツール呼び出しを要求)などを区別して処理を分岐させます。長い出力が想定される場合は、HTTP タイムアウトを避けるためストリーミング(client.messages.stream)に切り替えるのが実務上の定石です。
ツール使用によるエージェント化
ツール使用(tool use、いわゆる function calling)は、Claude を業務システムのエージェントとして機能させる中心的な仕組みです。呼び出し可能な関数の名前・説明・入力スキーマを定義して渡すと、モデルは必要に応じて「このツールをこの引数で呼びたい」という要求を返します。実際の実行はアプリケーション側で行い、結果を戻すと、モデルはそれを踏まえて応答を続けます。データベース照会、在庫確認、外部 API 呼び出しといった実世界の操作を、モデルの判断で連鎖させられます。
tools = [
    {
        "name": "get_order_status",
        "description": "注文番号から配送状況を取得する。ユーザーが注文や配送について尋ねたときに呼び出す。",
        "input_schema": {
            "type": "object",
            "properties": {
                "order_id": {"type": "string", "description": "注文番号"}
            },
            "required": ["order_id"],
        },
    }
]

response = client.messages.create(
    model="claude-opus-4-8",
    max_tokens=1024,
    tools=tools,
    messages=[{"role": "user", "content": "注文 A1234 の配送状況を知りたいです。"}],
)

if response.stop_reason == "tool_use":
    for block in response.content:
        if block.type == "tool_use":
            result = get_order_status(block.input["order_id"])  # 自社システムを照会
            # tool_result を messages に追加して再度呼び出し、最終応答を得る
ツールの説明文は、モデルが「いつ」そのツールを呼ぶかを判断する材料になります。何をするツールかだけでなく、どういう場面で呼び出すべきかを具体的に書くことで、呼び出しの精度が上がります。SDK にはこのツール呼び出しのループを自動で回すツールランナーも用意されており、承認ゲートやログ記録といった介入点を保ちながら実装を簡潔にできます。より複雑な連携では、MCP(Model Context Protocol)を用いてツールやデータソースへの接続を標準化する方法もあります。
難易度の高い推論が必要な場面では、拡張思考(extended thinking)を有効化することで回答精度を高められます。現行モデルでは thinking={"type": "adaptive"} を指定し、モデル自身が思考の深さを調整する方式が基本です。加えて output_config の effort でコストと品質のバランスを調整できます。
コストとパフォーマンスの最適化
従量課金である以上、コスト設計は統合の成否を分けます。最も効果が大きいのはモデルの使い分けで、前述のとおり処理の難易度に応じて Haiku・Sonnet・Opus を振り分けます。その上で、以下の機能が実効的なコスト削減とレイテンシ改善につながります。
- プロンプトキャッシュ。システムプロンプトや長い参照文書のように、リクエストをまたいで共通する接頭部分をキャッシュします。2回目以降はキャッシュ読み込み分の料金が基準入力の約1割まで下がり、処理時間も短縮されます。キャッシュはプレフィックス一致で機能するため、変化しない内容を先頭に、リクエストごとに変わる内容を末尾に置く構成が前提になります。
- Batch API。即時性を求めない大量処理は、バッチとして非同期に投入することで標準価格の半額で実行できます。夜間の一括分類やレポート生成など、レイテンシよりコストを優先する処理に向きます。
- 長文コンテキストと画像入力。対応モデルでは最大100万トークン級の長文コンテキストを扱えるため、大量の資料を分割せずに投入できます。ビジョン(画像入力)を使えば、スクリーンショットや図面を含む問い合わせにもそのまま対応できます。
効果の測定も欠かせません。応答の usage に含まれる cache_read_input_tokens が繰り返し呼び出しでゼロのままであれば、システムプロンプトに埋め込んだ日時や逐次変わる ID などがキャッシュを無効化している可能性があります。実測値を確認しながら接頭部分を安定させることが、最適化の第一歩です。
セキュリティと運用
本番運用では、機能の使いこなし以上に運用設計が問われます。実務で押さえておきたい観点は次のとおりです。
- シークレット管理。API キーはコードやリポジトリに含めず、Azure Key Vault などのシークレットストアで管理し、実行時に環境変数として注入します。アクセス権限は最小限に絞り、漏洩時に備えてローテーションできる構成にしておきます。
- リトライとレート制御。SDK は 429(レート制限)や 5xx(一時的なサーバー側エラー)に対して指数バックオフで自動リトライします。想定トラフィックに対してレート上限が十分かを確認し、必要に応じてリクエストのキューイングを設計します。
- システムプロンプト設計。役割・制約・出力形式をシステムプロンプトで明確に定義します。過度に強い命令文はかえって挙動を不安定にするため、必要なことを簡潔に指示する方が安定します。
- エラーとエスカレーション。ツール実行の失敗は
tool_resultにis_errorを立てて戻すことで、モデルに回復の機会を与えられます。判断が難しいケースや感情的な対応が必要な場面は、人間へエスカレーションする経路を必ず用意します。
データが学習に使われないという前提と合わせて、これらの運用設計が整って初めて、機密情報を扱う業務システムに安心して組み込めます。
まとめ
Claude API の統合で軸になるのは、Messages API を土台に、ツール使用でエージェント化し、プロンプトキャッシュとモデルの使い分けでコストを最適化するという3点です。単発の生成から自律的なエージェントまで同じ API 上で構築できるため、小さな一次応答ボットから始めて段階的に機能を広げる進め方が取りやすくなっています。まずは対象業務を一つ選び、モデルの振り分けとキャッシュ設計を含めた最小構成で検証し、実測値をもとに拡張していくのが堅実な進め方です。
エンハンスド株式会社では、Claude をはじめとする LLM の業務システムへの統合を、要件定義からモデル選定、コスト最適化、セキュリティ設計、本番運用まで一貫して支援しています。自社のどの業務に適用できるか、どのモデル構成が費用対効果に見合うかといった検討段階からのご相談も承ります。導入を具体化したい方は、お気軽にお問い合わせください。
このテーマの全体像は .NET × AI 活用 完全ガイド にまとめています。
この記事をシェア
関連記事
OpenAI で業務自動化を実装する — Assistants から Responses / Agents SDK へ
OpenAI の Assistants API は、会話状態の保持とツール実行を API 側で引き受けることで、問い合わせ対応や社内アシスタントといった業務自動化を短いコードで組めるようにした仕組みで…
TensorSharp とは — C# だけで動く GGUF 推論エンジンが llama.cpp に挑む
ローカル LLM のコミュニティ r/LocalLLaMA で、 TensorSharp という .NET 製の推論エンジンが llama.cpp とのベンチマークを公開し、注目を集めました。…
Microsoft Agent Framework Harness とは — LLMを自律エージェントに変える実行基盤
Microsoft は 2026 年 7 月 22 日、 Microsoft Agent Framework の新機能である Agent Harness の一般提供を発表しました。ハーネスは、…