稼働中のレガシー .NET システムを刷新するとき、最も避けたいのは「一括リライトして一斉に切り替える」進め方です。ストラングラーフィグパターン(Strangler Fig Pattern)は、既存システムを動かしたまま外側から機能を少しずつ新実装へ置き換え、旧システムの担当範囲を徐々に絞り込み、最終的に旧システムを退役させる段階移行の手法です。本稿では .NET 10 と YARP を前提に、境界の切り出し方からデータ整合性、ルーティング切替、ロールバック、退役判定までを整理します。
ストラングラーフィグパターンとは
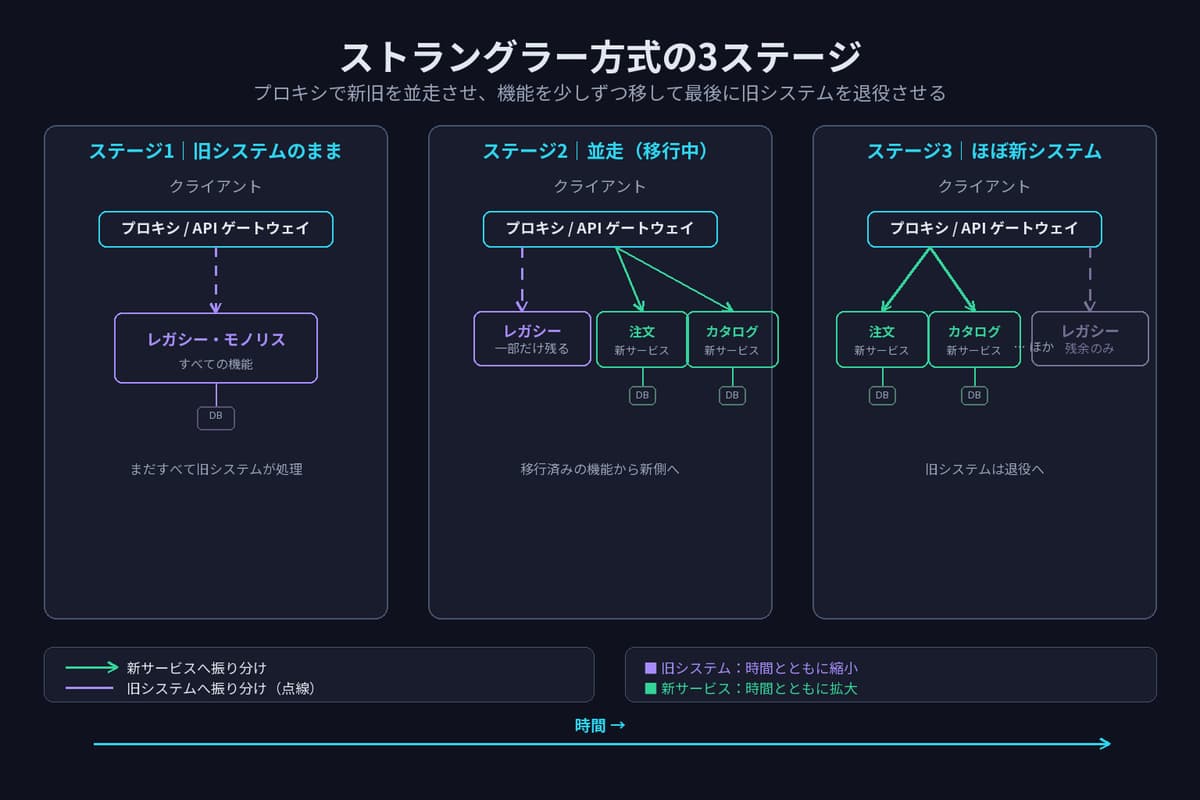
名前は、宿主の木を外側から覆いながら成長し、やがて元の木を置き換える「絞め殺しの木(ストラングラーフィグ)」に由来します。ソフトウェアでは、既存システムの前段にファサード(多くはリバースプロキシ)を置き、リクエストを機能単位で新旧どちらかに振り分けます。最初はほぼすべてが旧システムに流れますが、機能を新実装に移すたびにルーティングを新側へ寄せていき、旧システムに残る責務がゼロになった時点で退役させます。
この方式の要点は、移行の全期間を通じて常に本番稼働する動くシステムが存在することです。ビッグバン移行のように「新旧の切替日」に全リスクを集中させるのではなく、小さな置き換えを繰り返して各ステップでリスクを検証しながら前進します。
なぜ一括リライトは危険か
旧システムを凍結して裏で完全な新システムを作り、完成後に一斉切替する進め方には構造的なリスクがあります。
- 要件が動く — 大規模リライトは数か月から年単位になり、その間も事業要件は変わり続ける。完成時点で新システムが旧システムより遅れている、という逆転が起きやすい。
- フィーチャーフリーズの負担 —リライト中に旧システムへ機能追加すると差分が二重管理になる。逆に凍結すると事業側が待てない。
- 切替日に全リスクが集中 —本番投入するまで実トラフィックでの検証ができず、問題が出ても切り戻しの単位が大きい。
- 仕様の暗黙知が失われる —旧システムの隅にある例外処理や業務ルールは、実際に並走させて挙動を比較しないと拾いきれない。
段階移行はこれらを、機能単位の小さなリリースに分解して解消します。
リバースプロキシ(YARP)で新旧を並走させる
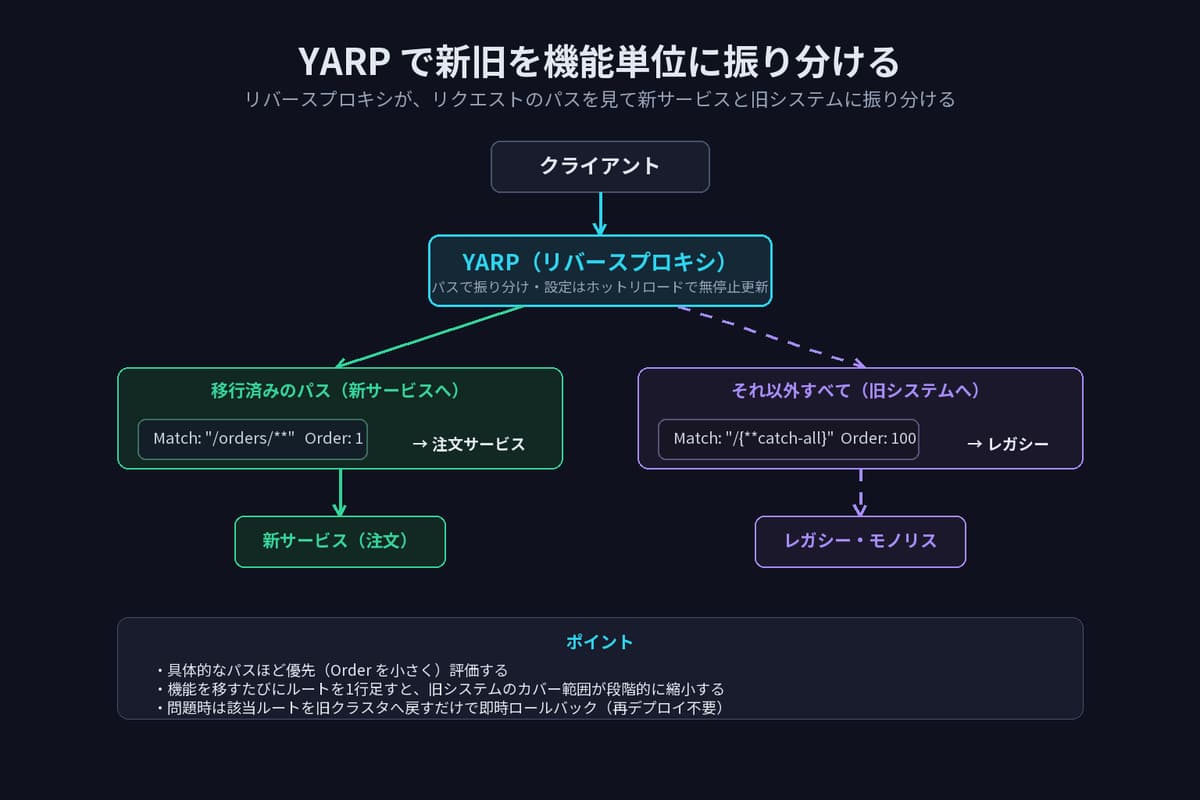
段階移行の心臓部が、新旧の手前に置くリバースプロキシです。.NET では YARP(Yet Another Reverse Proxy)が標準的な選択肢で、ASP.NET Core アプリとして構成でき、ルーティングを設定ファイルまたはコードで機能単位に制御できます。.NET 10 世代の YARP は HTTP/3 対応や応答キャッシュが強化されています。
まず YARP をホストする最小構成です。
var builder = WebApplication.CreateBuilder(args);

builder.Services
    .AddReverseProxy()
    .LoadFromConfig(builder.Configuration.GetSection("ReverseProxy"));

var app = builder.Build();

app.MapReverseProxy();
app.Run();
ルーティングは appsettings.json に宣言します。既定はすべて旧システム(legacy)へ流し、移行済みの機能パスだけを新システム(new)へ向けます。ルートはより具体的なパスを優先評価させるのがポイントです。
{
  "ReverseProxy": {
    "Routes": {
      "orders-new": {
        "ClusterId": "new",
        "Match": { "Path": "/orders/{**catch-all}" },
        "Order": 1
      },
      "legacy-catchall": {
        "ClusterId": "legacy",
        "Match": { "Path": "/{**catch-all}" },
        "Order": 100
      }
    },
    "Clusters": {
      "new":    { "Destinations": { "d1": { "Address": "https://orders.internal/" } } },
      "legacy": { "Destinations": { "d1": { "Address": "https://legacy.internal/" } } }
    }
  }
}
この構成では /orders 配下だけが新サービスへ、それ以外は従来どおり旧システムへ流れます。機能を移すたびに新しいルートを一行足して Order を低く(優先度高く)設定すれば、旧システムのカバー範囲が段階的に縮小していきます。設定はホットリロードできるため、無停止でルーティングを更新できます。
切り出す単位の決め方
どの機能から切り出すかで移行の難易度が大きく変わります。技術的に安全で、かつ早期に価値を示せる単位を選びます。
- 境界が明確な機能から —入出力が HTTP や明示的なインターフェースで区切れていて、旧システム内部の共有状態への依存が少ないものを優先する。
- 依存の少ない葉から —他機能から呼ばれる中核ロジックより、外側の画面や API のように依存の末端にある機能のほうが切り離しやすい。
- 読み取り主体の機能を先に —参照系はデータ整合性の難易度が低く、実トラフィックでの新旧比較(シャドウ実行)も安全に行える。
- 変更頻度と事業価値 —よく手が入る機能を先に移すと、以降の開発がすべて新基盤の恩恵を受けられる。
切り出しの前に、旧システムのどのモジュールがどのテーブルや外部サービスに依存しているかを可視化しておくと、後述するデータ共有の設計判断が容易になります。
データの共有と整合性
段階移行で最も難しいのは、新旧が同じ業務データを扱う期間のデータ整合性です。移行の進捗に応じて次の選択肢を組み合わせます。
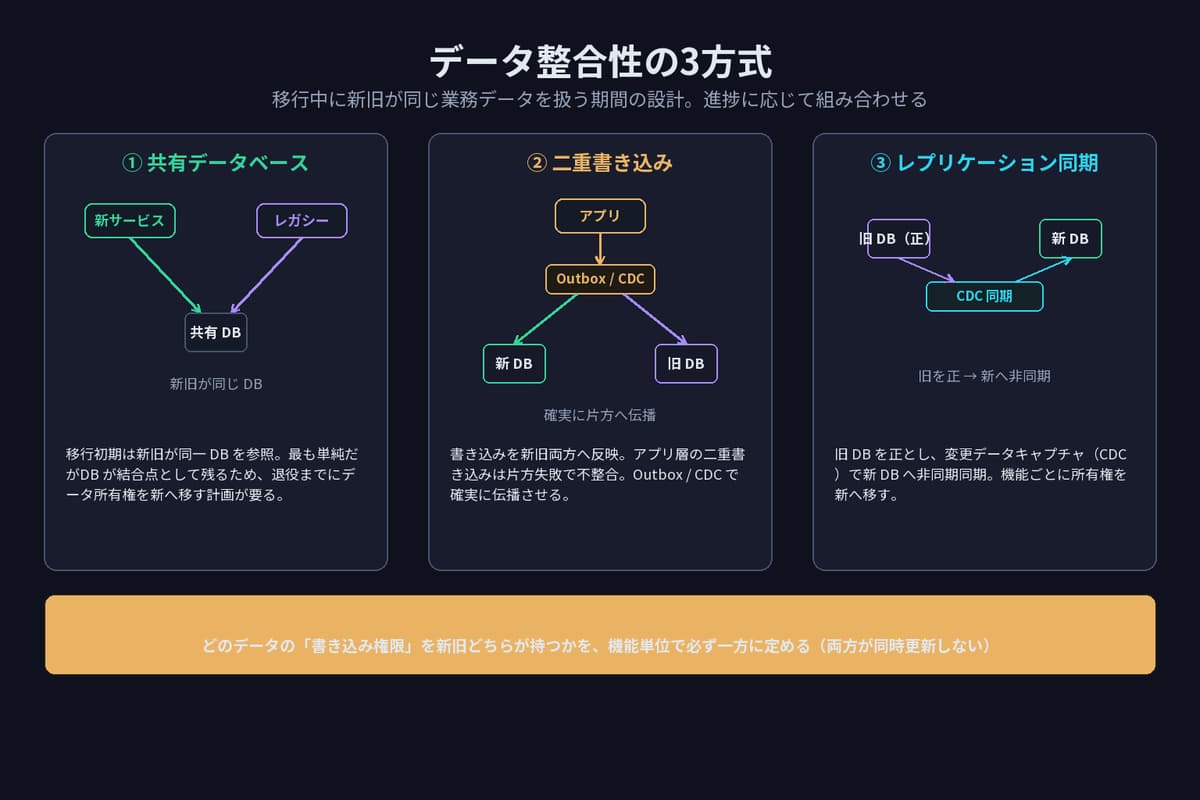
- 共有データベース — 移行初期は新旧が同一 DB を参照するのが最も単純。スキーマ変更を避けられる反面、DB が新旧の結合点として残り続けるため、退役までにデータ所有権を新側へ移す計画が要る。
- 二重書き込み(dual-write) — 書き込みを新旧両方のストアへ反映する。アプリ層で二重書き込みすると片方の失敗時に不整合が生じるため、Outbox パターンやトランザクションログの購読(CDC)で片方を確実に伝播させる設計が安全。
- 同期・レプリケーション —旧 DB を正とし、変更データキャプチャで新 DB へ非同期同期する。移行中は旧を真実の源とし、機能ごとに所有権を新へ移していく。
いずれの方式でも、「どのデータの書き込み権限を新旧どちらが持つか」を機能単位で一つに定めることが不整合を防ぐ鍵です。同じデータを両方が同時に更新する状態を作らないようにします。
ルーティング切替とカナリアリリース
新実装ができても、いきなり全トラフィックを新側へ向けるのは避けます。YARP のルーティングとクラスタの重み付けを使い、段階的に比率を上げます。
- シャドウ実行 — 実リクエストを旧側で処理しつつ、複製を新側にも流して結果を比較する。応答はユーザーに返さないため、参照系の挙動差異を安全に洗い出せる。
- カナリアリリース — 新側に 1%、5%、25% と少しずつトラフィックを寄せ、エラー率・レイテンシ・業務指標を監視しながら比率を上げる。
- ヘッダやユーザー属性での振り分け —社内ユーザーやベータ対象だけを新側に向け、実利用で検証してから一般公開する。
クラスタに複数の宛先と重みを持たせ、新旧を同一ルート内で比率配分する構成例です。
{
  "Clusters": {
    "orders": {
      "LoadBalancingPolicy": "PowerOfTwoChoices",
      "Destinations": {
        "legacy": { "Address": "https://legacy.internal/", "Metadata": { "Weight": "90" } },
        "new":    { "Address": "https://orders.internal/", "Metadata": { "Weight": "10" } }
      }
    }
  }
}
切替の判断は勘ではなく指標で行います。移行前に新旧を横断する分散トレーシングとダッシュボードを用意し、切替のたびに定量的な合否基準(エラー率の上限、レイテンシの許容値など)を満たすかを確認します。
リスク管理とロールバック
段階移行の安全性は、いつでも即座に旧側へ戻せることに支えられます。
- ルーティングでの即時切戻し —問題を検知したら、YARP の該当ルートを旧クラスタへ戻すだけで復旧できる状態にしておく。再デプロイを伴わず設定変更で戻せることが重要。
- 後方互換なデータ変更 —スキーマ変更は「追加」を基本とし、列やテーブルの削除は旧側が完全に不要になってから。切戻し時に旧システムが読めなくなる破壊的変更を移行中に行わない。
- 冪等性 — 二重書き込みやリトライで同一処理が複数回走っても結果が壊れないよう、書き込みを冪等に設計する。
- 小さいバッチ —一度に移す機能を小さく保つほど、問題の切り分けと切戻しの単位が小さくなる。
ASP.NET Core への段階移行と System.Web Adapters
ASP.NET(System.Web / MVC 5 / Web Forms)から ASP.NET Core への移行では、リバースプロキシによるプロセス分離に加えて、System.Web Adapters(Microsoft.AspNetCore.SystemWebAdapters)が段階移行を後押しします。これは HttpContext や HttpContext.Current といった System.Web 系 API のアダプタを提供し、旧コードを大きく書き換えずに ASP.NET Core 側へ移植できるようにする仕組みです。
さらにセッション状態やクレームを新旧アプリ間で共有する Remote App 連携を備えており、YARP と組み合わせて「同一のセッションを保ったまま、ページ単位で新 ASP.NET Core アプリへ移す」進め方が可能になります。ASP.NET から ASP.NET Core への移行は、この System.Web Adapters とプロキシによる並走を基盤に、画面やエンドポイント単位で少しずつ寄せていくのが定石です。
移行の完了判定と旧システム退役
段階移行は「新システムができた」時点では終わりません。旧システムに流れるトラフィックが実質ゼロになり、旧側が担っていたデータ所有権がすべて新側へ移り、想定される全経路(バッチ、外部連携、例外系を含む)が新実装でカバーされたことを確認して初めて退役に進めます。
- トラフィックの実測 —YARP のログで旧クラスタへのリクエストが一定期間ゼロであることを確認する。ゼロにならないパスは、まだ移せていない機能の存在を示す。
- データ所有権の移管完了 —共有 DB や二重書き込みを解消し、新側を唯一の真実の源にする。
- 退役の段取り —旧システムをすぐ削除せず、一定期間は停止(読み取り専用や縮退)にとどめて切戻し余地を残し、問題がないことを確認してから正式に廃止する。
この最終段階まで計画に含めておかないと、旧システムが「なんとなく残り続ける」状態になり、二重運用のコストとリスクだけが残ります。退役までを一連の移行として設計することが、ストラングラーパターンを完遂させる条件です。
まとめ
ストラングラーフィグパターンは、既存システムを止めずに外側から機能を置き換え、旧システムを段階的に退役させる移行手法です。YARP によるルーティング制御、データ整合性の設計、カナリアリリース、即時ロールバック、そして退役判定までを一連の計画として組むことで、一括リライトのリスクを避けながらモダナイゼーションを完遂できます。ASP.NET から ASP.NET Core への移行では System.Web Adapters が段階移行の実務を支えます。
このテーマの全体像は .NET モダナイゼーション完全ガイド にまとめています。関連して .NET Framework 4.x から .NET 10 への移行プレイブック、ASP.NET Web Forms から Blazor への移行ガイド、レガシー .NET 移行前 診断チェックリスト も参考になります。
エンハンスド株式会社では、事業を止めない段階的なモダナイゼーションを支援しています。
- レガシーシステム モダナイゼーション - レガシー資産を分析し、最新 .NET への安全な移行を支援
- クラウドネイティブ & 移行 - Azure / AWS でクラウドネイティブな設計と移行を支援
この記事をシェア
この記事に関連する支援サービス
記事で扱っている領域について、支援内容と事例をまとめたページがあります。
関連記事
オンプレ .NET アプリの Azure 移行完全ガイド
オンプレミスで稼働している .NET アプリを Azure へ移行するプロジェクトは、単なるサーバーの引っ越しではなく、アセスメント・移行戦略の選定・ランディングゾーン整備・IaC と CI/CD・監…
【Ver1.0到達🎉】ReactネイティブエンジンJsxCoreが正式版をリリース!同時にAstroにC#を持ち込むAstroSharpを発表
先日、 ASP.NET Core のビューを JSX/TSX で書き、React/Preact でレンダリングする ビューエンジン JsxCore を 前回の記事 で紹介しました。…
【リリース間近】Node.js不要でASP.NET CoreのReactフロント開発が可能に?JsxCoreとは一体なんなのか
フロントに React や TypeScript を使いたいが、そのために Node.js や npm、バンドラーの一式を .NET プロジェクトへ持ち込むのは重い——多くの ASP.NET Core…