Claude Code や OpenAI の Codex、Google の Gemini CLI といったエージェント型ツールが実務に定着し、開発者が同時に扱える作業の数は着実に増えました。一方で、一つのリポジトリを一つの作業ディレクトリで運用していると、AIエージェントに大きめのタスクを任せている間は別の作業に手を付けにくく、ブランチを切り替えるたびに変更を退避させる手間も生じます。
この制約を素直に解消できるのが Git の worktree 機能です。本記事では、git worktree の基本から、複数のAIエージェントを作業ツリーごとに並行して走らせる運用、CIとの組み合わせ、そして運用上つまずきやすい注意点までを、実際のコマンドを交えて整理します。
git worktree の基本
通常、git のリポジトリでは一つのディレクトリに一つの作業ツリー(チェックアウトされたファイル群)が対応します。ブランチを切り替えると、同じディレクトリの中身がそのブランチの内容に置き換わります。worktree は、この「一リポジトリ一作業ツリー」という前提を外し、同じリポジトリから複数の作業ツリーを別々のディレクトリに展開できるようにする機能です。
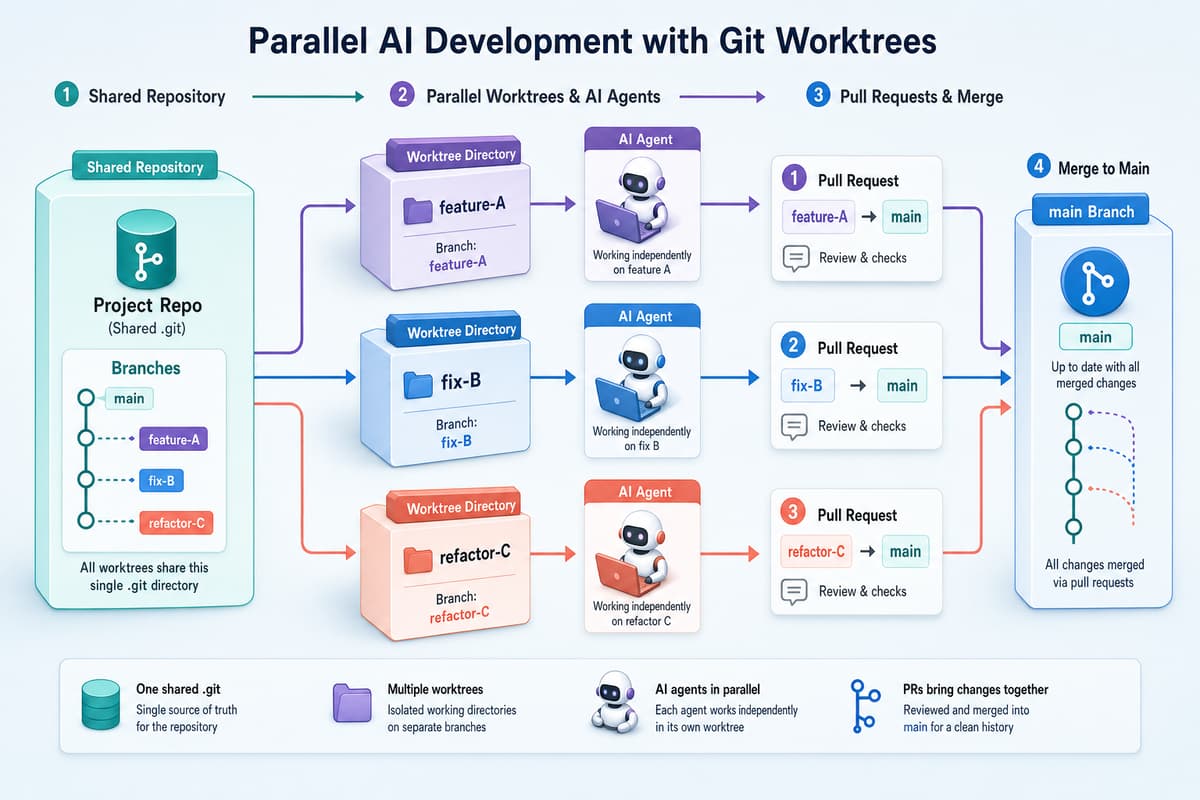
各作業ツリーはそれぞれ独立したブランチをチェックアウトでき、ファイルの状態も完全に分離されます。履歴やオブジェクトの本体は一つの .git を共有するため、ブランチをまるごとクローンし直すのに比べてディスク消費も少なく、生成も高速です。あるブランチで作業しながら、別のディレクトリで並行して別ブランチをビルド・テストするといった使い方が、退避や切り替えなしに行えます。
なぜAIエージェントと相性が良いのか
エージェント型ツールの多くは、カレントディレクトリを起点にファイルを読み書きし、テストやビルドを実行します。したがって作業ツリーが分離されていれば、複数のエージェントが互いのファイルを踏むことなく、それぞれのブランチ上で独立して動けます。この性質が、AI駆動開発における worktree の価値を生みます。
第一に、待ち時間を作業に変えられます。あるエージェントに時間のかかる実装を任せている間、別の作業ツリーで急ぎのバグ修正を別のエージェントに進めさせる、といった並行運用が可能になります。第二に、変更の衝突を構造的に避けられます。作業ツリーごとにブランチが分かれているため、同時進行のタスクが同じ未コミットの変更に干渉することがありません。第三に、レビューを並列化できます。タスクごとにブランチとプルリクエストが独立するため、機能単位で切り分けてレビューを回せます。
結果として、実装を待つ時間より、仕様の提示とレビュー、統合の判断に人の時間を配分しやすくなります。効果の大きさはタスクの粒度やチーム構成によって変わりますが、独立性の高い複数タスクを抱えているほど恩恵は大きくなります。
セットアップと基本コマンド
worktree の操作は git worktree のサブコマンドに集約されています。まずは作業ツリーを一つ追加してみます。add にディレクトリのパスと、-b で新規ブランチ名を渡します。
# リポジトリのルートで実行する
cd ~/projects/my-app

# 新しい作業ツリーを親ディレクトリ側に作り、新規ブランチをチェックアウトする
git worktree add ../my-app-auth -b feature/auth

# 既存ブランチをチェックアウトして作業ツリーを作る場合
git worktree add ../my-app-hotfix fix/login-bug
作成済みの作業ツリーは list で一覧できます。パス、コミット、チェックアウト中のブランチが並んで表示されます。
git worktree list

# 出力例
/home/user/my-app          a1b2c3d [main]
/home/user/my-app-auth     e4f5a6b [feature/auth]
/home/user/my-app-hotfix   c7d8e9f [fix/login-bug]
作業が終わった作業ツリーは remove で片付けます。ディレクトリを手動で削除した場合は、管理情報だけが残るため prune で整理します。
# 作業ツリーを削除する(未コミットの変更があると警告が出る)
git worktree remove ../my-app-hotfix

# ディレクトリを手動削除した後、参照情報を掃除する
git worktree prune
作業ツリーごとにAIエージェントを走らせる
基本の流れは、タスクごとに作業ツリーを用意し、それぞれのディレクトリでエージェントを起動するというものです。ターミナルを分けておけば、各エージェントが独立したコンテキストで並行して動きます。
# ターミナル1: 認証機能の実装
cd ../my-app-auth
claude "JWTによる認証を実装する。リフレッシュトークンの発行と失効も含める"

# ターミナル2: N+1問題の修正
cd ../my-app-perf
codex "商品一覧のN+1クエリを解消する。Eager Loading で最適化する"

# ターミナル3: APIの整理
cd ../my-app-api
gemini "REST APIのエンドポイント命名を統一し、OpenAPI定義を更新する"
作業ツリーの生成からエージェントの起動までを一つのスクリプトにまとめておくと、タスクの立ち上げが定型化できます。次の例は、名前・ブランチ・依頼内容を受け取って作業ツリーを作り、その中でエージェントを起動する最小限のシェル関数です。
#!/usr/bin/env bash
# spawn-agent.sh — 作業ツリーを作ってエージェントを起動する
set -euo pipefail

name="$1"      # 例: auth
branch="$2"    # 例: feature/auth
prompt="$3"    # 依頼内容

worktree="../$(basename "$PWD")-${name}"
git worktree add "$worktree" -b "$branch"

# 依存関係を用意してからエージェントを起動する
( cd "$worktree" && npm install && claude "$prompt" )
ブランチ名と作業ツリーのパスに一貫した命名規則を設けておくと、一覧や後片付けが把握しやすくなります。タスク種別をプレフィックスに含める(feature/、fix/ など)だけでも、複数エージェントの状況を追いやすくなります。
CIとの組み合わせ
並列で変更が積み上がると、統合時の品質確認が追いつかなければ手戻りが増えます。作業ツリーはあくまでローカルで並行作業を進める仕組みであり、最終的な合流は通常どおりブランチとプルリクエストを経由します。したがって、各ブランチが同じ品質ゲートを通る状態を整えておくことが、並列化の速度を活かす前提になります。
プルリクエスト単位でビルドとテストを走らせておけば、どの作業ツリーで生成された変更であっても、同一の基準で検証されます。次は GitHub Actions でプルリクエストごとにビルドとテストを実行する例です。
name: ci
on: [pull_request]
jobs:
  build-and-test:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - uses: actions/setup-node@v4
        with:
          node-version: '22'
      - run: npm ci
      - run: npm run build
      - run: npm test
ローカルでも、各作業ツリーでコミット前にテストを走らせておくと、統合段階での失敗を早い段階に寄せられます。エージェントに実装を任せる際、依頼の中に「変更後にテストを実行し、通ることを確認する」といった受け入れ条件を含めておくと、生成物の確からしさが上がります。
運用上の注意点
作業ツリーは分離されていても、その外側で共有される資源までは分離されません。まず気をつけたいのが、ポートやデータベースといった共有リソースの競合です。複数の作業ツリーで同じ開発サーバーやDBを同時に起動すると、ポートやスキーマがぶつかります。作業ツリーごとにポートや接続先を分ける設定を用意しておくと安全です。
# docker-compose.override.yml — 作業ツリーごとにポートをずらす例
services:
  db:
    ports:
      - "5433:5432"   # 別の作業ツリーでは 5434 などに変える
次に依存関係の扱いです。node_modules やビルド成果物、.env のような無視対象のファイルは作業ツリー間で共有されないため、新しい作業ツリーではインストールや設定ファイルの配置をやり直す必要があります。前述のスクリプトのように、作業ツリー作成後に依存の準備までを自動化しておくと取りこぼしを防げます。環境変数を含む機密ファイルをコピーする場合は、リポジトリにコミットされないことを改めて確認します。
# 新しい作業ツリーに環境設定を用意する
cp .env ../my-app-auth/.env
( cd ../my-app-auth && npm install )
最後に後片付けです。作業ツリーは放置すると増え続け、ディスクを圧迫し、一覧の見通しも悪くなります。ブランチをマージしてタスクが完了したら、その都度 git worktree remove で削除し、必要に応じて git worktree prune で参照情報を整理する運用を習慣にしておくと、常に把握できる範囲に保てます。
エンハンスド株式会社では、AI駆動開発の導入を検討している企業向けに、エージェント型ツールの選定や、git worktree を含む並列開発の運用設計、CI・レビュー体制の整備といった生産性向上の支援を行っています。自社の開発プロセスにどう組み込めるかという段階からご相談いただけます。
このテーマの全体像は .NET × AI 活用 完全ガイド にまとめています。
この記事をシェア
関連記事
AI駆動開発の実践ガイド — ツールの使い分けと現場で効く進め方
AIコーディングツールは、コード補完の域を超え、リポジトリ全体を横断して変更・実行・検証まで担う「エージェント」へと進化しました。2026年時点では、GitHub Copilot、…
Microsoft Agent Framework Harness とは — LLMを自律エージェントに変える実行基盤
Microsoft は 2026 年 7 月 22 日、 Microsoft Agent Framework の新機能である Agent Harness の一般提供を発表しました。ハーネスは、…
.NET × AI 活用 完全ガイド — アプリ組み込みからAI駆動開発まで
AI を「アプリに組み込む」側と、AI で「開発そのものを速くする」側——その両方をまとめた入り口ページです。 Azure OpenAI や RAG の実装、各種 LLM API の統合、…