Power BI を中核に据えたデータ分析基盤は、この数年で前提が大きく変わりました。かつて分析ワークロードの受け皿だった Azure Synapse Analytics は、Microsoft Fabric への統合と後継化が進み、新規構築では Fabric を起点に検討するのが自然な流れになっています。本記事では、Fabric(OneLake、Lakehouse / Warehouse、Data Factory、Direct Lake)を前提に据えつつ、既存の Synapse 資産をどう位置づけるか、そして Power BI のセマンティックモデルや接続モード、行レベルセキュリティ、ガバナンスをどう設計するかを、実務の観点から整理します。
Synapse から Microsoft Fabric への移り変わり
Azure Synapse Analytics は、専用 SQL プールや Spark プール、パイプライン、ノートブックを一つのワークスペースにまとめ、データウェアハウスとビッグデータ分析を横断的に扱う基盤として広く使われてきました。Microsoft Fabric は、その機能群を SaaS として再構成し、Power BI と同一のプラットフォーム上に統合したサービスです。ストレージは OneLake に一本化され、コンピュートは容量(Capacity)として集約されるため、個別サービスをつなぎ合わせる従来の構成に比べて、運用の見通しが立てやすくなりました。
重要なのは、Synapse が単純に消えるわけではないという点です。既存の専用 SQL プールや Data Factory パイプラインは引き続き稼働し、Fabric とはショートカットやミラーリングを通じて共存できます。新規要件は Fabric で構築し、既存資産は段階的に寄せていくという二段構えが、現実的な移行方針になります。
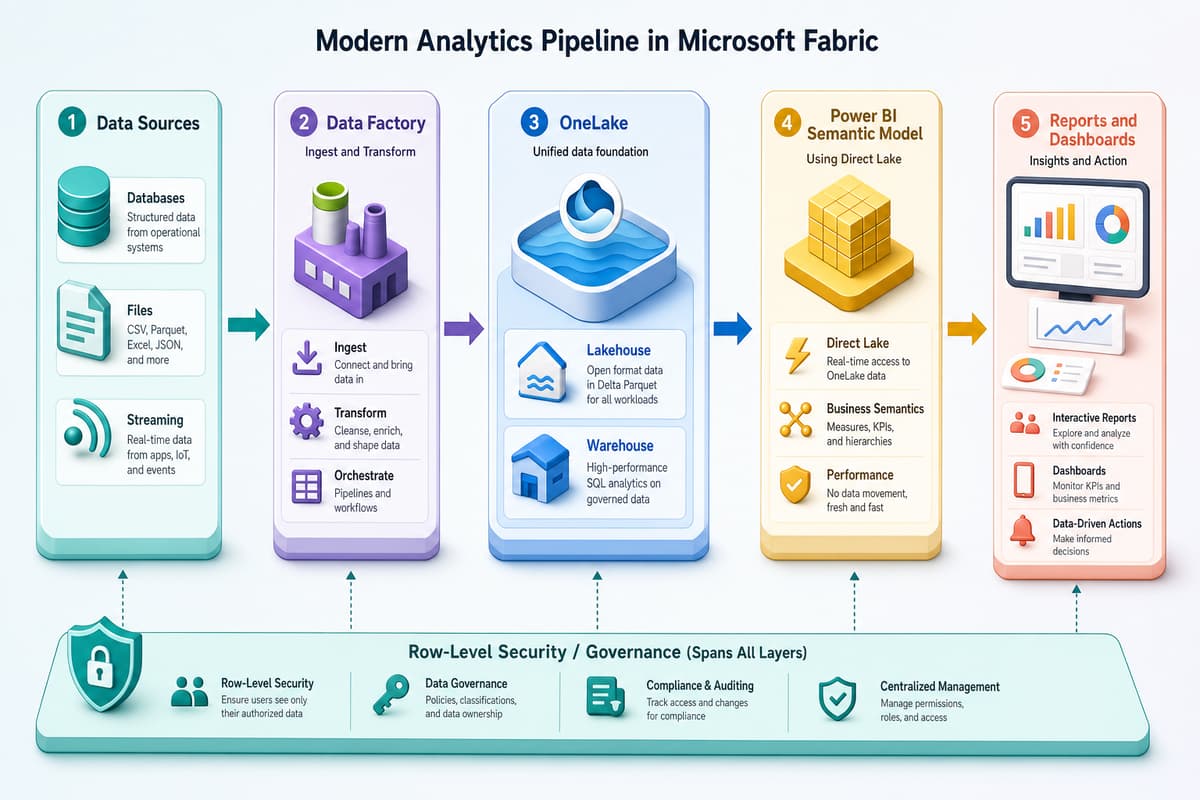
Microsoft Fabric を構成する主要な要素
Fabric を扱ううえで、まず押さえておきたい構成要素を整理します。
- OneLake — テナント全体で共有される単一のデータレイクで、Delta Parquet 形式を標準とし、あらゆるワークロードが同じ実体を参照する。
- Lakehouse — ファイルとテーブルを同居させ、Spark やノートブックによる柔軟な処理に向く。半構造化データや大規模な変換処理の受け皿となる。
- Warehouse — T-SQL による本格的なデータウェアハウス機能を提供し、トランザクション整合性やストアドプロシージャを必要とする業務系の集計に適する。
- Data Factory — データフローとパイプラインによる取り込み・変換を担い、Synapse / Azure Data Factory の設計思想を引き継ぐ。
- Direct Lake — Power BI が OneLake の Delta テーブルを直接読み取る接続モードで、Import の速度と DirectQuery の鮮度を両立させる。
Lakehouse と Warehouse は排他ではなく、探索的な処理は Lakehouse、統制の効いた集計は Warehouse と、役割で使い分ける構成が定石です。いずれも実体は OneLake 上の同じレイクに置かれるため、データを重複コピーせずに複数の分析用途へ展開できます。
Power BI の接続モードをどう選ぶか
Power BI のセマンティックモデル(旧データセット)は、レポートとデータソースの間に位置し、テーブル間のリレーションシップ、メジャー、行レベルセキュリティを定義する分析の中核です。接続モードの選定は、このモデルの性能とデータ鮮度を左右する最も重要な設計判断になります。
- Import — データをモデル内に取り込んで圧縮保持する方式で、応答が速い。更新頻度が日次程度で、容量に収まるデータ量であれば第一候補となる。
- DirectQuery — クエリのたびにソースへ問い合わせる方式で、常に最新を返す一方、応答はソース側の性能に依存する。大容量かつリアルタイム性が求められる場合に用いる。
- Direct Lake — OneLake の Delta テーブルを直接読み取り、Import に近い速度と DirectQuery に近い鮮度を両立する。Fabric を前提にした構成での標準的な選択肢となる。
実務では、集計済みの小さなモデルは Import、頻繁に変化する明細は Direct Lake、外部システムへの即時参照が必要な部分だけ DirectQuery、という混在構成に落ち着くことが多くあります。Direct Lake はソーステーブルの構造やクエリ内容によっては DirectQuery へフォールバックするため、モデル設計の段階で対象テーブルの形を Delta に合わせておくと安定します。
メジャーは DAX で定義します。前年同月比のように時系列を扱う指標は、日付ディメンションを整備したうえでタイムインテリジェンス関数を用いると簡潔に書けます。
売上 = SUM(Sales[Amount])

前年同月比 =
VAR Current = [売上]
VAR PriorYear =
    CALCULATE([売上], SAMEPERIODLASTYEAR('Date'[Date]))
RETURN
    DIVIDE(Current - PriorYear, PriorYear)
取り込みから可視化までのパイプライン設計
分析基盤は、取り込み、変換、モデル化、可視化という段階を意識して組み立てます。Fabric では、Data Factory のパイプラインでソースから OneLake へデータを取り込み、Lakehouse や Warehouse で変換・集計し、その結果を Power BI のセマンティックモデルが参照し、レポートやダッシュボードとして提供するという流れが基本形になります。
変換層では、明細をそのまま可視化に流すのではなく、分析の粒度に合わせた集計テーブルをあらかじめ用意しておくと、モデルが軽くなり応答も安定します。Warehouse 側では、CTAS(CREATE TABLE AS SELECT)で集計結果を実体化する手法が扱いやすく、日次バッチで洗い替える運用と相性が良好です。
CREATE TABLE dbo.SalesMonthly AS
SELECT
    CustomerKey,
    DATETRUNC(MONTH, SalesDate) AS SalesMonth,
    SUM(SalesAmount)  AS TotalSales,
    COUNT(*)          AS TransactionCount
FROM dbo.SalesFact
WHERE SalesDate >= '2025-01-01'
GROUP BY CustomerKey, DATETRUNC(MONTH, SalesDate);
取り込みの入口では、変化分だけを取り込む増分処理を前提にすると、コストと更新時間を抑えられます。Fabric のミラーリングを使えば、運用データベースの変更を継続的に OneLake へ反映でき、パイプラインを最小限に保ったまま鮮度を確保できます。
行レベルセキュリティとガバナンス
組織全体でデータを共有するほど、誰がどの範囲を見られるかという統制が重要になります。Power BI の行レベルセキュリティ(RLS)は、ログインユーザーに応じて表示行を絞り込む仕組みで、ロールとフィルター条件をモデル側に定義します。担当地域や組織階層に基づく制御が典型的な用途です。
-- SalesTerritory テーブルに設定するロールのフィルター
[Region] =
LOOKUPVALUE(
    UserSecurity[Region],
    UserSecurity[Email], USERPRINCIPALNAME()
)
管理者や全社閲覧者には全件を許可する例外条件を併せて定義しておくと、ロールの数を抑えつつ運用できます。RLS はモデル単位の制御であり、ソース側の権限設計と二重に守ることで、意図しない範囲の露出を防げます。
ガバナンスの観点では、Fabric に統合された Microsoft Purview による分類やデータ系譜(リネージ)の把握、機微データへの秘密度ラベル付与、エンドースメント(認定・推奨)によるモデルの信頼性表示などを組み合わせます。加えて、容量の使用状況を監視し、更新の失敗やクエリの遅延を早期に検知する運用体制を整えておくと、利用が拡大しても品質を保てます。
既存 Synapse 資産との共存と移行の勘所
すでに Synapse で運用している場合、すべてを一度に置き換える必要はありません。Fabric のショートカットを使えば、既存の Azure Data Lake Storage 上のデータを物理的に移動せずに OneLake から参照でき、ミラーリングを併用すれば運用データベースの内容を継続的に取り込めます。まずは新規の分析要件を Fabric 側で構築し、既存パイプラインは維持したまま、モデルとレポートから段階的に Direct Lake へ切り替えていくのが安全な進め方です。
移行の判断基準としては、更新頻度と鮮度の要件、扱うデータ量、既存 T-SQL 資産の再利用性、そして容量あたりのコストを軸に据えます。専用 SQL プールで作り込んだストアドプロシージャや複雑なクエリは Warehouse へ移しやすく、Spark ベースの処理は Lakehouse のノートブックへ引き継げます。要素ごとに移行先を見定め、優先度の高いワークロードから順に寄せていくことで、リスクを抑えながら基盤を刷新できます。
エンハンスド株式会社では、Power BI と Microsoft Fabric を軸としたデータ分析基盤の設計・構築・運用を支援しています。既存 Synapse 資産の評価から、Direct Lake を活かしたセマンティックモデルの設計、行レベルセキュリティとガバナンスの整備まで、現状の構成と要件に即した形でご提案します。データ活用の次の一歩を検討されている場合は、お気軽にご相談ください。
このテーマの全体像は .NET モダナイゼーション完全ガイド にまとめています。
この記事をシェア
関連記事
GitHub Copilot 企業導入・活用ガイド 2026年版
GitHub Copilot は、コード補完を起点としたツールから、開発ライフサイクル全体を支援するプラットフォームへと拡張してきました。2026年時点では、エディタ内での提案にとどまらず、…
【Ver1.0到達🎉】ReactネイティブエンジンJsxCoreが正式版をリリース!同時にAstroにC#を持ち込むAstroSharpを発表
先日、 ASP.NET Core のビューを JSX/TSX で書き、React/Preact でレンダリングする ビューエンジン JsxCore を 前回の記事 で紹介しました。…
【リリース間近】Node.js不要でASP.NET CoreのReactフロント開発が可能に?JsxCoreとは一体なんなのか
フロントに React や TypeScript を使いたいが、そのために Node.js や npm、バンドラーの一式を .NET プロジェクトへ持ち込むのは重い——多くの ASP.NET Core…