AKS(Azure Kubernetes Service)は、Kubernetes のコントロールプレーンをマネージドで提供し、ノードやネットワーク、監視、ID 連携を Azure のエコシステムと統合したフルマネージド Kubernetes サービスである。.NET アプリケーションを AKS 上で安定して本番運用するには、コンテナ化の作法だけでなく、ノードプール設計、スケーリング戦略、デプロイ手法、可観測性、シークレット管理、クラスターのアップグレード運用、コスト最適化までを一貫した方針として設計しておく必要がある。本記事では .NET アプリを AKS で運用するうえで押さえるべき要点を、実際の設定例とともに整理する。全体像は.NET モダナイゼーション完全ガイドを参照してほしい。
AKS 基礎とノードプール設計
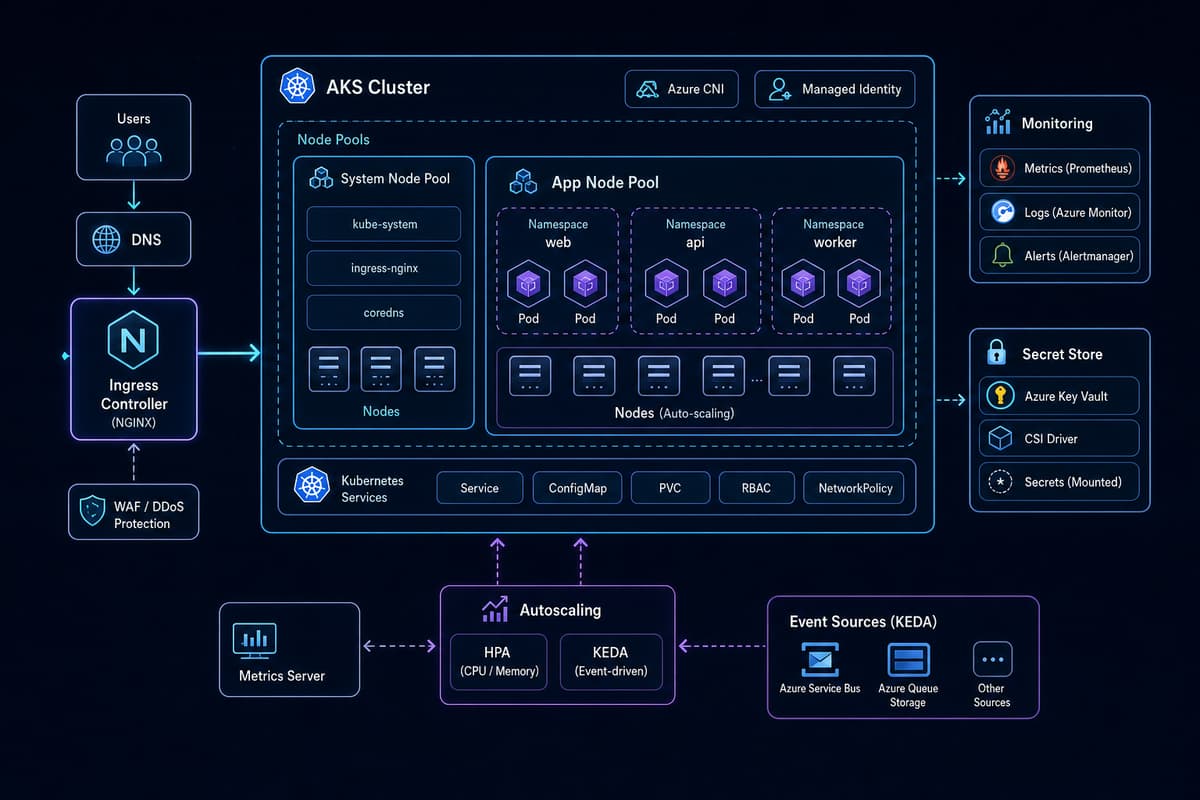
AKS ではコントロールプレーン(API Server、etcd、スケジューラなど)を Azure が管理し、利用者はワーカーノードを構成するノードプールと、そこで動くワークロードに責務を持つ。ノードプールは Virtual Machine Scale Set(VMSS)を基盤とし、用途ごとに複数のプールへ分割するのが基本方針である。
システムノードプールは CoreDNS や metrics-server といったシステム系 Pod を安定稼働させるための専有プールとし、アプリケーションはユーザーノードプールに配置する。ワークロードの特性(CPU 集約型、メモリ集約型、GPU、バッチ)ごとにプールを分け、`nodeSelector` や taint/toleration でスケジューリングを制御する。
# システムノードプールを持つクラスターを作成
az aks create \
  --resource-group rg-dotnet-prod \
  --name aks-dotnet-prod \
  --node-count 3 \
  --nodepool-name systempool \
  --node-vm-size Standard_D4ds_v5 \
  --network-plugin azure \
  --network-dataplane cilium \
  --enable-managed-identity \
  --tier standard

# アプリ用のユーザーノードプールを追加
az aks nodepool add \
  --resource-group rg-dotnet-prod \
  --cluster-name aks-dotnet-prod \
  --name apppool \
  --mode User \
  --node-count 3 \
  --node-vm-size Standard_D8ds_v5 \
  --labels workload=dotnet-api
本番クラスターでは可用性のため複数のアベイラビリティゾーンにノードを分散し、SLA を担保する Standard 以上のティアを選択する。ネットワークは Azure CNI(Overlay もしくは Cilium データプレーン)を採用すると、Pod への直接 IP 割り当てと高性能なネットワークポリシーが利用できる。個々のマイクロサービス設計の観点はKubernetes で実現するマイクロサービス完全ガイドで詳しく扱っている。
スケーリング — HPA / Cluster Autoscaler / KEDA
AKS のスケーリングは階層で考える。Pod のレプリカ数を調整する Horizontal Pod Autoscaler(HPA)、ノード数を調整する Cluster Autoscaler、そしてイベント駆動でスケールする KEDA の 3 つを組み合わせる。
HPA は CPU やメモリ、あるいはカスタムメトリクスに基づいてレプリカ数を増減させる。.NET API では CPU 使用率をトリガーにするのが一般的だが、リクエスト遅延やキュー長など、負荷をより正確に表すメトリクスを使うほうが望ましい。
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: dotnet-api
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: dotnet-api
  minReplicas: 3
  maxReplicas: 30
  metrics:
    - type: Resource
      resource:
        name: cpu
        target:
          type: Utilization
          averageUtilization: 65
  behavior:
    scaleDown:
      stabilizationWindowSeconds: 300
Cluster Autoscaler はノードプール単位で有効化し、HPA が要求した Pod をスケジュールできるだけのノードが不足した際に VMSS を拡張する。逆に空きノードは縮小され、コストを抑える。
az aks nodepool update \
  --resource-group rg-dotnet-prod \
  --cluster-name aks-dotnet-prod \
  --name apppool \
  --enable-cluster-autoscaler \
  --min-count 3 \
  --max-count 20
キューやイベントを起点とするワークロードには KEDA(Kubernetes Event-driven Autoscaling)を使う。AKS では KEDA をアドオンとして有効化でき、Azure Service Bus、Azure Storage Queue、Event Hubs などのイベントソースに応じて 0 から自動スケールする。バックグラウンドワーカーやメッセージ処理を担う .NET Worker Service に適している。
apiVersion: keda.sh/v1alpha1
kind: ScaledObject
metadata:
  name: order-worker
spec:
  scaleTargetRef:
    name: order-worker
  minReplicaCount: 0
  maxReplicaCount: 50
  triggers:
    - type: azure-servicebus
      metadata:
        queueName: orders
        messageCount: "20"
      authenticationRef:
        name: servicebus-auth
デプロイ — Helm / Kustomize とローリング更新
マニフェスト管理には Helm か Kustomize を採用する。Helm はチャートとしてパッケージ化し、値ファイルで環境差分を注入できるためリリース単位の管理に向く。Kustomize は base とオーバーレイでパッチを重ねる方式で、テンプレート言語を持たずプレーンな YAML を維持できる。どちらを選んでも、環境ごとの差分(レプリカ数、リソース制限、ホスト名)を明確に分離することが重要である。
デプロイ戦略は既定のローリング更新を基本とする。`maxSurge` と `maxUnavailable` で更新中の可用性を制御し、readiness プローブが通ったレプリカだけをサービスへ組み込む。.NET アプリでは、グレースフルシャットダウンのために `SIGTERM` を受けてから処理中リクエストを完了させる猶予(`terminationGracePeriodSeconds`)を確保する。
apiVersion: apps/v1
kind: Deployment
metadata:
  name: dotnet-api
spec:
  replicas: 3
  strategy:
    type: RollingUpdate
    rollingUpdate:
      maxSurge: 1
      maxUnavailable: 0
  template:
    spec:
      terminationGracePeriodSeconds: 30
      containers:
        - name: api
          image: enhancedsharedacr.azurecr.io/dotnet-api:1.4.2
          ports:
            - containerPort: 8080
          readinessProbe:
            httpGet:
              path: /healthz/ready
              port: 8080
            initialDelaySeconds: 5
            periodSeconds: 10
          livenessProbe:
            httpGet:
              path: /healthz/live
              port: 8080
            periodSeconds: 15
ヘルスチェックは ASP.NET Core の Health Checks ミドルウェアで readiness と liveness を分離して公開する。readiness は依存先(DB、キャッシュ)への接続確認を含め、liveness はプロセスの生存のみを判定するようにして、一時的な依存先障害で Pod が再起動され続ける事態を避ける。
Ingress とトラフィック制御
外部トラフィックの受け口には Ingress を用いる。AKS では、マネージドの Application Gateway for Containers や NGINX ベースのアプリケーションルーティングアドオン、あるいは Gateway API 実装を選択できる。TLS 終端、パスベースルーティング、ヘッダー書き換えといった L7 制御を Ingress 層に集約する。
apiVersion: networking.k8s.io/v1
kind: Ingress
metadata:
  name: dotnet-api
  annotations:
    cert-manager.io/cluster-issuer: letsencrypt-prod
spec:
  ingressClassName: webapprouting.kubernetes.azure.com
  tls:
    - hosts:
        - api.example.com
      secretName: api-tls
  rules:
    - host: api.example.com
      http:
        paths:
          - path: /
            pathType: Prefix
            backend:
              service:
                name: dotnet-api
                port:
                  number: 80
サービス間の細かなトラフィック制御(リトライ、タイムアウト、相互 TLS、カナリア分割)が必要な場合は、Istio ベースのマネージドサービスメッシュアドオンを検討する。ただしメッシュは運用の複雑度を上げるため、まずは Ingress と Kubernetes Service で要件を満たせるかを見極めたうえで導入する。より軽量なコンテナ実行基盤で足りるケースについてはAzure Container Apps で実現するマイクロサービスも比較検討の参考になる。
監視 — Azure Monitor / Container Insights / Prometheus・Grafana
可観測性はメトリクス、ログ、トレースの 3 本柱で構成する。AKS では Container Insights がノードや Pod のリソース使用状況とコンテナログを Log Analytics ワークスペースへ収集する。メトリクスは Azure Monitor マネージド Prometheus で収集し、Azure Managed Grafana で可視化するのが標準的な組み合わせである。
# 監視アドオンを有効化(マネージド Prometheus + Grafana + Container Insights)
az aks update \
  --resource-group rg-dotnet-prod \
  --name aks-dotnet-prod \
  --enable-azure-monitor-metrics \
  --enable-azure-monitor-app-monitoring
.NET アプリ側は OpenTelemetry を組み込み、トレースとメトリクスを OTLP でエクスポートする。分散トレースを Application Insights に集約すると、Ingress からアプリ、DB までのリクエストフローを追跡できる。アプリケーションメトリクスは Prometheus 形式で公開し、`ServiceMonitor` または `PodMonitor` でスクレイプ対象に加える。
builder.Services.AddOpenTelemetry()
    .ConfigureResource(r => r.AddService("dotnet-api"))
    .WithTracing(t => t
        .AddAspNetCoreInstrumentation()
        .AddHttpClientInstrumentation()
        .AddOtlpExporter())
    .WithMetrics(m => m
        .AddAspNetCoreInstrumentation()
        .AddRuntimeInstrumentation()
        .AddPrometheusExporter());

var app = builder.Build();
app.MapPrometheusScrapingEndpoint(); // /metrics を公開
アラートは Prometheus のルールと Azure Monitor のアラートルールを併用し、ノードの CPU/メモリ逼迫、Pod の再起動回数、readiness 失敗率、リクエスト遅延の SLO 逸脱などを検知して通知する。
シークレットと ID — Key Vault CSI ドライバと Workload Identity
接続文字列や API キーをマニフェストや環境変数に平文で持たせないことが原則である。AKS では Azure Key Vault Provider for Secrets Store CSI Driver を使い、Key Vault のシークレットをボリュームとして Pod にマウントする。認証は Microsoft Entra Workload Identity を用いて、Kubernetes の ServiceAccount と Entra のマネージド ID をフェデレーションで結び付ける。これによりノード上に長期資格情報を置かずにトークンベースで認証できる。
# CSI シークレットストアと OIDC/Workload Identity を有効化
az aks update \
  --resource-group rg-dotnet-prod \
  --name aks-dotnet-prod \
  --enable-oidc-issuer \
  --enable-workload-identity \
  --enable-secret-rotation \
  --enable-addons azure-keyvault-secrets-provider
apiVersion: secrets-store.csi.x-k8s.io/v1
kind: SecretProviderClass
metadata:
name: kv-dotnet-api
spec:
provider: azure
parameters:
usePodIdentity: "false"
useVMManagedIdentity: "false"
clientID: "<workload-identity-client-id>"
keyvaultName: "kv-dotnet-prod"
tenantId: "<tenant-id>"
objects: |
array:
- |
objectName: SqlConnectionString
objectType: secretServiceAccount には Workload Identity 用のアノテーションとラベルを付与し、Pod の `serviceAccountName` で紐付ける。シークレットの自動ローテーションを有効にしておくと、Key Vault 側で更新された値が一定間隔でマウント内容に反映される。
.NET コンテナの最適化
コンテナイメージはマルチステージビルドでビルド成果物のみを実行イメージへ持ち込み、サイズと攻撃対象領域を最小化する。実行ベースには Microsoft が提供する chiseled イメージ(不要なパッケージやシェルを排し、非 root で動作する distroless 相当のイメージ)を使うと、軽量かつセキュアになる。ネイティブ AOT や自己完結型トリミングが適用できるワークロードであれば、さらに起動時間とメモリ使用量を削減できる。
FROM mcr.microsoft.com/dotnet/sdk:10.0 AS build
WORKDIR /src
COPY *.csproj .
RUN dotnet restore
COPY . .
RUN dotnet publish -c Release -o /app

FROM mcr.microsoft.com/dotnet/aspnet:10.0-noble-chiseled AS final
WORKDIR /app
COPY --from=build /app .
USER $APP_UID
ENV ASPNETCORE_HTTP_PORTS=8080
EXPOSE 8080
ENTRYPOINT ["dotnet", "dotnet-api.dll"]
ランタイム設定では、スループット重視のサーバーアプリで Server GC を有効化する。ただし Kubernetes ではコンテナのメモリ制限を GC が正しく認識できるようにすることが重要で、`.NET` は cgroup のメモリ制限を尊重する。Server GC のヒープ数がノードの論理コア数に比例して増える点に注意し、コンテナに割り当てた CPU に見合うよう調整する。
        env:
          - name: DOTNET_gcServer
            value: "1"
          - name: DOTNET_GCHeapCount
            value: "2"
        resources:
          requests:
            cpu: "500m"
            memory: "512Mi"
          limits:
            cpu: "2"
            memory: "1Gi"
メモリ `limits` はアプリのワーキングセットに GC のオーバーヘッドを加えた値に設定し、OOMKill を避ける。`requests` はスケジューリングと Cluster Autoscaler の判断に使われるため、実測に基づいて現実的な値を与える。CPU `limits` は過度に絞るとスロットリングでレイテンシが悪化するため、負荷試験で確認する。
クラスターとノードのアップグレード運用
Kubernetes は年数回のマイナーバージョンがリリースされ、各バージョンのサポート期間は限られる。AKS ではコントロールプレーンとノードプールを個別にアップグレードでき、コントロールプレーンを先に上げてからノードプールを追随させる。ノードのアップグレードはサージノードを追加して Pod を退避(cordon/drain)しながら順次入れ替えるため、`maxSurge` の設定でロールアウト速度を制御する。
# 利用可能なアップグレードを確認
az aks get-upgrades \
  --resource-group rg-dotnet-prod \
  --name aks-dotnet-prod --output table

# コントロールプレーンをアップグレード
az aks upgrade \
  --resource-group rg-dotnet-prod \
  --name aks-dotnet-prod \
  --control-plane-only \
  --kubernetes-version 1.32.0

# ノードプールをアップグレード(サージ設定つき)
az aks nodepool upgrade \
  --resource-group rg-dotnet-prod \
  --cluster-name aks-dotnet-prod \
  --name apppool \
  --max-surge 33% \
  --kubernetes-version 1.32.0
アップグレード中の可用性は PodDisruptionBudget(PDB)で担保する。ドレイン時に最低稼働レプリカ数を割らないよう `minAvailable` を設定しておくと、ノード入れ替えでサービスが途切れない。ノードイメージのセキュリティパッチについては、計画メンテナンスウィンドウと自動アップグレードチャネル(`node-image` や `patch`)を設定し、手作業を減らしつつ更新を継続的に適用する。
apiVersion: policy/v1
kind: PodDisruptionBudget
metadata:
  name: dotnet-api
spec:
  minAvailable: 2
  selector:
    matchLabels:
      app: dotnet-api
コスト最適化 — スポットと適切な SKU
コスト最適化は SKU 選定、スケール下限、スポットノードの活用が軸になる。中断を許容できるバッチや非同期ワーカーは、スポットノードプールに配置すると大幅にコストを下げられる。スポットは Azure 側の都合で退去(eviction)される可能性があるため、taint を付与して耐障害性のあるワークロードのみを toleration で許可し、状態を持たない設計にする。
az aks nodepool add \
  --resource-group rg-dotnet-prod \
  --cluster-name aks-dotnet-prod \
  --name spotpool \
  --priority Spot \
  --eviction-policy Delete \
  --spot-max-price -1 \
  --enable-cluster-autoscaler \
  --min-count 0 \
  --max-count 20 \
  --node-vm-size Standard_D8ds_v5 \
  --labels workload=batch \
  --node-taints "kubernetes.azure.com/scalesetpriority=spot:NoSchedule"
常時稼働のオンデマンドノードには、予測可能な使用量に対して Azure の予約インスタンスや Savings Plan を適用してコストを圧縮する。ノード SKU は CPU とメモリの比率がワークロードに合ったものを選び、過大なノードで断片化した空きを生まないようにする。加えて、Container Insights のコスト最適化設定でログ収集の粒度を調整し、リソースの `requests` を実測に合わせて適正化することで、Cluster Autoscaler が無駄なノードを立てないようにする。オンプレミスからの移行を含む全体計画はオンプレ .NET アプリの Azure 移行完全ガイドで解説している。
まとめ
AKS 上での .NET アプリ本番運用は、ノードプールの分離設計から始まり、HPA・Cluster Autoscaler・KEDA による多層スケーリング、Helm/Kustomize を用いた安全なローリング更新、Container Insights と Prometheus/Grafana による可観測性、Key Vault CSI と Workload Identity によるシークレット管理、chiseled イメージと Server GC 調整によるコンテナ最適化、計画的なアップグレード運用、そしてスポットと適切な SKU 選定によるコスト最適化という各要素を一貫した方針でつなぐことで成り立つ。これらを標準化してテンプレート化しておけば、複数の .NET サービスを同じ運用モデルで安定して回せるようになる。
エンハンスド株式会社では、AKS を含むクラウドネイティブ基盤の設計・運用を支援しています。
- クラウドネイティブ & 移行 - Azure / AWS でクラウドネイティブな設計と移行を支援
- レガシーシステム モダナイゼーション - レガシー資産を分析し、最新 .NET への安全な移行を支援
この記事をシェア
関連記事
Kubernetesで運用する.NETマイクロサービスの実務ガイド
マイクロサービスへの分割それ自体は目的ではなく、独立したデプロイとスケール、障害の局所化によって開発と運用の速度を上げるための手段です。Kubernetes はその手段を支える基盤として広く定着し、…
Azure クラウドコスト最適化ガイド — .NET ワークロードのコストを下げる
Azure 上で .NET ワークロードを運用していると、利用が拡大するにつれてコストが想定を上回り、どこに無駄があるのか把握しづらくなる。…
オンプレ .NET アプリの Azure 移行完全ガイド
オンプレミスで稼働している .NET アプリを Azure へ移行するプロジェクトは、単なるサーバーの引っ越しではなく、アセスメント・移行戦略の選定・ランディングゾーン整備・IaC と CI/CD・監…