はじめに
マイクロサービスへの分割それ自体は目的ではなく、独立したデプロイとスケール、障害の局所化によって開発と運用の速度を上げるための手段です。Kubernetes はその手段を支える基盤として広く定着し、2026 年時点ではマネージド環境である AKS(Azure Kubernetes Service)を前提に設計を進める現場が一般的になっています。
本記事では、.NET で実装したサービスを Kubernetes 上で運用する際に押さえておきたい要素を、実際に適用できる YAML を交えて整理します。取り上げるのは、Pod から Ingress までの基本構成、設定とシークレットの分離、健全性プローブと自動スケール、安全なリリースとリソース設計、サービスメッシュと可観測性、そして GitOps と AKS 固有の運用です。個々の機能を単体で紹介するのではなく、実運用でどう組み合わせるかという観点でまとめます。
Kubernetes 上のマイクロサービスを構成する基本要素
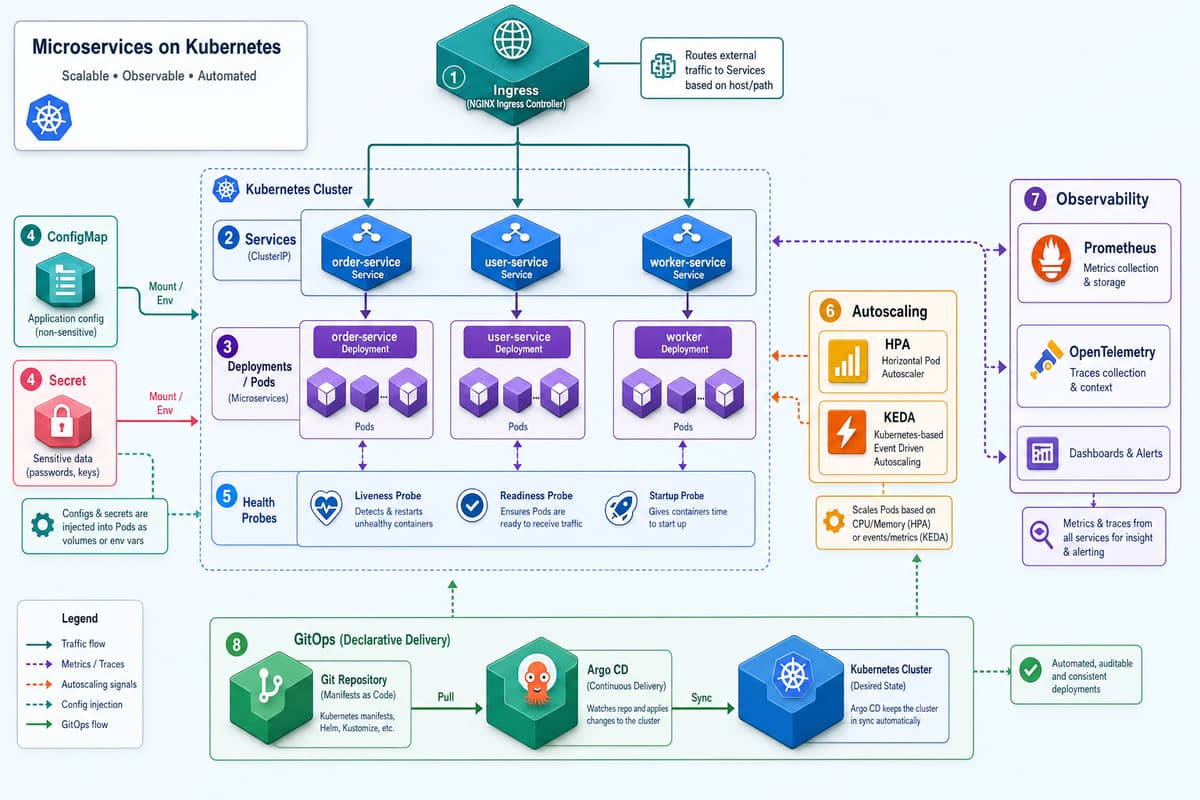
Kubernetes 上のワークロードは、いくつかのオブジェクトを組み合わせて表現します。まず把握しておきたいのは次の 4 つです。
- Pod — コンテナを実行する最小単位。通常は Pod を直接作らず、上位のコントローラに任せる。
- Deployment — Pod のレプリカ数とバージョンを宣言的に管理し、更新とロールバックを担う。
- Service — 変動する Pod 群に安定したクラスタ内エンドポイントを与える抽象化。
- Ingress — 外部からの HTTP/HTTPS トラフィックをホスト名やパスに基づいてサービスへ振り分ける入口。
ここでは注文サービスを例に、Deployment と Service を定義します。ASP.NET Core アプリはコンテナ内で 8080 番を公開している前提です。
# order-service.yaml
apiVersion: apps/v1
kind: Deployment
metadata:
  name: order-service
  labels:
    app: order-service
spec:
  replicas: 3
  selector:
    matchLabels:
      app: order-service
  template:
    metadata:
      labels:
        app: order-service
    spec:
      containers:
      - name: order-service
        image: enhancedsharedacr.azurecr.io/order-service:1.4.0
        ports:
        - containerPort: 8080
        env:
        - name: ASPNETCORE_URLS
          value: "http://+:8080"
---
apiVersion: v1
kind: Service
metadata:
  name: order-service
spec:
  selector:
    app: order-service
  ports:
  - port: 80
    targetPort: 8080
  type: ClusterIP
外部公開が必要なサービスは Ingress を重ねます。AKS では Application Gateway Ingress Controller や、マネージドの NGINX アドオンを利用できます。次の例はパスベースで API Gateway サービスへ転送する最小構成です。
# ingress.yaml
apiVersion: networking.k8s.io/v1
kind: Ingress
metadata:
  name: public-api
  annotations:
    kubernetes.io/ingress.class: nginx
spec:
  rules:
  - host: api.example.com
    http:
      paths:
      - path: /
        pathType: Prefix
        backend:
          service:
            name: api-gateway
            port:
              number: 80
サービス間の呼び出しはクラスタ内 DNS で解決できるため、http://order-service のようにサービス名を指定するだけで到達できます。外部にエンドポイントを増やさず内部通信を閉じられる点は、マイクロサービスの境界を守るうえで重要です。
設定とシークレットを分離する
設定値をイメージに埋め込むと、環境ごとにイメージを作り直すことになり、再現性とセキュリティの両面で不利になります。環境依存の値は ConfigMap に、認証情報は Secret に分離し、コンテナ側では環境変数やマウントされたファイルとして受け取ります。
# config.yaml
apiVersion: v1
kind: ConfigMap
metadata:
  name: order-service-config
data:
  Logging__LogLevel__Default: "Information"
  Features__EnableRetryQueue: "true"
---
apiVersion: v1
kind: Secret
metadata:
  name: order-service-secrets
type: Opaque
stringData:
  ConnectionStrings__OrdersDb: "Server=postgres;Database=orders;User Id=app;Password=..."
ASP.NET Core の構成システムは環境変数のダブルアンダースコアを階層区切りとして解釈するため、Logging__LogLevel__Default は Logging:LogLevel:Default と同じ設定にマッピングされます。アプリ側の appsettings.json と自然に統合できるので、コードを変更せずに環境差分を吸収できます。
# deployment の抜粋: ConfigMap と Secret を丸ごと環境変数へ展開
      containers:
      - name: order-service
        image: enhancedsharedacr.azurecr.io/order-service:1.4.0
        envFrom:
        - configMapRef:
            name: order-service-config
        - secretRef:
            name: order-service-secrets
Kubernetes の Secret は既定では base64 でエンコードされるだけで、暗号化されるわけではありません。本番環境では etcd の保存時暗号化を有効にするか、AKS であれば Azure Key Vault を Secrets Store CSI Driver 経由で参照し、機密値をクラスタ外で管理する構成が実務的です。
健全性プローブと自動スケール
Kubernetes は Pod の状態をプローブで判断します。3 種類を役割ごとに使い分けることで、起動が遅いサービスや一時的に応答できないサービスを安全に扱えます。
- Startup プローブ — 起動完了までの猶予を与え、初期化中に他のプローブが誤って失敗と判断するのを防ぐ。
- Readiness プローブ — トラフィックを受け付けられる状態かを判定し、失敗時はサービスの振り分け対象から外す。
- Liveness プローブ — 回復不能な状態を検知し、失敗が続けばコンテナを再起動する。
ASP.NET Core は Health Checks ミドルウェアで /healthz/live と /healthz/ready を分けて公開できます。データベース接続などの依存関係は Readiness 側だけで検査し、Liveness はプロセスの生存確認にとどめるのが定石です。
# probes.yaml(deployment の containers 抜粋)
        startupProbe:
          httpGet:
            path: /healthz/live
            port: 8080
          failureThreshold: 30
          periodSeconds: 5
        readinessProbe:
          httpGet:
            path: /healthz/ready
            port: 8080
          periodSeconds: 10
        livenessProbe:
          httpGet:
            path: /healthz/live
            port: 8080
          periodSeconds: 15
負荷に応じた台数調整は HorizontalPodAutoscaler が担います。CPU 使用率のようなリソース指標を基準にレプリカ数を増減させる構成が基本です。
# hpa.yaml
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: order-service
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: order-service
  minReplicas: 3
  maxReplicas: 20
  metrics:
  - type: Resource
    resource:
      name: cpu
      target:
        type: Utilization
        averageUtilization: 70
一方、キューの滞留量やイベント数のように CPU では表せない負荷には、KEDA を用いたイベント駆動スケールが適しています。KEDA は Azure Service Bus や Kafka などのスケーラーを備え、キューの深さに応じてゼロ台からのスケールアウトも実現できます。次の例は Service Bus のキュー長を基準にスケールさせる ScaledObject です。
# keda-scaledobject.yaml
apiVersion: keda.sh/v1alpha1
kind: ScaledObject
metadata:
  name: order-worker
spec:
  scaleTargetRef:
    name: order-worker
  minReplicaCount: 0
  maxReplicaCount: 30
  triggers:
  - type: azure-servicebus
    metadata:
      queueName: orders
      messageCount: "20"
    authenticationRef:
      name: servicebus-auth
HPA と KEDA は排他ではなく、同期的な API サービスは HPA、バックグラウンドのワーカーは KEDA といった形で使い分けるのが現実的です。
安全なリリースとリソース設計
Deployment を更新すると、既定ではローリング更新によって古い Pod を段階的に新しい Pod へ置き換えます。同時に停止する Pod 数と余分に立ち上げる Pod 数を制御することで、更新中も可用性を保てます。
# rollout.yaml(deployment の spec 抜粋)
spec:
  strategy:
    type: RollingUpdate
    rollingUpdate:
      maxUnavailable: 0
      maxSurge: 1
  minReadySeconds: 15
maxUnavailable: 0 は稼働台数を減らさずに更新することを意味し、Readiness プローブが通った Pod だけが順次トラフィックを受け取ります。問題が起きた場合は直前のリビジョンへ即座に戻せます。
# 更新の進行状況を確認し、問題があれば直前へロールバック
kubectl rollout status deployment/order-service
kubectl rollout undo deployment/order-service
安定したスケジューリングと更新の前提になるのが、リソース要求(requests)と制限(limits)の設定です。requests はスケジューラが配置先ノードを決める基準になり、limits はノードのリソースを一部の Pod が占有するのを防ぎます。とりわけメモリの limit は超過時に Pod が強制終了される直接の原因になるため、実測に基づいて余裕を持たせる必要があります。
# resources.yaml(containers 抜粋)
        resources:
          requests:
            cpu: "250m"
            memory: "256Mi"
          limits:
            cpu: "500m"
            memory: "512Mi"
.NET アプリはコンテナのメモリ制限を認識して GC の挙動を調整しますが、想定より高いメモリ使用が続く場合は limit と DOTNET_GCHeapHardLimit の関係を見直し、実負荷でのプロファイルを取ることが有効です。
サービスメッシュと可観測性
サービス数が増えると、通信の暗号化やリトライ、タイムアウト、トラフィック分割といった横断的な制御をアプリごとに実装する負担が大きくなります。サービスメッシュはこれらをサイドカーやアンビエントなデータプレーンに委譲し、アプリのコードを変えずに一貫したポリシーを適用します。代表的な Istio では、サービス間通信を mTLS で自動的に暗号化し、相互認証を強制できます。
# peer-authentication.yaml: 名前空間内の通信を mTLS 必須にする
apiVersion: security.istio.io/v1
kind: PeerAuthentication
metadata:
  name: default
  namespace: microservices
spec:
  mtls:
    mode: STRICT
カナリアリリースのようなトラフィック制御もメッシュの得意分野です。次の例は、新バージョンへ 10 パーセントだけ流し、残りを安定版に向ける重み付けルーティングです。
# virtual-service.yaml
apiVersion: networking.istio.io/v1
kind: VirtualService
metadata:
  name: order-service
spec:
  hosts:
  - order-service
  http:
  - route:
    - destination:
        host: order-service
        subset: v1
      weight: 90
    - destination:
        host: order-service
        subset: v2
      weight: 10
可観測性は、メトリクス・トレース・ログの 3 本柱で捉えます。2026 年時点では計装の標準として OpenTelemetry が定着し、.NET では OpenTelemetry.Extensions.Hosting などのパッケージでメトリクスと分散トレースをまとめて出力できます。エクスポート先を OTLP に統一しておけば、収集基盤を後から差し替えても計装コードを変えずに済みます。
// Program.cs(抜粋)
builder.Services.AddOpenTelemetry()
    .ConfigureResource(r => r.AddService("order-service"))
    .WithTracing(t => t
        .AddAspNetCoreInstrumentation()
        .AddHttpClientInstrumentation()
        .AddOtlpExporter())
    .WithMetrics(m => m
        .AddAspNetCoreInstrumentation()
        .AddRuntimeInstrumentation()
        .AddOtlpExporter());
メトリクスの保存とアラートには Prometheus を組み合わせるのが一般的です。Prometheus Operator を導入していれば、ServiceMonitor を宣言するだけで対象サービスからの収集が始まります。
# servicemonitor.yaml
apiVersion: monitoring.coreos.com/v1
kind: ServiceMonitor
metadata:
  name: order-service
spec:
  selector:
    matchLabels:
      app: order-service
  endpoints:
  - port: http
    path: /metrics
    interval: 30s
GitOps と AKS 運用の要点
クラスタの構成をコマンド操作で積み上げると、環境間の差分や変更履歴が追いにくくなります。GitOps は、あるべき状態を Git リポジトリで宣言し、それをクラスタへ継続的に同期させる運用モデルです。Argo CD は Git 上のマニフェストと実際のクラスタ状態を常時比較し、差分を検出して自動修復します。
# argocd-application.yaml
apiVersion: argoproj.io/v1alpha1
kind: Application
metadata:
  name: order-service
  namespace: argocd
spec:
  project: default
  source:
    repoURL: https://github.com/enhanced/k8s-config
    targetRevision: main
    path: environments/production/order-service
  destination:
    server: https://kubernetes.default.svc
    namespace: microservices
  syncPolicy:
    automated:
      prune: true
      selfHeal: true
    syncOptions:
    - CreateNamespace=true
この構成では、CI がイメージをビルドして構成リポジトリのタグを更新し、Argo CD がその変更を検知してクラスタへ反映します。人手による kubectl apply を減らし、リリースの記録が Git のコミット履歴として残る点が運用上の利点です。
AKS を前提にする場合、いくつかの固有の要点を押さえておくと安定します。
- ワークロード ID — Pod に Microsoft Entra ID の資格情報を紐付け、接続文字列を持たずに Key Vault やデータベースへアクセスする。
- ノードプールの分離 — システム用とアプリ用のノードプールを分け、必要に応じてスポットインスタンスをコスト最適化に充てる。
- 共有 ACR との連携 — イメージを組織で共有する Azure Container Registry に集約し、AKS からはマネージド ID でプルする。
- マネージドアドオンの活用 — KEDA や Managed Prometheus、Ingress といった機能をアドオンとして有効化し、自前運用の負担を減らす。
これらは個別の設定に見えて、認証情報を持たない運用、コスト最適化、供給網の一元管理という一貫した方針でつながっています。導入初期からこの方針を決めておくと、サービスが増えても運用が破綻しにくくなります。
エンハンスド株式会社では、.NET アプリケーションのクラウドネイティブ移行と Kubernetes 運用の支援を行っています。AKS を前提としたアーキテクチャ設計、GitOps による継続的デリバリの整備、可観測性とスケール戦略の実装まで、現状の構成に合わせて伴走します。マイクロサービス化やコンテナ基盤の見直しを検討されている際は、お気軽にご相談ください。
このテーマの全体像は .NET モダナイゼーション完全ガイド にまとめています。
この記事をシェア
関連記事
AKS(Azure Kubernetes Service)運用ガイド — .NET アプリの本番運用
AKS(Azure Kubernetes Service)は、Kubernetes のコントロールプレーンをマネージドで提供し、ノードやネットワーク、監視、…
増えすぎたマイクロサービスを .NET Aspire で整えた、ある開発チームの記録
「開発環境を立ち上げるだけで、午前中が半分終わる」。最初の相談は、ある B2B SaaS を運営する開発チームからのそんな一言で始まった。顧客の了承を得たうえで、…
.NET によるクラウドネイティブ開発の実践ガイド
クラウドネイティブ開発とは、コンテナ・オーケストレーション・マネージドサービスを前提に、スケールと回復性、継続的デリバリを設計の中心へ据える取り組みを指します。.NET は近年のリリースで、…