.NET アプリケーションのパフォーマンス問題の多くは、CPU よりもメモリ割り当てと GC(ガベージコレクション)に起因する。過剰なオブジェクト割り当ては GC の実行頻度を上げ、スループット低下やレイテンシのスパイクを招く。本記事では、.NET 10 を前提に、GC の基礎、Workstation / Server といった GC モードの選択、コンテナ環境でのメモリ制限、割り当てを減らす具体的な手法、そして計測ツールまでを実践的にまとめる。改善の全体像は.NET パフォーマンス最適化 完全ガイドも参照してほしい。
.NET のメモリと GC の基礎
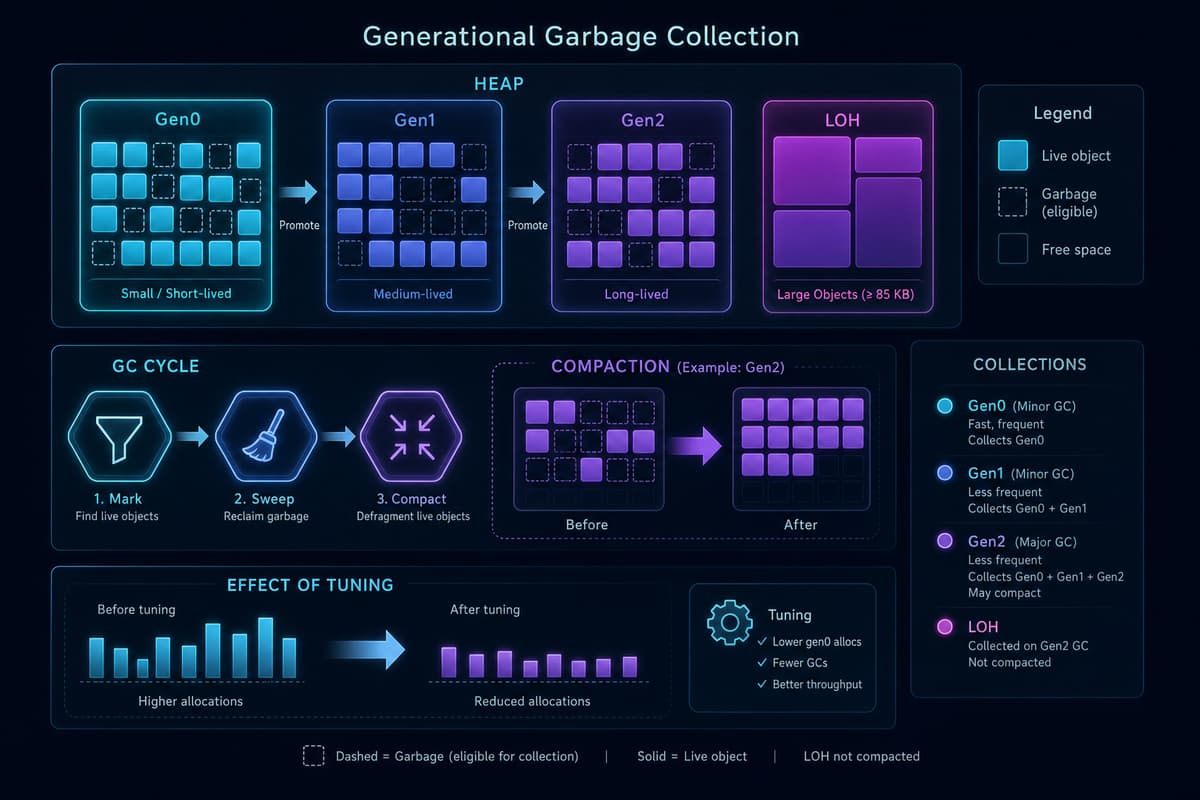
.NET のマネージドヒープは世代別 GC で管理される。新しく割り当てられたオブジェクトは Gen0 に置かれ、GC を生き延びるごとに Gen1、Gen2 へと昇格する。多くのオブジェクトは短命であるという仮説に基づき、頻繁で軽量な Gen0 コレクションと、稀で高コストな Gen2(フル)コレクションを使い分けることで効率を高めている。
ヒープは大きく 2 種類に分かれる。85,000 バイト未満のオブジェクトを格納する SOH(Small Object Heap)と、それ以上の大きなオブジェクトを格納する LOH(Large Object Heap)である。LOH は Gen2 として扱われ、コレクションのコストが高い。さらにデフォルトでは圧縮(コンパクション)されないため、断片化が進むとメモリを無駄に消費しやすい。
重要なのは、GC の負荷は基本的に「割り当ての量」に比例するという点である。割り当てが増えれば Gen0 が早く埋まり、GC の実行回数が増える。加えて短命なつもりのオブジェクトが Gen2 まで昇格すると、フルコレクションのコストが跳ね上がる。したがってチューニングの本質は、まず不要な割り当てそのものを減らすことにある。
GC モードの選択
.NET の GC には大きく Workstation GC と Server GC の 2 モードがある。Workstation GC は単一のヒープと GC スレッドで動作し、メモリフットプリントが小さくレイテンシを抑えやすいため、デスクトップアプリや低負荷なプロセスに向く。Server GC は論理プロセッサごとにヒープと専用の GC スレッドを持ち、複数コアで並列にコレクションを行う。スループットを重視するサーバーアプリケーションでは Server GC を選ぶのが基本である。
さらに Background GC(Server GC ではバックグラウンド、Workstation では並行 = Concurrent GC と呼ばれる)により、Gen2 コレクションの大部分をアプリケーションスレッドと並行して実行し、長い一時停止を減らせる。Background GC は既定で有効である。
Server GC は csproj で有効化するのが最も明示的で確実である。
<PropertyGroup>
  <ServerGarbageCollection>true</ServerGarbageCollection>
  <ConcurrentGarbageCollection>true</ConcurrentGarbageCollection>
</PropertyGroup>
ビルド設定を変えずに切り替えたい場合は環境変数でも指定できる。
export DOTNET_gcServer=1
export DOTNET_gcConcurrent=1
Server GC はコアあたりにヒープを確保するため、コア数が多い環境ではメモリ使用量とスレッド数が増える点に注意する。コンテナで少数の CPU に制限されている場合や、多数の小さなプロセスを同居させる場合は、Workstation GC の方が全体のフットプリントを抑えられることもある。実測して判断するのが望ましい。
コンテナでのメモリ制限
コンテナで .NET を動かす場合、GC がホストの巨大なメモリ量を基準にヒープサイズを決めてしまうと、cgroups で設定したコンテナのメモリ上限を超えて OOM Kill される危険がある。近年のランタイムは cgroups(v1 / v2)のメモリ制限を認識し、それに合わせてヒープの上限を調整するようになっているが、明示的に制御したい場面も多い。
ヒープの絶対的な上限は GCHeapHardLimit(バイト単位、16 進で指定)で、割合での指定は DOTNET_GCHeapHardLimitPercent で行える。例えばコンテナのメモリ上限の 75% をマネージドヒープの上限とする場合は次のようにする。
# コンテナのメモリ制限に対する割合(75%)で上限を設定
export DOTNET_GCHeapHardLimitPercent=75
csproj や runtimeconfig でも設定できる。
<PropertyGroup>
  <ServerGarbageCollection>true</ServerGarbageCollection>
  <!-- コンテナ上限の割合でヒープ上限を制御 -->
  <GCHeapHardLimitPercent>75</GCHeapHardLimitPercent>
</PropertyGroup>
ヒープ上限とコンテナのメモリ制限の間には、スタックやネイティブメモリ、JIT が生成するコード用の余裕を残しておく。上限いっぱいに設定すると、マネージドヒープ以外の領域が圧迫されて不安定になる。まずは 70〜80% 程度から始め、実際のメモリ使用量を計測して調整するとよい。
割り当てを減らす手法
GC 負荷を根本から下げる最も効果的な方法は、割り当て自体を減らすことである。以下の手法を組み合わせる。
Span<T> と Memory<T>
Span<T> と Memory<T> は、配列や文字列の一部を新たなコピーを作らずに参照するための型である。部分文字列の抽出やバッファのスライスで威力を発揮する。詳細はSpan<T> / Memory<T> で書くゼロコピー C#を参照してほしい。
// Substring は新しい文字列を割り当てるが、AsSpan().Slice は割り当てゼロ
ReadOnlySpan<char> line = input.AsSpan();
ReadOnlySpan<char> key = line.Slice(0, line.IndexOf('='));
stackalloc と struct
小さく短命なバッファは stackalloc でスタック上に確保すればヒープ割り当てを避けられる。また、値型(struct)を適切に使うことで小さなデータのヒープ割り当てを減らせる。ただし大きな struct のコピーコストや、後述するボクシングには注意する。
Span<byte> buffer = stackalloc byte[256];
int written = Encoding.UTF8.GetBytes(text, buffer);
ArrayPool<T> と ObjectPool
大きな配列を繰り返し確保・破棄する処理では、ArrayPool<T> でバッファを再利用すると割り当てと GC 圧力を大幅に削減できる。借りたバッファは必ず返却する。オブジェクト単位の再利用には Microsoft.Extensions.ObjectPool の ObjectPool<T> が使える。
byte[] rented = ArrayPool<byte>.Shared.Rent(bufferSize);
try
{
    // rented を作業用バッファとして使用
    ProcessData(rented.AsSpan(0, bufferSize));
}
finally
{
    ArrayPool<byte>.Shared.Return(rented);
}
文字列・LINQ の割り当て回避
文字列連結の繰り返しは中間文字列を大量に生成する。ループ内の連結は StringBuilder に、単純な組み立ては補間文字列ハンドラや string.Create に置き換える。LINQ はイテレータやデリゲート、クロージャの割り当てを伴うため、ホットパスでは for / foreach による明示的なループの方が割り当てを抑えられることが多い。
ボクシングの回避
値型を object やインターフェイス経由で扱うとボクシングが発生し、ヒープ割り当てになる。ジェネリクスを使い、値型を object に暗黙変換しないよう注意する。特にログ出力やコレクションへの格納で意図せぬボクシングが起きやすい。
計測ツールとプロファイリング
チューニングは推測ではなく計測から始める。まず本番に近い環境で GC の挙動と割り当て量を可視化する。
dotnet-counters は稼働中のプロセスの GC ヒープサイズ、Gen0/1/2 コレクション回数、割り当てレートをリアルタイムで観測できる。
dotnet-counters monitor --process-id 1234 --counters System.Runtimeヒープに何が残っているかを調べるには dotnet-gcdump でヒープダンプを取得し、種類ごとのオブジェクト数とサイズを分析する。メモリリークやリテンションの調査に有効である。
dotnet-gcdump collect --process-id 1234コード内から数値を取得したい場合、GC.GetGCMemoryInfo() でヒープサイズ・断片化・ヒープ上限などの詳細情報を、GC.GetTotalAllocatedBytes() でプロセス起動以来の累積割り当てバイト数を取得できる。
long before = GC.GetTotalAllocatedBytes(precise: true);
DoWork();
long allocated = GC.GetTotalAllocatedBytes(precise: true) - before;
Console.WriteLine($"割り当て: {allocated:N0} バイト");

GCMemoryInfo info = GC.GetGCMemoryInfo();
Console.WriteLine($"ヒープサイズ: {info.HeapSizeBytes:N0} / 上限: {info.HighMemoryLoadThresholdBytes:N0}");
特定メソッドの割り当てをベンチマークで定量化するなら BenchmarkDotNet の MemoryDiagnoser が最適である。実行時間に加えて、1 操作あたりの割り当てバイト数と Gen0/1/2 コレクション回数を出力してくれる。
[MemoryDiagnoser]
public class ParserBenchmark
{
    [Benchmark]
    public int ParseWithSpan() => Parser.ParseSpan(Input);
}
.NET 10 での GC / JIT の改善
.NET 10 では GC と JIT の双方が継続的に改善されている。Server GC 向けの DATAS(Dynamically Adapting To Application Sizes)は、アプリケーションの実際のワーキングセットに応じてヒープ数とサイズを動的に調整し、特にコンテナや小規模ワークロードでのメモリフットプリントを抑える。近年のランタイムでは既定で有効になっており、多数のコアを持つ環境で Server GC を使ってもメモリが過剰に膨らみにくい。
JIT 側では TieredPGO(動的プロファイル誘導最適化)が成熟し、実行時のプロファイルに基づいてホットパスをより積極的に最適化する。これにより仮想呼び出しのデバーチャライズやインライン化が進み、間接的に割り当ての削減や実行効率の向上につながる。これらの改善の実測値については.NET 10 の JIT と GC はどれだけ速くなったのかで詳しく扱っている。
まとめ
メモリと GC のチューニングは、順序を守ることが重要である。第一に計測する。dotnet-counters や BenchmarkDotNet の MemoryDiagnoser で、どこでどれだけ割り当てが起きているかを特定する。第二に割り当てを削減する。Span<T>、stackalloc、ArrayPool<T>、文字列・LINQ の見直し、ボクシング回避で GC 負荷そのものを下げる。第三に GC 設定を調整する。サーバーワークロードでは Server GC を基本とし、コンテナではヒープ上限を適切に設定する。この順序を守ることで、当て推量の設定変更に頼らず、確実にパフォーマンスを改善できる。
エンハンスド株式会社では、メモリ・GC を含む .NET アプリのパフォーマンス改善を支援しています。
- レガシーシステム モダナイゼーション - レガシー資産を分析し、最新 .NET への安全な移行を支援
- クラウドネイティブ & 移行 - Azure / AWS でクラウドネイティブな設計と移行を支援
この記事をシェア
関連記事
.NET パフォーマンス最適化 完全ガイド — 起動・スループット・メモリを速くする
.NET アプリの「遅い・重い・立ち上がりが遅い」を解消するための入り口ページです。起動時間、スループット、メモリ、データアクセスといったテーマごとに、…
【2026年版】Entity Framework Core 10 パフォーマンス最適化ガイド
EF Core は書き方ひとつで速くも遅くもなります。同じ機能でも、追跡設定や射影の有無、 往復回数 の設計しだいで体感が何倍も変わるのが実際のところです。…
BenchmarkDotNet で正しくベンチマークを取る実践ガイド
「この書き方のほうが速いはず」という直感は、実測するとしばしば裏切られる。特にマイクロ秒からナノ秒のオーダーで動作するコードは、JIT の最適化やハードウェアの挙動が複雑に絡み合い、…