はじめに
これまでの連載では、Orleans の基本概念からステート管理、Grain 間通信とストリーミング、そしてクラスタリングと高可用性までを扱ってきました。第5回となる今回は、Orleans アプリケーションの性能を引き出すための「パフォーマンスチューニングとトラブルシューティング」を取り上げます。
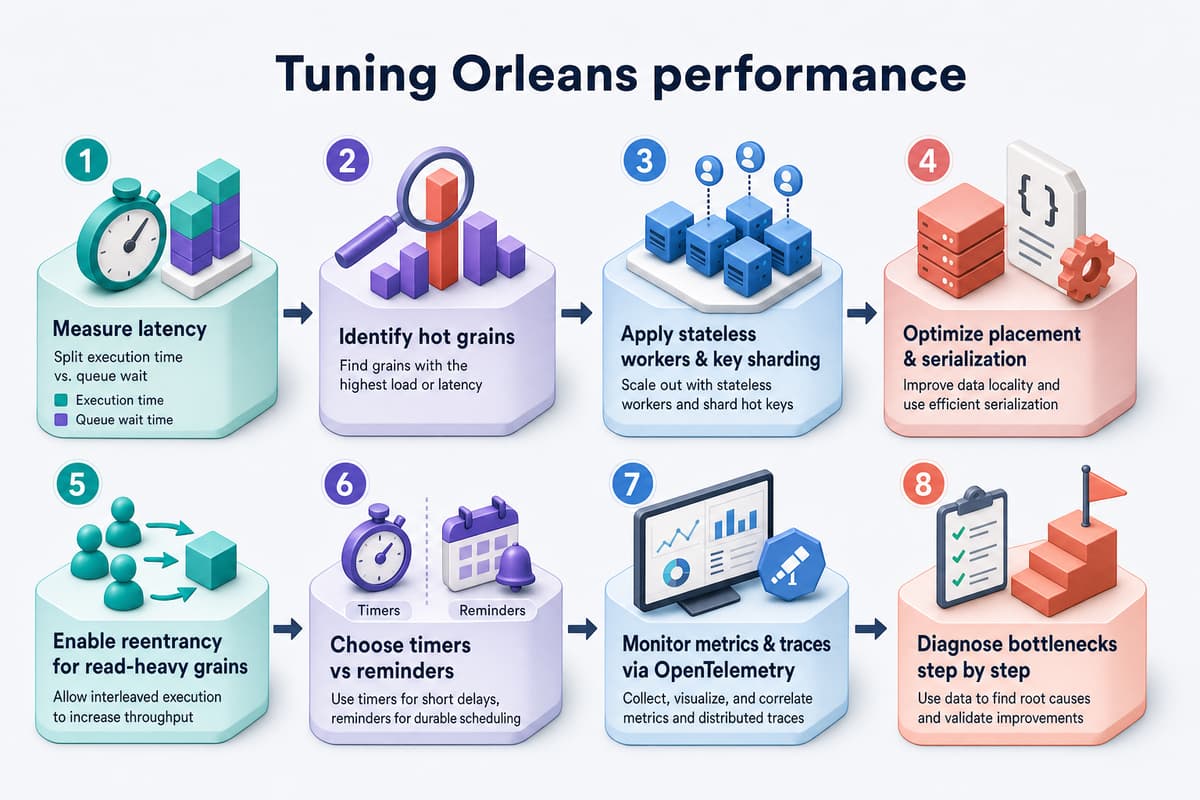
性能改善で最初に押さえておきたいのは、推測ではなく実測で判断するという姿勢です。Orleans は仮想アクターという抽象の上で動くため、どこに時間がかかっているかが直感からずれることが少なくありません。本稿では .NET 10 を前提に、Grain 呼び出しのレイテンシ要因の切り分け、アクティベーションとシリアライズのコスト、ホットグレイン問題への対処、タイマーとリマインダーの使い分け、そして OpenTelemetry を使った監視と診断の手順を順に見ていきます。
グレイン呼び出しのレイテンシを分解する
Grain のメソッド呼び出しは、単なるメソッド呼び出しに見えて、内部ではいくつもの段階を通っています。呼び出し元が別サイロの Grain を呼ぶ場合、引数のシリアライズ、ネットワーク転送、対象 Grain のディレクトリ解決、必要ならアクティベーション、そして Grain 内でのメッセージのキューイングを経て処理が実行されます。遅延の原因を探るときは、この経路のどこで時間が失われているかを分けて考えます。
特に見落としやすいのが、Grain がシングルスレッドで動く点に起因するキューイング遅延です。既定の Grain は一度に一つのリクエストしか処理しないため、ある呼び出しが内部で長い await を挟むと、その間に届いた後続リクエストは待たされます。処理そのものは速くても、行列に並ぶ時間が伸びているというケースは珍しくありません。まずはこの「実行時間」と「待ち時間」を切り分けて測ることが出発点になります。
切り分けには、Grain 呼び出しフィルターで各メソッドの所要時間を計測するのが手軽です。すべての呼び出しを横断的に捕捉できるため、どの Grain のどのメソッドが遅いかを俯瞰できます。
public sealed class TimingCallFilter : IIncomingGrainCallFilter
{
    private static readonly Meter Meter = new("MyApp.Orleans");
    private static readonly Histogram<double> CallDuration =
        Meter.CreateHistogram<double>("grain.call.duration", unit: "ms");

    private readonly ILogger<TimingCallFilter> _logger;

    public TimingCallFilter(ILogger<TimingCallFilter> logger) => _logger = logger;

    public async Task Invoke(IIncomingGrainCallContext context)
    {
        var start = Stopwatch.GetTimestamp();
        try
        {
            await context.Invoke();
        }
        finally
        {
            var elapsedMs = Stopwatch.GetElapsedTime(start).TotalMilliseconds;
            var grainType = context.Grain.GetType().Name;
            var method = context.InterfaceMethod?.Name ?? "unknown";

            CallDuration.Record(elapsedMs,
                new KeyValuePair<string, object?>("grain", grainType),
                new KeyValuePair<string, object?>("method", method));

            // しきい値は自分のワークロードの実測分布から決める
            if (elapsedMs > SlowCallThresholdMs)
            {
                _logger.LogWarning(
                    "Slow grain call {Grain}.{Method}: {Elapsed} ms",
                    grainType, method, elapsedMs);
            }
        }
    }

    private const double SlowCallThresholdMs = 500;
}
フィルターはサイロ構成で登録します。しきい値の 500 という値はあくまで出発点で、実際には自分のワークロードで観測した分布を見て決めます。ここで得られるヒストグラムを、後述する OpenTelemetry でエクスポートすればパーセンタイルの推移を追えます。
builder.UseOrleans(silo =>
{
    silo.AddIncomingGrainCallFilter<TimingCallFilter>();
});
アクティベーションとシリアライズのコスト
Grain は呼び出された時に初めて活性化され、一定時間アイドルが続くと非活性化されます。この活性化のたびに OnActivateAsync が走るため、ここでストアからの大きな読み込みや重い初期化を行うと、最初の呼び出しのレイテンシがそのまま膨らみます。活性化はキャッシュミスと同じ性質を持つと考え、初期化は本当に必要な最小限にとどめるのが基本です。
読み込みが避けられない場合でも、活性化の直後にすべてを取りに行くのではなく、必要になった時点で遅延して読み込む設計にするとレイテンシの山をならせます。あわせて、頻繁にアクセスされる Grain のアイドルタイムアウトを延ばし、活性化と非活性化の往復自体を減らすことも検討します。コレクション間隔は GrainCollectionOptions で調整できます。
silo.Configure<GrainCollectionOptions>(options =>
{
    // 既定のアイドル回収間隔を延ばし、活性化の頻度を下げる
    options.CollectionAge = TimeSpan.FromMinutes(30);

    // 特定の Grain 型だけ個別に設定することもできる
    options.ClassSpecificCollectionAge[typeof(ProductGrain).FullName!] =
        TimeSpan.FromHours(2);
});
もう一つの見落としやすいコストがシリアライズです。サイロをまたぐ呼び出しや永続化のたびに、引数・戻り値・ステートがシリアライズされます。Orleans のシリアライザーは [GenerateSerializer] と [Id] を付けた型に対してコンパイル時にコードを生成し、リフレクションに頼らない高速な経路を使います。DTO には必ずこれらの属性を付け、フィールドの番号を安定させておくことが、性能とローリング更新時の互換性の両面で効きます。
[GenerateSerializer]
public sealed record OrderSummary
{
    [Id(0)] public required Guid OrderId { get; init; }
    [Id(1)] public required decimal Total { get; init; }
    [Id(2)] public required IReadOnlyList<string> ItemSkus { get; init; }
}
大きなオブジェクトを毎回まるごとやり取りしていると、そのシリアライズと転送が地味に効いてきます。戻り値を呼び出し側が本当に必要とする形まで絞る、更新は差分だけを渡す、といった見直しで転送量を下げられます。ここでも、どのくらい効くかは実際のペイロードサイズを測って判断します。
ホットグレインとステートレスワーカー、配置戦略
単一の Grain にアクセスが集中する状態をホットグレインと呼びます。Grain はシングルスレッドで直列に処理するため、一つの Grain に負荷が集まると、そこがクラスター全体のスループットの上限になってしまいます。カウンターや集計のように「みんなが同じキーの Grain を叩く」設計は、この問題を招きやすい典型です。
状態を持たない、あるいは共有可能な読み取り中心の処理であれば、ステートレスワーカーが有効な選択肢になります。[StatelessWorker] を付けた Grain は、呼び出し元と同じサイロ上に必要な数だけ並行してアクティベーションが作られ、負荷に応じて自動でスケールします。キーによる一意性の保証はなくなるため、あくまで状態を共有しない処理に使います。
// 入力の検証や整形のような、状態を持たない処理に向く
[StatelessWorker(maxLocalWorkers: 8)]
public sealed class ValidationGrain : Grain, IValidationGrain
{
    public Task<ValidationResult> ValidateAsync(OrderRequest request)
    {
        // 共有状態を持たないため、ローカルで並行に処理できる
        var result = OrderValidator.Validate(request);
        return Task.FromResult(result);
    }
}
状態を持つカウンターのような処理でホットグレインを避けたい場合は、キーを分散させて負荷を割る方法が定石です。書き込みを複数のシャード Grain に振り分け、読み取り時に合算します。集計の即時性と負荷分散はトレードオフになるため、要件に合わせてシャード数を決めます。
配置戦略も、負荷の偏りを抑えるうえで押さえておきたいポイントです。第4回でも触れたとおり、迷ったら各サイロの負荷を見て配置先を選ぶ [ResourceOptimizedPlacement] を基本にします。呼び出し元と同じサイロに置いて通信ホップを減らしたいなら [PreferLocalPlacement]、キーで配置先を固定したいなら [HashBasedPlacement] を使い分けます。
リエントラントも性能に直結します。既定の Grain は一度に一つのリクエストしか処理しませんが、[Reentrant] を付けると、await で待っている間に同じ Grain の別のリクエストをインターリーブして処理できるようになります。読み取りが中心で内部状態の整合性を壊さない Grain では、これによってキューイング遅延を大きく減らせます。ただし、あるメソッドの await をまたいで別のメソッドが状態を書き換え得るため、共有状態の一貫性が保てる場合に限って使います。
[Reentrant]
public sealed class CatalogGrain : Grain, ICatalogGrain
{
    private CatalogSnapshot _snapshot = CatalogSnapshot.Empty;

    // 読み取り中心なので、await 中に他の読み取りを差し込んでも安全
    public async Task<ProductInfo?> GetProductAsync(string sku)
    {
        if (_snapshot.IsStale)
        {
            _snapshot = await LoadSnapshotAsync();
        }
        return _snapshot.Find(sku);
    }
}
タイマーとリマインダー、そして監視と診断
Grain 内で定期処理を回す手段には、タイマーとリマインダーの二つがあります。両者は似て見えて性質が異なるため、用途で選び分けます。タイマー(RegisterGrainTimer)はアクティベーションに紐づく軽量な仕組みで、Grain が非活性化されると止まります。永続化されないため、短命で、失われても構わない周期処理に向きます。
一方リマインダーは、ストアに永続化される持続的なスケジュールです。Grain が非活性化されていても、時刻が来ると Orleans が Grain を活性化して呼び出します。分単位以上の間隔で、確実に実行されてほしい処理に使います。細かい間隔の高頻度な処理をリマインダーで回すとストアへの負荷になるため、そこはタイマーの領分と考えます。
public sealed class BillingGrain : Grain, IBillingGrain, IRemindable
{
    public override Task OnActivateAsync(CancellationToken ct)
    {
        // 軽量な周期処理。非活性化で消えてよいものはタイマー
        this.RegisterGrainTimer(
            () => FlushBufferAsync(),
            new GrainTimerCreationOptions(
                TimeSpan.FromSeconds(10), TimeSpan.FromSeconds(10)));

        return base.OnActivateAsync(ct);
    }

    public async Task ScheduleMonthlyInvoiceAsync()
    {
        // 確実に実行したい長周期の処理は永続リマインダー
        await this.RegisterOrUpdateReminder(
            "monthly-invoice",
            dueTime: TimeSpan.FromDays(1),
            period: TimeSpan.FromDays(30));
    }

    public Task ReceiveReminder(string reminderName, TickStatus status)
    {
        return reminderName == "monthly-invoice"
            ? IssueInvoiceAsync()
            : Task.CompletedTask;
    }
}
性能を継続的に見張るには、標準化された可観測性の仕組みに乗せるのが近道です。Orleans は Microsoft.Orleans.* の Meter と ActivitySource を通じてメトリクスとトレースを公開しているため、OpenTelemetry でそのまま収集できます。前掲の呼び出しフィルターで作った独自メトリクスも同じ経路でエクスポートされます。
builder.Services.AddOpenTelemetry()
    .WithMetrics(metrics => metrics
        .AddMeter("Microsoft.Orleans")
        .AddMeter("MyApp.Orleans")           // 独自の Meter
        .AddRuntimeInstrumentation()          // GC やスレッドプールの状況
        .AddOtlpExporter())
    .WithTracing(tracing => tracing
        .AddSource("Microsoft.Orleans.Runtime")
        .AddSource("Microsoft.Orleans.Application")
        .AddOtlpExporter());
収集したメトリクスは、Grafana などのダッシュボードでパーセンタイル遅延、アクティベーション数、キューの深さ、GC のコレクション回数といった指標を並べて眺められるようにしておきます。開発中の手元確認には Orleans Dashboard も便利で、Grain 種別ごとの呼び出し回数や例外率をブラウザから素早く把握できます。
不具合の診断は、思い込みで手を入れる前に、順を追って範囲を狭めていくのが結局は近道です。おおまかには次の流れで進めます。
- 症状の特定 — レイテンシの悪化か、スループットの頭打ちか、エラー率の上昇かを、まずメトリクスで区別する
- 範囲の絞り込み — 全 Grain か特定の Grain 型か、全サイロか一部サイロかをダッシュボードで切り分ける
- キューイングの確認 — 該当 Grain の実行時間と待ち時間を分けて見て、ホットグレインやリエントラント不足を疑う
- リソースの確認 — GC の頻度やスレッドプールの飽和、外部ストアの応答時間など、Grain の外側の要因を確認する
- 仮説の検証 — 一度に一つだけ変更し、同じ指標で改善を測ってから次へ進む
この過程で捏造した目標値を追わないことが大切です。改善したかどうかは、変更の前後で同じ指標を測り比べて判断します。
まとめ
Orleans のパフォーマンスチューニングは、仮想アクターの内部でどこに時間がかかっているかを実測で切り分けることから始まります。最後に、本稿の勘所を整理します。
- レイテンシの分解 — 実行時間と待ち時間を分けて測り、キューイング遅延を見逃さない
- 活性化とシリアライズ — 初期化は最小限にし、DTO には
[GenerateSerializer]を付けて転送量を抑える - ホットグレイン — ステートレスワーカー、キーの分散、配置戦略、リエントラントで集中を解く
- 周期処理 — 消えてよい高頻度な処理はタイマー、確実に実行したい長周期はリマインダー
- 可観測性 — OpenTelemetry でメトリクスとトレースを集め、一度に一つずつ変更して効果を測る
エンハンスド株式会社では、Orleans を使った分散システムの性能設計から、ボトルネックの診断、可観測性基盤の構築、本番環境でのチューニングまでを支援しています。
- レガシーシステム モダナイゼーション - レガシー資産を分析し、最新 .NET への安全な移行を支援
- クラウドネイティブ & 移行 - Azure / AWS でクラウドネイティブな設計と移行を支援
- モダンWeb開発支援 & 内製化 - C# と Next.js / Blazor でモダンな開発と内製化を支援
次回の第6回では、実際のプロダクション事例を通じて、Orleans を使った大規模リアルタイムシステムの設計と実装を解説します。
このテーマの全体像は .NET モダナイゼーション完全ガイド にまとめています。
この記事をシェア
関連記事
.NET Aspireで実現するクラウドネイティブ開発の実践ガイド
複数のサービスとデータストアが連携する分散アプリケーションでは、ローカル開発環境の構築、サービス間の接続設定、可観測性の確保といった周辺作業が開発全体の負担になりがちです。.NET Aspire は、…
.NET によるクラウドネイティブ開発の実践ガイド
クラウドネイティブ開発とは、コンテナ・オーケストレーション・マネージドサービスを前提に、スケールと回復性、継続的デリバリを設計の中心へ据える取り組みを指します。.NET は近年のリリースで、…
【.NET Aspire入門】第4回 可観測性とモニタリング
分散システムでは、単一のプロセスを追いかけるだけでは何が起きているのかを把握できません。リクエストが複数のサービスをまたいで流れるため、遅延や障害の原因を突き止めるには、…