はじめに
分散システムでは、単一のプロセスを追いかけるだけでは何が起きているのかを把握できません。リクエストが複数のサービスをまたいで流れるため、遅延や障害の原因を突き止めるには、システム全体を横断して観察できる仕組みが求められます。この「外から内部状態を推測できる度合い」が可観測性(Observability)であり、本番運用の品質を左右する土台になります。
連載第3回では、メッセージングとイベント駆動アーキテクチャによる疎結合な通信を扱いました。第4回となる今回は、.NET 10 で正式版となった .NET Aspire を前提に、OpenTelemetry を軸とした可観測性の実装を解説します。ServiceDefaults による自動計装から、開発時のダッシュボード、本番環境へのエクスポート、分散トレースの相関、カスタムメトリクスとアラートまでを順に見ていきます。
可観測性の三本柱と Aspire の位置づけ
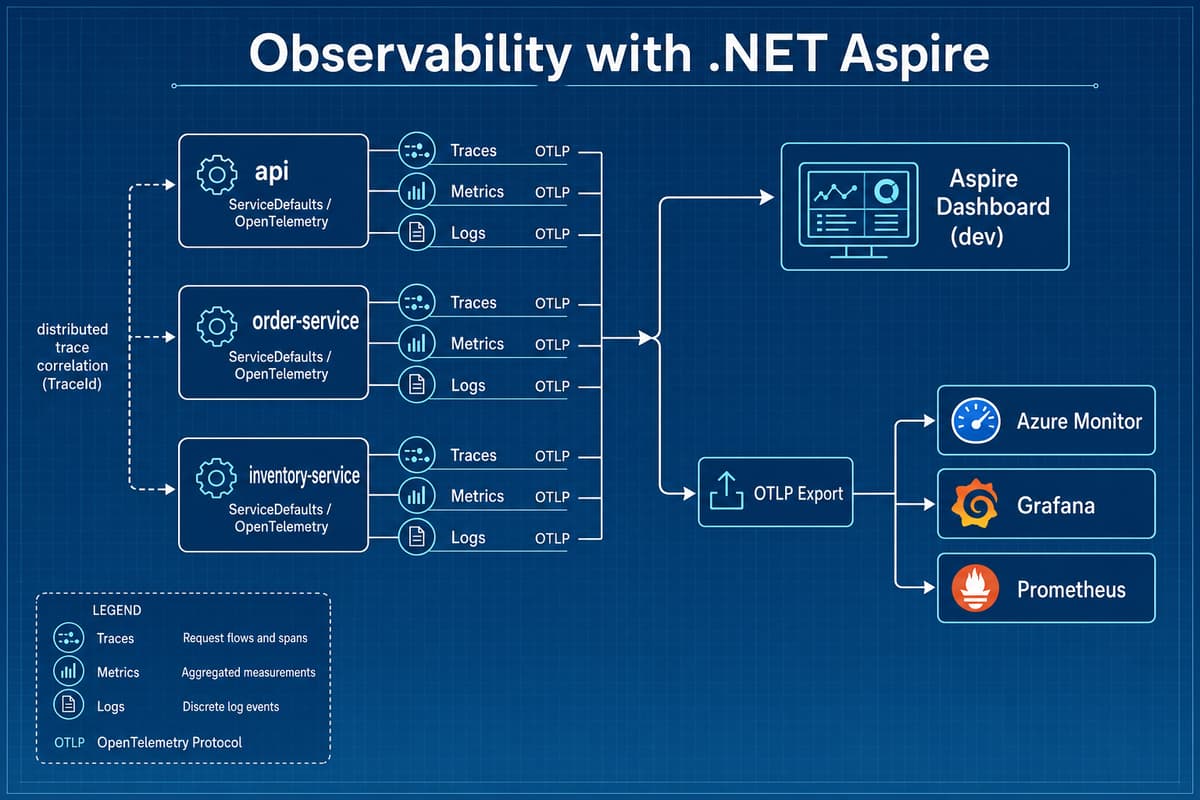
可観測性は、トレース、メトリクス、ログという三種類のテレメトリで構成されます。それぞれが担う役割は異なります。
- トレース — 一つのリクエストが複数サービスをどう通過したかを、親子関係を持つスパンの連なりとして記録します。どこで時間を消費しているかを可視化する用途に向きます。
- メトリクス — リクエスト数やレイテンシ、エラー率といった数値を時系列で集約します。傾向の把握とアラートの発報に使います。
- ログ — 個々のイベントを文脈付きで記録します。特定の事象を掘り下げて調べる際の一次情報になります。
.NET Aspire は、この三本柱を OpenTelemetry の標準仕様に沿って最初から統合しています。OpenTelemetry はベンダー中立の計装フレームワークであり、収集したテレメトリを OTLP(OpenTelemetry Protocol)という共通の形式で任意のバックエンドへ送れます。つまり計装コードを書き換えることなく、送信先だけを Azure Monitor や Grafana に切り替えられるという設計です。この中立性が、特定の監視製品に縛られない運用を可能にします。
ServiceDefaults による自動計装
Aspire プロジェクトを作成すると、ソリューションに ServiceDefaults というプロジェクトが追加されます。ここに各サービス共通の横断的な設定がまとまっており、可観測性の計装もその一部として提供されます。各サービスは AddServiceDefaults を呼ぶだけで、ASP.NET Core、HttpClient、ランタイムの計装が一括で有効になります。
// ServiceDefaults/Extensions.cs
public static IHostApplicationBuilder AddServiceDefaults(this IHostApplicationBuilder builder)
{
    builder.ConfigureOpenTelemetry();
    builder.AddDefaultHealthChecks();
    builder.Services.AddServiceDiscovery();
    return builder;
}

public static IHostApplicationBuilder ConfigureOpenTelemetry(this IHostApplicationBuilder builder)
{
    builder.Logging.AddOpenTelemetry(logging =>
    {
        logging.IncludeFormattedMessage = true;
        logging.IncludeScopes = true;
    });

    builder.Services.AddOpenTelemetry()
        .WithMetrics(metrics =>
        {
            metrics.AddAspNetCoreInstrumentation()
                .AddHttpClientInstrumentation()
                .AddRuntimeInstrumentation();
        })
        .WithTracing(tracing =>
        {
            tracing.AddSource(builder.Environment.ApplicationName)
                .AddAspNetCoreInstrumentation(o => o.Filter = ctx =>
                    !ctx.Request.Path.StartsWithSegments("/health"))
                .AddHttpClientInstrumentation();
        });

    builder.AddOpenTelemetryExporters();
    return builder;
}
実際のエクスポート設定は、環境変数 OTEL_EXPORTER_OTLP_ENDPOINT の有無で切り替わります。この環境変数は AppHost が自動的に注入するため、開発者が各サービスに接続先を書き込む必要はありません。
private static IHostApplicationBuilder AddOpenTelemetryExporters(this IHostApplicationBuilder builder)
{
    var useOtlp = !string.IsNullOrWhiteSpace(
        builder.Configuration["OTEL_EXPORTER_OTLP_ENDPOINT"]);

    if (useOtlp)
    {
        // OTLP エンドポイントが設定されていれば、トレース・メトリクス・ログを送信
        builder.Services.AddOpenTelemetry().UseOtlpExporter();
    }

    return builder;
}
AppHost 側では、各サービスを登録するだけで OTLP の宛先が配線されます。ヘルスチェックのエンドポイントをトレースから除外している点は、ノイズを抑えるうえで実務的に重要です。
// AppHost/AppHost.cs
var builder = DistributedApplication.CreateBuilder(args);

var api = builder.AddProject<Projects.Api>("api");
var orders = builder.AddProject<Projects.OrderService>("order-service")
    .WithReference(api);

builder.Build().Run();
開発時の Aspire ダッシュボード
AppHost を起動すると、Aspire ダッシュボードが自動的に立ち上がります。これは OTLP を受信するテレメトリのビューアを内蔵しており、追加の設定なしにトレース、メトリクス、構造化ログをその場で確認できます。開発中に Jaeger や Prometheus をローカルへ導入する手間が不要になり、コードを実行しながら分散トレースのウォーターフォールを追える点が大きな利点です。
ダッシュボードのトレース画面では、一つのリクエストが api から order-service、さらにデータベースへと伝播していく様子がスパンの階層として表示されます。各スパンにはレイテンシとタグが付与されるため、どの区間で時間を消費しているかを視覚的に把握できます。構造化ログの画面ではトレース ID による絞り込みができ、特定のリクエストに紐づくログだけを抜き出して調べられます。
ダッシュボードはあくまで開発時のツールであり、テレメトリはメモリ上に保持されます。プロセスを再起動すると履歴は消えるため、本番の監視には後述するエクスポート先を別途用意します。
カスタムメトリクスとトレースの相関
自動計装は技術的な指標を広くカバーしますが、注文件数や決済失敗率といったビジネス上の指標は自分で定義します。.NET では System.Diagnostics.Metrics の Meter を使い、IMeterFactory 経由で計器を生成します。
// Metrics/OrderMetrics.cs
public class OrderMetrics
{
    private readonly Counter<long> _ordersCreated;
    private readonly Histogram<double> _processingDuration;
    private readonly UpDownCounter<int> _activeOrders;

    public OrderMetrics(IMeterFactory meterFactory)
    {
        var meter = meterFactory.Create("OrderService");

        _ordersCreated = meter.CreateCounter<long>(
            "orders.created", unit: "{order}",
            description: "作成された注文の累計数");
        _processingDuration = meter.CreateHistogram<double>(
            "orders.processing.duration", unit: "ms",
            description: "注文処理にかかった時間");
        _activeOrders = meter.CreateUpDownCounter<int>(
            "orders.active", unit: "{order}",
            description: "処理中の注文数");
    }

    public void OrderCreated(string customerType) =>
        _ordersCreated.Add(1, new KeyValuePair<string, object?>("customer.type", customerType));

    public void RecordDuration(double ms, string orderType) =>
        _processingDuration.Record(ms, new KeyValuePair<string, object?>("order.type", orderType));

    public void ActiveDelta(int delta) => _activeOrders.Add(delta);
}
この Meter を OpenTelemetry に拾わせるには、ServiceDefaults のメトリクス設定に AddMeter("OrderService") を加えます。あとは計器を呼び出すだけで、宣言した名前とタグ付きの値がバックエンドに流れます。
可観測性の価値を大きく高めるのが、三本柱どうしの相関です。OpenTelemetry のログには自動的に現在のトレース ID とスパン ID が付与されるため、メトリクスの異常を起点に該当時間帯のトレースへ辿り、そこからスパンに紐づくログまで一気に降りていけます。独自の相関情報を全スパンへ伝播させたい場合は、Baggage を利用します。
// Middleware/CorrelationMiddleware.cs
public async Task InvokeAsync(HttpContext context)
{
    var correlationId = context.Request.Headers["X-Correlation-Id"].FirstOrDefault()
        ?? Guid.NewGuid().ToString();

    // Baggage に載せた値は下流サービスのスパンへ自動伝播する
    Baggage.SetBaggage("correlation.id", correlationId);
    Activity.Current?.SetTag("correlation.id", correlationId);
    context.Response.Headers["X-Correlation-Id"] = correlationId;

    await _next(context);
}
ビジネス処理に独自のスパンを追加したい場合は、ActivitySource を定義して StartActivity で明示的にスパンを開きます。このとき使う名前を ServiceDefaults の AddSource に登録しておけば、自動計装のスパンと同じトレースに組み込まれます。
本番環境へのエクスポートとアラート
本番では、OTLP の送信先を実運用の監視基盤へ向けます。計装コードは変えずに、環境変数で宛先を切り替えるのが基本方針です。Azure 上で運用する場合、最も統合が容易なのは Azure Monitor(Application Insights)で、専用のディストリビューションを追加すると OTLP 相当のテレメトリがそのまま送信されます。
// Application Insights へ送る場合
builder.Services.AddOpenTelemetry().UseAzureMonitor();

// あるいは OTLP のまま Collector や Grafana / Prometheus へ送る場合
builder.Services.AddOpenTelemetry().UseOtlpExporter();
Grafana や Prometheus を使う構成では、各サービスは OpenTelemetry Collector へ OTLP で送り、Collector がメトリクスを Prometheus 形式で公開し、トレースを Tempo などへ振り分けます。可視化は Grafana が担います。この構成の利点は、送信先の切り替えや複数バックエンドへの分岐を Collector の設定だけで完結できる点にあります。宛先は Aspire の AppHost から環境変数として与えます。
// AppHost.cs — OTLP エンドポイントを環境変数で注入
var orders = builder.AddProject<Projects.OrderService>("order-service")
    .WithEnvironment("OTEL_EXPORTER_OTLP_ENDPOINT", "http://otel-collector:4317");
監視は、指標を集めるだけでは完結しません。異常を検知して通知する仕組みがあって初めて、障害への早期対応が可能になります。Prometheus を使う場合は、収集したメトリクスに対してアラートルールを定義します。次の例は、エラー率が5%を5分間超えた場合に警告を発報します。
# prometheus/alerts.yml
groups:
  - name: order-service
    rules:
      - alert: HighErrorRate
        expr: |
          sum(rate(http_server_request_duration_seconds_count{http_response_status_code=~"5.."}[5m]))
          / sum(rate(http_server_request_duration_seconds_count[5m])) > 0.05
        for: 5m
        labels:
          severity: critical
        annotations:
          summary: "エラー率が閾値を超過しています"
          description: "5xx の比率が5分間にわたり5%を上回っています"
Azure Monitor を使う場合は、同等の条件をメトリクスアラートやログクエリアラートとして定義し、アクショングループ経由でメールや Teams、オンコールツールへ通知します。閾値は、平常時の実測値を観察したうえで、誤検知と見逃しのバランスを取りながら調整していくのが現実的です。トレースとメトリクスの相関が効いていれば、アラートを受け取った担当者はそのまま該当リクエストのトレースまで辿れるため、初動の調査時間を短縮できます。
まとめ
今回は、.NET Aspire における可観測性とモニタリングを扱いました。要点は、OpenTelemetry を土台に ServiceDefaults で自動計装を効かせ、開発時は Aspire ダッシュボード、本番は OTLP 経由で Azure Monitor や Grafana へエクスポートするという流れです。カスタムメトリクスでビジネス指標を捉え、トレースとログを相関させ、アラートで異常を通知するところまでを一貫した設計として組み立てれば、分散システムの状態を確度高く把握できます。まずは既存サービスに AddServiceDefaults を通し、ダッシュボードでトレースを眺めるところから始めるのが取り組みやすい入口です。
エンハンスド株式会社では、.NET Aspire を用いたクラウドネイティブ開発と、可観測性を前提とした運用設計を、アーキテクチャ検討から本番監視の構築まで一貫して支援しています。既存システムへの OpenTelemetry 導入や、Azure Monitor・Grafana を組み合わせた監視基盤の整備を具体化したい方は、お気軽にお問い合わせください。
次回の第5回では、本番環境へのデプロイメントとスケーリングを取り上げ、Azure Container Apps へのデプロイと自動スケーリングの実装を解説します。
このテーマの全体像は .NET モダナイゼーション完全ガイド にまとめています。
本連載「.NET Aspire 入門」全6回
- 第1回 クラウドネイティブ開発の全体像とセットアップ
- 第2回 データベースとキャッシュの統合
- 第3回 メッセージングとイベント駆動アーキテクチャ
- 第4回 可観測性とモニタリング(本記事)
- 第5回 デプロイメントとスケーリング
- 第6回 本番運用のベストプラクティス
実務目線の総論は .NET Aspire で実現するクラウドネイティブ開発の実践ガイド もあわせてご覧ください。
この記事をシェア
関連記事
.NET Aspireで実現するクラウドネイティブ開発の実践ガイド
複数のサービスとデータストアが連携する分散アプリケーションでは、ローカル開発環境の構築、サービス間の接続設定、可観測性の確保といった周辺作業が開発全体の負担になりがちです。.NET Aspire は、…
増えすぎたマイクロサービスを .NET Aspire で整えた、ある開発チームの記録
「開発環境を立ち上げるだけで、午前中が半分終わる」。最初の相談は、ある B2B SaaS を運営する開発チームからのそんな一言で始まった。顧客の了承を得たうえで、…
.NET によるクラウドネイティブ開発の実践ガイド
クラウドネイティブ開発とは、コンテナ・オーケストレーション・マネージドサービスを前提に、スケールと回復性、継続的デリバリを設計の中心へ据える取り組みを指します。.NET は近年のリリースで、…