はじめに
第2回では、SQL Server や PostgreSQL、Redis といったデータストアを .NET Aspire の AppHost に登録し、接続文字列の注入と可観測性の配線までを一括で扱う方法を確認しました。第3回となる今回は、サービス間を同期呼び出しではなくメッセージでつなぐ、非同期・イベント駆動のアーキテクチャを取り上げます。
複数のサービスが HTTP で直接呼び合う構成は、素直で分かりやすい一方、呼び出し先が一時的に落ちているとその影響が呼び出し元まで波及します。メッセージングを挟むと、送信側はブローカーにメッセージを渡した時点で処理を続けられ、受信側は自分のペースで消費できます。この疎結合が、耐障害性とスケーラビリティの土台になります。
本稿では .NET 10 と GA 済みの Aspire を前提に、RabbitMQ・Azure Service Bus・Apache Kafka の各インテグレーションを AppHost に登録する方法、プロデューサとコンシューマの実装、pub/sub とキューの使い分け、リトライとデッドレターによる信頼性の確保、そして可観測性との連携までを順に見ていきます。
メッセージングを AppHost に登録する
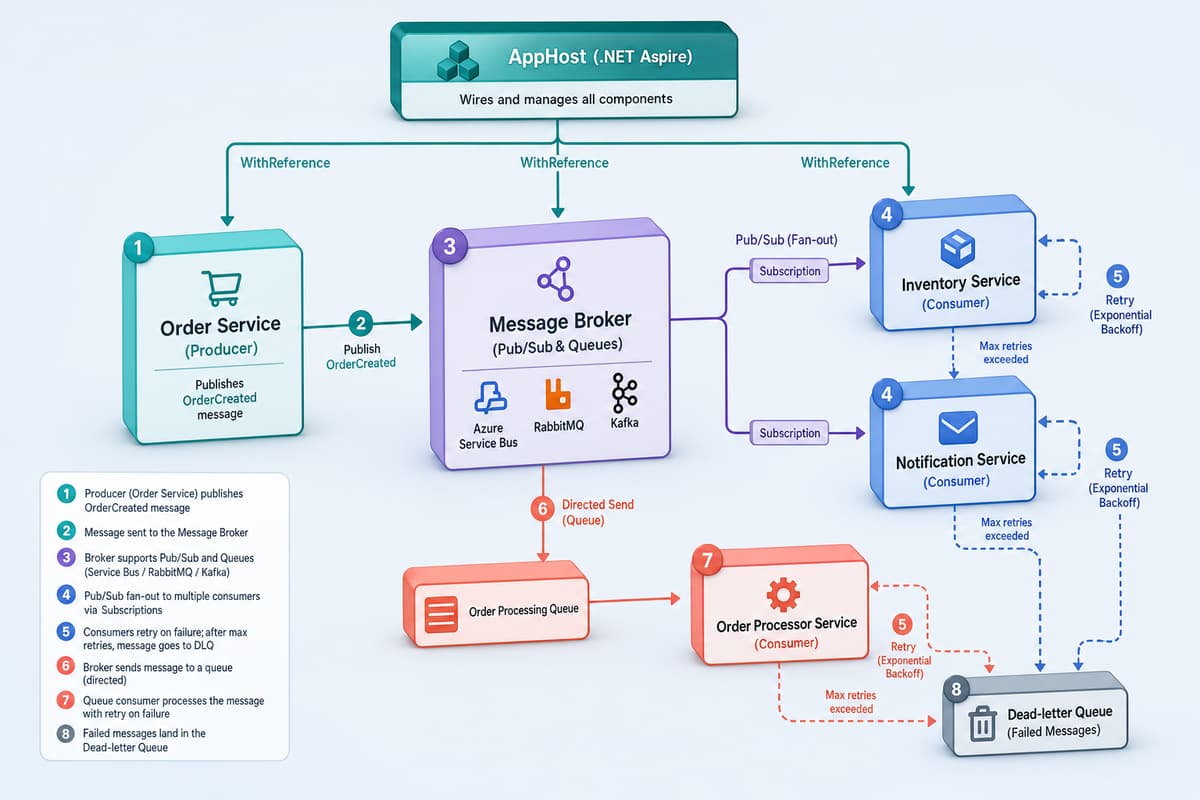
Aspire のメッセージング統合も、データベースと同じくホスト側(AppHost)とクライアント側(各サービス)の二段構えで考えると整理しやすくなります。AppHost では、どのブローカーを起動し、どのサービスがそれを参照するかを宣言します。まずは RabbitMQ の例を示します。WithManagementPlugin を付けておくと、開発中にキューやメッセージの状態を管理 UI から確認できます。
// AppHost/AppHost.cs
var builder = DistributedApplication.CreateBuilder(args);

// RabbitMQ コンテナを起動し、データを永続化する
var messaging = builder.AddRabbitMQ("messaging")
    .WithDataVolume("rabbitmq-data")
    .WithManagementPlugin(); // 開発用の管理 UI

// 注文を発行する側と、在庫・通知を受け取る側に同じブローカーを参照させる
builder.AddProject<Projects.OrderService>("order-service")
    .WithReference(messaging)
    .WaitFor(messaging);

builder.AddProject<Projects.InventoryService>("inventory-service")
    .WithReference(messaging)
    .WaitFor(messaging);

builder.AddProject<Projects.NotificationService>("notification-service")
    .WithReference(messaging)
    .WaitFor(messaging);

builder.Build().Run();
要となるのが WithReference で、これを呼ぶと Aspire は該当サービスへ messaging の接続文字列を環境変数として自動注入します。接続情報を各サービスの設定ファイルに手書きする必要はありません。WaitFor は、ブローカーが起動を終えるまでサービスの開始を待たせる指定で、起動直後にメッセージを送受信する構成で効いてきます。
クラウドのマネージドサービスに寄せたい場合は Azure Service Bus を使います。呼び出すメソッドが変わるだけで、AppHost の構造は同じです。ローカル開発時にはエミュレーターを起動し、本番では実際の名前空間へ接続する、といった切り替えも AppHost 側で表現できます。
// AppHost/AppHost.cs(Azure Service Bus を使う場合)
var serviceBus = builder.AddAzureServiceBus("messaging");

// ローカル開発ではエミュレーターで動かす
if (builder.ExecutionContext.IsRunMode)
{
    serviceBus.RunAsEmulator();
}

// トピックとサブスクリプションを宣言的に定義する
serviceBus.AddServiceBusTopic("order-events")
    .AddServiceBusSubscription("inventory");
イベントストリーミングを主体にするなら Apache Kafka を選びます。Kafka は、消費済みのメッセージをすぐ破棄するのではなく、一定期間ログとして保持し、複数のコンシューマグループがそれぞれのオフセットで読み進められる点が特徴です。イベントの再処理や、後から追加した分析用サービスへの供給に向いています。
// AppHost/AppHost.cs(Apache Kafka を使う場合)
var kafka = builder.AddKafka("kafka")
    .WithDataVolume("kafka-data")
    .WithKafkaUI(); // 開発用の管理 UI

builder.AddProject<Projects.EventStore>("event-store")
    .WithReference(kafka)
    .WaitFor(kafka);

builder.AddProject<Projects.Analytics>("analytics")
    .WithReference(kafka)
    .WaitFor(kafka);
プロデューサとコンシューマを実装する
クライアント側では、Aspire のクライアントインテグレーションを使って接続を登録します。RabbitMQ の場合、生のクライアントを直接扱うこともできますが、実務では MassTransit のようなメッセージングフレームワークと組み合わせると、シリアライズやエンドポイントの構成、リトライといった定型処理を任せられます。ここでは注文サービスをプロデューサとして実装します。
// OrderService/Program.cs
var builder = WebApplication.CreateBuilder(args);

builder.AddServiceDefaults();
builder.AddRabbitMQClient("messaging"); // Aspire が接続文字列を解決する

builder.Services.AddMassTransit(x =>
{
    x.SetKebabCaseEndpointNameFormatter();

    x.UsingRabbitMq((context, cfg) =>
    {
        var connectionString = builder.Configuration
            .GetConnectionString("messaging");
        cfg.Host(new Uri(connectionString!));
        cfg.ConfigureEndpoints(context);
    });
});

var app = builder.Build();
app.MapDefaultEndpoints();

// 注文を受け付け、イベントを発行する
app.MapPost("/api/orders", async (
    CreateOrderRequest request,
    IPublishEndpoint publishEndpoint) =>
{
    var orderId = Guid.NewGuid();

    await publishEndpoint.Publish(new OrderCreated
    {
        OrderId = orderId,
        CustomerId = request.CustomerId,
        TotalAmount = request.Items.Sum(i => i.Quantity * i.Price),
        CreatedAt = DateTime.UtcNow
    });

    return Results.Created($"/api/orders/{orderId}", new { orderId });
});

app.Run();

// イベントは送受信で共有するライブラリに置くのが望ましい
public record OrderCreated
{
    public Guid OrderId { get; init; }
    public Guid CustomerId { get; init; }
    public decimal TotalAmount { get; init; }
    public DateTime CreatedAt { get; init; }
}
IPublishEndpoint.Publish は pub/sub の発行にあたります。イベントを発行した時点で、それを購読しているすべてのコンシューマに配送されます。注文の作成を在庫サービスと通知サービスの両方が受け取りたい、といった一対多の関係に向いています。特定のサービスだけに処理を依頼したい場合は、ISendEndpointProvider を使って宛先を指定するキュー送信を選びます。
受信側は IConsumer<T> を実装します。在庫サービスで OrderCreated を受け取り、在庫を引き当てたうえで、その結果を次のイベントとして発行する流れを示します。コンシューマの中でさらにイベントを発行することで、サービス同士が連鎖的に反応するイベント駆動の連携が組み上がります。
// InventoryService/Consumers/OrderCreatedConsumer.cs
public class OrderCreatedConsumer(
    IInventoryRepository inventory,
    ILogger<OrderCreatedConsumer> logger)
    : IConsumer<OrderCreated>
{
    public async Task Consume(ConsumeContext<OrderCreated> context)
    {
        var message = context.Message;
        logger.LogInformation("Reserving stock for order {OrderId}",
            message.OrderId);

        var reserved = await inventory.TryReserveAsync(message.OrderId);

        if (reserved)
        {
            await context.Publish(new InventoryReserved
            {
                OrderId = message.OrderId,
                ReservedAt = DateTime.UtcNow
            });
        }
        else
        {
            await context.Publish(new InventoryReservationFailed
            {
                OrderId = message.OrderId,
                Reason = "Insufficient stock"
            });
        }
    }
}
コンシューマは AppHost の登録とは別に、サービスの起動時に受信エンドポイントへ結び付けます。ConfigureEndpoints を呼んでおけば、登録済みのコンシューマに対して命名規則に沿ったキューが自動で用意されます。
// InventoryService/Program.cs
builder.Services.AddMassTransit(x =>
{
    x.AddConsumer<OrderCreatedConsumer>();

    x.UsingRabbitMq((context, cfg) =>
    {
        var connectionString = builder.Configuration
            .GetConnectionString("messaging");
        cfg.Host(new Uri(connectionString!));
        cfg.ConfigureEndpoints(context);
    });
});
リトライとデッドレターで信頼性を確保する
非同期処理では、受信側の一時的な不調やデータストアのタイムアウトによって、メッセージの処理が失敗することがあります。こうした一過性の障害に対しては、間隔を空けて再試行するリトライが有効です。MassTransit では受信エンドポイントごとにリトライポリシーを指定でき、指数的に間隔を広げる設定にしておくと、下流の負荷を抑えながら回復を待てます。
// InventoryService/Program.cs(受信エンドポイントの信頼性設定)
cfg.ReceiveEndpoint("inventory-service", e =>
{
    e.ConfigureConsumer<OrderCreatedConsumer>(context);

    // 一時的な失敗に備えて段階的に再試行する
    e.UseMessageRetry(r => r.Exponential(
        retryLimit: 5,
        minInterval: TimeSpan.FromSeconds(1),
        maxInterval: TimeSpan.FromSeconds(30),
        intervalDelta: TimeSpan.FromSeconds(2)));

    // メッセージ処理と発行を一つの区切りとして扱う
    e.UseInMemoryOutbox(context);
});
リトライを尽くしても処理できないメッセージは、握りつぶすのではなく退避させます。この退避先がデッドレターキューです。処理に繰り返し失敗したメッセージはデッドレターへ移され、正常なフローを妨げないまま、後から原因を調査できる状態で保持されます。RabbitMQ でも Azure Service Bus でも、この考え方は共通です。Azure Service Bus では、サブスクリプションごとにデッドレターの扱いを設定でき、既定でも配信回数の上限を超えたメッセージは自動的にデッドレターへ送られます。
// デッドレターへ退避したメッセージを別プロセスで読み出して調査する
var receiver = client.CreateReceiver(
    "order-events", "inventory",
    new ServiceBusReceiverOptions
    {
        SubQueue = SubQueue.DeadLetter
    });

await foreach (var message in receiver.ReceiveMessagesAsync(cancellationToken))
{
    logger.LogWarning(
        "Dead-lettered message {MessageId}: {Reason}",
        message.MessageId,
        message.DeadLetterReason);

    // 原因を記録し、必要なら修正のうえ再投入する
    await receiver.CompleteMessageAsync(message);
}
あわせて考慮したいのがメッセージの重複です。リトライや再配送の仕組みは、同じメッセージが二度届く可能性を前提としています。コンシューマ側の処理は、同じイベントを複数回受け取っても結果が変わらない冪等な作りにしておくと安全です。処理済みのメッセージ ID を記録して重複を弾く、あるいは自然キーで上書きする、といった設計がここで効いてきます。
可観測性と連携する
Aspire のクライアントインテグレーションを使う利点は、接続の簡潔さだけではありません。AddRabbitMQClient をはじめとする各インテグレーションは、ブローカーへの到達性を確認するヘルスチェックと、OpenTelemetry によるトレースを自動で登録します。メッセージの発行と消費は分散トレースの区間として記録されるため、あるリクエストがどのイベントを発行し、それをどのサービスが処理したのかを、開発ダッシュボードのトレース画面でつないで追えます。
非同期処理はプロセスをまたいで進むため、同期呼び出しに比べて全体像が見えにくくなりがちです。プロデューサが付与したトレースコンテキストがメッセージのヘッダーを通じてコンシューマへ伝播することで、発行から消費までが一本の流れとして可視化されます。この伝播は Aspire と OpenTelemetry の連携によって既定で行われるため、追加の計測コードはほとんど要りません。
処理の滞留やスループットを継続的に把握したい場合は、独自のメトリクスを足します。IMeterFactory からメーターを取得し、発行数・消費数・処理時間・エラー数を記録しておくと、キューの詰まりや失敗の増加を早い段階で捉えられます。これらのメトリクスも ServiceDefaults の設定を通じてダッシュボードやバックエンドへ流れます。
// 共有のメッセージングメトリクス
public class MessagingMetrics
{
    private readonly Counter<long> _consumed;
    private readonly Histogram<double> _duration;
    private readonly Counter<long> _errors;

    public MessagingMetrics(IMeterFactory meterFactory)
    {
        var meter = meterFactory.Create("Messaging");
        _consumed = meter.CreateCounter<long>("messages_consumed");
        _duration = meter.CreateHistogram<double>(
            "message_processing_duration", unit: "ms");
        _errors = meter.CreateCounter<long>("message_errors");
    }

    public void RecordConsumed(string messageType) =>
        _consumed.Add(1, new KeyValuePair<string, object?>("type", messageType));

    public void RecordDuration(string messageType, double ms) =>
        _duration.Record(ms, new KeyValuePair<string, object?>("type", messageType));

    public void RecordError(string messageType) =>
        _errors.Add(1, new KeyValuePair<string, object?>("type", messageType));
}
まとめ
今回は、.NET Aspire でのメッセージングとイベント駆動アーキテクチャを、AppHost での登録からプロデューサ・コンシューマの実装、信頼性の確保、可観測性との連携まで通して確認しました。要点を整理します。
- 二段構えの構成 — AppHost でブローカーを起動し、
WithReferenceで接続文字列を注入、クライアント側は名前で結びつけます。 - ブローカーの選択 — 汎用の RabbitMQ、マネージドの Azure Service Bus、ストリーミング向けの Kafka を、呼び出すメソッドを替えるだけで切り替えられます。
- pub/sub とキューの使い分け — 一対多の通知には発行、特定サービスへの依頼には宛先指定の送信を選びます。
- リトライとデッドレター — 一過性の失敗は段階的な再試行で吸収し、回復不能なメッセージはデッドレターへ退避させて調査に回します。
- 可観測性が既定で入る — ヘルスチェックとトレースが自動配線され、プロセスをまたぐ非同期処理を一本の流れとして追えます。
エンハンスド株式会社では、.NET Aspire を用いた分散アプリケーションの設計と、既存 .NET システムのクラウドネイティブ化を支援しています。メッセージング基盤の選定、イベント駆動への移行、リトライやデッドレターを含む信頼性設計、可観測性の導入などについて、現状の構成を踏まえた初期のご相談から承りますので、お気軽にお問い合わせください。
次回予告:「第4回:観測可能性とモニタリング」では、OpenTelemetry を軸に、メトリクスとトレース、ログを束ねた包括的な監視を .NET Aspire でどう組み立てるかを詳しく解説します。
このテーマの全体像は .NET モダナイゼーション完全ガイド にまとめています。
本連載「.NET Aspire 入門」全6回
- 第1回 クラウドネイティブ開発の全体像とセットアップ
- 第2回 データベースとキャッシュの統合
- 第3回 メッセージングとイベント駆動アーキテクチャ(本記事)
- 第4回 可観測性とモニタリング
- 第5回 デプロイメントとスケーリング
- 第6回 本番運用のベストプラクティス
実務目線の総論は .NET Aspire で実現するクラウドネイティブ開発の実践ガイド もあわせてご覧ください。
この記事をシェア
関連記事
【.NET Aspire入門】第1回 クラウドネイティブ開発の全体像とセットアップ
複数のサービス、データベース、キャッシュ、メッセージブローカーが連携する分散アプリケーションを .NET で開発するとき、多くのチームが同じところでつまずきます。ローカル環境の立ち上げ手順が属人化し、…
【.NET Aspire入門】第2回 データベースとキャッシュの統合
第1回では、.NET Aspire の全体像と、AppHost・ServiceDefaults・開発ダッシュボードという構成要素を確認しました。第2回となる今回は、…
.NET によるクラウドネイティブ開発の実践ガイド
クラウドネイティブ開発とは、コンテナ・オーケストレーション・マネージドサービスを前提に、スケールと回復性、継続的デリバリを設計の中心へ据える取り組みを指します。.NET は近年のリリースで、…