はじめに
第1回では、.NET Aspire の全体像と、AppHost・ServiceDefaults・開発ダッシュボードという構成要素を確認しました。第2回となる今回は、実際のアプリケーションで避けて通れないデータベースとキャッシュの統合を扱います。分散アプリケーションでは、どのサービスがどのデータストアに接続するのか、接続文字列をどう配るのか、ローカルでどのようにデータベースを立ち上げるのかといった作業が積み重なります。Aspire はこの部分を AppHost のコードに集約し、接続情報の受け渡しと開発時のコンテナ起動を自動化します。
ここでは .NET 10 と GA 済みの Aspire を前提に、SQL Server と PostgreSQL の統合、Entity Framework Core との併用、マイグレーションの扱い、そして Redis と Garnet を用いた出力キャッシュ・分散キャッシュの実装までを順に見ていきます。可観測性については、これらのインテグレーションがヘルスチェックとテレメトリを自動で配線してくれる点もあわせて確認します。
データベースを AppHost に登録する
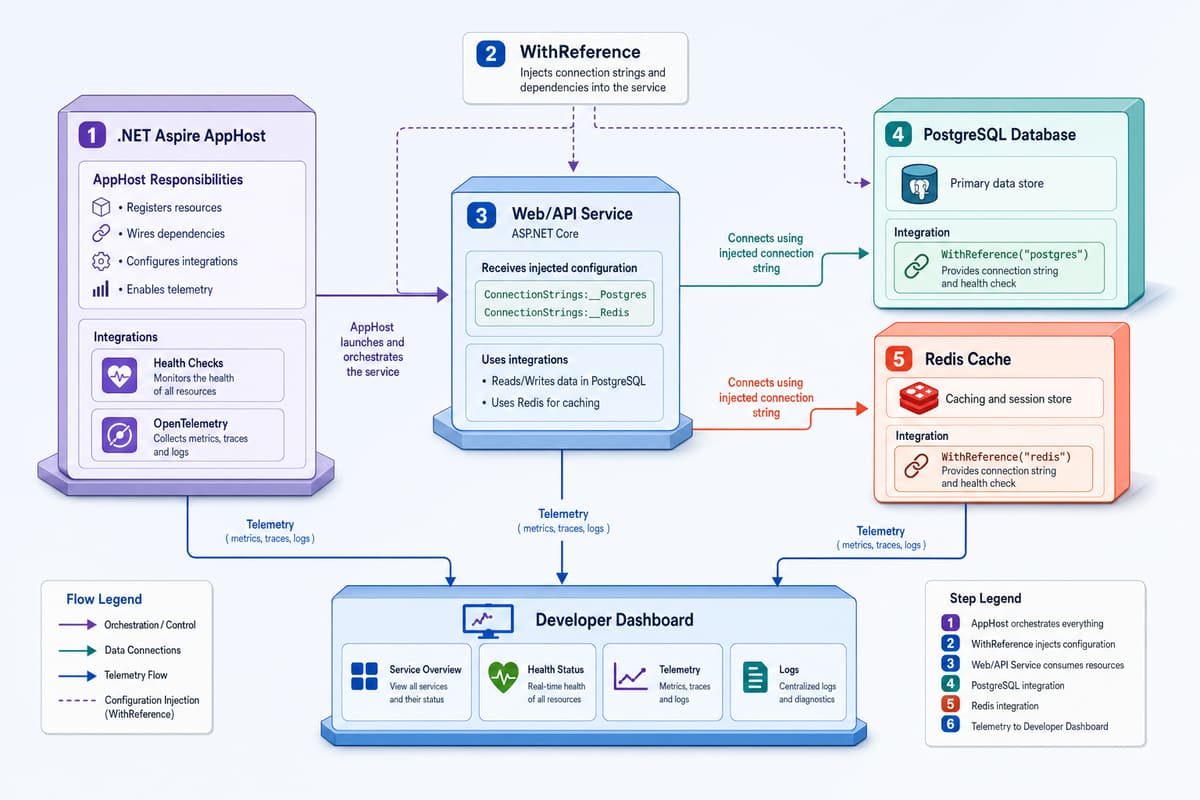
Aspire におけるデータベース統合は、ホスト側(AppHost)とクライアント側(各サービス)の二段構えで考えると整理しやすくなります。AppHost では、どのデータベースサーバーを起動し、どのサービスがそれを参照するかを宣言します。まずは SQL Server の例を示します。
// AppHost/AppHost.cs
var builder = DistributedApplication.CreateBuilder(args);

// SQL Server コンテナを起動し、データを永続化する
var sql = builder.AddSqlServer("sql")
    .WithDataVolume("sqldata");

// サーバー上に論理データベースを定義
var catalogDb = sql.AddDatabase("catalogdb");

// API サービスに catalogdb への参照を渡す
builder.AddProject("catalog-api")
    .WithReference(catalogDb)
    .WaitFor(catalogDb);

builder.Build().Run();
AddSqlServer は SQL Server をコンテナとして起動し、AddDatabase でその上に論理データベースを切ります。WithDataVolume を付けると、コンテナを再起動してもデータが保持されます。要となるのが WithReference で、これを呼ぶと Aspire は該当サービスへ catalogdb の接続文字列を環境変数として自動注入します。接続文字列をコードや設定ファイルに手書きする必要はありません。WaitFor は、データベースが起動を終えるまでサービスの開始を待たせる指定で、起動直後にマイグレーションを走らせる構成で効いてきます。
PostgreSQL を使う場合も、呼び出すメソッドが変わるだけで構造は同じです。管理 UI の pgAdmin をあわせて起動しておくと、開発中にテーブルの中身を確認しやすくなります。
// AppHost/AppHost.cs
var postgres = builder.AddPostgres("postgres")
    .WithDataVolume("pgdata")
    .WithPgAdmin(); // 開発用の管理 UI を同時に起動

var inventoryDb = postgres.AddDatabase("inventory");

builder.AddProject("inventory-service")
    .WithReference(inventoryDb)
    .WaitFor(inventoryDb);
クライアント側で EF Core を接続する
サービス側では、Aspire のクライアントインテグレーションを使って DbContext を登録します。AppHost で注入された接続文字列は、リソース名(この例では catalogdb)をキーにして解決されるため、名前を合わせるだけで結びつきます。SQL Server 向けには AddSqlServerDbContext を使います。
// CatalogApi/Program.cs
var builder = WebApplication.CreateBuilder(args);

// 可観測性・ヘルスチェック・サービスディスカバリーの共通設定
builder.AddServiceDefaults();

// リソース名 "catalogdb" の接続文字列を使って DbContext を登録
builder.AddSqlServerDbContext("catalogdb");

var app = builder.Build();

app.MapDefaultEndpoints();

app.MapGet("/api/products", async (CatalogDbContext db) =>
    await db.Products.Include(p => p.Category).ToListAsync());

app.MapPost("/api/products", async (Product product, CatalogDbContext db) =>
{
    db.Products.Add(product);
    await db.SaveChangesAsync();
    return Results.Created($"/api/products/{product.Id}", product);
});

app.Run();
PostgreSQL の場合は AddNpgsqlDbContext<InventoryDbContext>("inventory") に置き換えるだけで、残りの書き方は共通です。これらの拡張メソッドは、接続文字列の解決に加えて、接続プールの構成、リトライを含む回復性、そして後述するヘルスチェックとテレメトリの登録までをまとめて行います。DbContext 自体は通常どおり定義できます。
// CatalogApi/Data/CatalogDbContext.cs
public class CatalogDbContext(DbContextOptions options)
    : DbContext(options)
{
    public DbSet Products => Set();
    public DbSet Categories => Set();

    protected override void OnModelCreating(ModelBuilder modelBuilder)
    {
        modelBuilder.Entity()
            .HasOne(p => p.Category)
            .WithMany(c => c.Products)
            .HasForeignKey(p => p.CategoryId);
    }
}

public class Product
{
    public int Id { get; set; }
    public string Name { get; set; } = string.Empty;
    public decimal Price { get; set; }
    public int CategoryId { get; set; }
    public Category? Category { get; set; }
}

public class Category
{
    public int Id { get; set; }
    public string Name { get; set; } = string.Empty;
    public List Products { get; set; } = [];
}
マイグレーションと開発時のデータ投入
スキーマの適用方法は、開発時と本番で分けて考えるのが現実的です。開発中は、サービス起動時にマイグレーションを適用してしまうのが手軽です。WaitFor でデータベースの起動を待たせているため、初回起動時にテーブルがまだ無い状態でも安全に MigrateAsync を呼べます。
// CatalogApi/Program.cs(開発時のマイグレーション適用)
var app = builder.Build();

if (app.Environment.IsDevelopment())
{
    using var scope = app.Services.CreateScope();
    var db = scope.ServiceProvider.GetRequiredService();
    await db.Database.MigrateAsync();
}
ただし、複数のインスタンスが同時に起動する本番環境では、各インスタンスが起動時にマイグレーションを走らせる構成は競合の原因になります。本番では、スキーマ適用を専用のワーカーや初期化ジョブに分離し、アプリケーション本体はマイグレーション済みのデータベースに接続する、という切り分けが安全です。Aspire ではマイグレーション専用のプロジェクトを AppHost に登録し、そのプロジェクトの完了を WaitForCompletion でサービス側に待たせる構成を取れます。
// AppHost/AppHost.cs(マイグレーション用ワーカーを分離する)
var migrator = builder.AddProject("catalog-migrations")
    .WithReference(catalogDb)
    .WaitFor(catalogDb);

builder.AddProject("catalog-api")
    .WithReference(catalogDb)
    .WaitForCompletion(migrator); // マイグレーション完了後に起動
Redis と Garnet でキャッシュを統合する
キャッシュもデータベースと同じ二段構えです。AppHost で Redis を起動し、参照させたいサービスに WithReference で渡します。Aspire では、同じ Redis リソースを用途に応じて分散キャッシュ・出力キャッシュのどちらとしても登録できます。
// AppHost/AppHost.cs
var cache = builder.AddRedis("cache")
    .WithRedisCommander(); // 開発用の Redis 管理 UI

builder.AddProject("catalog-api")
    .WithReference(catalogDb)
    .WithReference(cache)
    .WaitFor(cache);
サービス側では、分散キャッシュとして使うなら AddRedisDistributedCache を登録します。以降は標準の IDistributedCache を通じて読み書きでき、実装が特定のライブラリに縛られません。ここでは、キャッシュを先に確認し、無ければデータベースから取得して書き戻す cache-aside の形を示します。
// CatalogApi/Program.cs
builder.AddServiceDefaults();
builder.AddSqlServerDbContext("catalogdb");
builder.AddRedisDistributedCache("cache"); // IDistributedCache として登録

// ...

app.MapGet("/api/products/{id:int}", async (
    int id, CatalogDbContext db, IDistributedCache cache) =>
{
    var key = $"product:{id}";

    var cached = await cache.GetStringAsync(key);
    if (!string.IsNullOrEmpty(cached))
        return Results.Ok(JsonSerializer.Deserialize(cached));

    var product = await db.Products
        .Include(p => p.Category)
        .FirstOrDefaultAsync(p => p.Id == id);

    if (product is null)
        return Results.NotFound();

    await cache.SetStringAsync(key, JsonSerializer.Serialize(product),
        new DistributedCacheEntryOptions
        {
            AbsoluteExpirationRelativeToNow = TimeSpan.FromMinutes(5)
        });

    return Results.Ok(product);
});
ページやエンドポイントの応答そのものをまるごとキャッシュしたい場合は、出力キャッシュのほうが手数が少なくて済みます。AddRedisOutputCache を登録し、UseOutputCache を挟んだうえで、キャッシュしたいエンドポイントに CacheOutput を付けます。キャッシュのバックエンドが Redis になるため、複数インスタンス間で応答を共有できます。
// CatalogApi/Program.cs(出力キャッシュ)
builder.AddRedisOutputCache("cache");

var app = builder.Build();
app.UseOutputCache();

app.MapGet("/api/categories", async (CatalogDbContext db) =>
        await db.Categories.ToListAsync())
    .CacheOutput(policy => policy.Expire(TimeSpan.FromMinutes(1)));
Garnet は Microsoft が開発した Redis 互換のキャッシュサーバーで、Redis プロトコルをそのまま話せます。AppHost 側で AddRedis を AddGarnet に差し替えるだけで、クライアント側のコードには手を入れずに切り替えられます。
// AppHost/AppHost.cs(Redis を Garnet に置き換える)
var cache = builder.AddGarnet("cache")
    .WithDataVolume("cachedata");
ヘルスチェックとテレメトリの自動付与
Aspire のクライアントインテグレーションを使う利点は、接続の簡潔さだけではありません。AddSqlServerDbContext や AddRedisDistributedCache は、それぞれの依存先に対するヘルスチェックを自動で登録します。ServiceDefaults が公開する /health と /alive のエンドポイントに、データベースや Redis への到達性が反映されるため、依存リソースが落ちている状態を早い段階で検知できます。
テレメトリも同様に配線されます。EF Core のクエリや Redis の操作は OpenTelemetry のトレースとして記録され、開発ダッシュボードのトレース画面に区間として現れます。どのリクエストがどのクエリを発行し、キャッシュにヒットしたのか、データベースまで到達したのかを、追加の計測コードを書かずに追えます。既定の挙動を調整したい場合は、各インテグレーションの登録時に設定オブジェクトを渡してヘルスチェックやトレースの有効・無効を切り替えられます。
// 既定の配線を個別に調整する例
builder.AddSqlServerDbContext("catalogdb", settings =>
{
    settings.DisableHealthChecks = false;   // ヘルスチェックは有効のまま
    settings.DisableTracing = false;        // トレースも有効のまま
    settings.CommandTimeout = 30;
});
まとめ
今回は、.NET Aspire でのデータベースとキャッシュの統合を、AppHost での登録からクライアント側の接続、マイグレーション、キャッシュ戦略まで通して確認しました。要点を整理します。
- 二段構えの構成 — AppHost でリソースを起動し、
WithReferenceで接続文字列を注入、クライアント側は名前で結びつけます。 - データストアの差し替え — SQL Server と PostgreSQL、Redis と Garnet は、呼び出すメソッドを替えるだけで移行でき、業務コードへの影響が小さく収まります。
- マイグレーションの分離 — 開発時は起動時適用で十分ですが、本番では専用ワーカーへ切り出して競合を避けます。
- 用途に応じたキャッシュ — きめ細かな制御には分散キャッシュ、応答全体には出力キャッシュを選べます。
- 可観測性が既定で入る — ヘルスチェックとテレメトリが自動配線され、依存リソースの状態を最初から追えます。
エンハンスド株式会社では、.NET Aspire を用いた分散アプリケーションの設計と、既存 .NET システムのクラウドネイティブ化を支援しています。データベースやキャッシュの統合方針、可観測性の導入、本番環境でのマイグレーション運用などについて、現状の構成を踏まえた初期のご相談から承りますので、お気軽にお問い合わせください。
次回予告:「第3回:メッセージングとイベント駆動アーキテクチャ」では、RabbitMQ や Azure Service Bus などのメッセージングシステムを .NET Aspire で活用し、サービス間を疎結合につなぐ方法を詳しく解説します。
このテーマの全体像は .NET モダナイゼーション完全ガイド にまとめています。
本連載「.NET Aspire 入門」全6回
- 第1回 クラウドネイティブ開発の全体像とセットアップ
- 第2回 データベースとキャッシュの統合(本記事)
- 第3回 メッセージングとイベント駆動アーキテクチャ
- 第4回 可観測性とモニタリング
- 第5回 デプロイメントとスケーリング
- 第6回 本番運用のベストプラクティス
実務目線の総論は .NET Aspire で実現するクラウドネイティブ開発の実践ガイド もあわせてご覧ください。
この記事をシェア
関連記事
【.NET Aspire入門】第1回 クラウドネイティブ開発の全体像とセットアップ
複数のサービス、データベース、キャッシュ、メッセージブローカーが連携する分散アプリケーションを .NET で開発するとき、多くのチームが同じところでつまずきます。ローカル環境の立ち上げ手順が属人化し、…
【.NET Aspire入門】第3回 メッセージングとイベント駆動アーキテクチャ
第2回では、SQL Server や PostgreSQL、Redis といったデータストアを .NET Aspire の AppHost に登録し、…
.NET によるクラウドネイティブ開発の実践ガイド
クラウドネイティブ開発とは、コンテナ・オーケストレーション・マネージドサービスを前提に、スケールと回復性、継続的デリバリを設計の中心へ据える取り組みを指します。.NET は近年のリリースで、…