はじめに
ローカルで軽快に動く .NET Aspire アプリケーションを、そのまま本番環境へ届けられるかどうかが、クラウドネイティブ開発の実用性を左右します。開発時に AppHost が面倒を見ていたサービス間の接続、環境変数、コンテナの起動順序といった配線を、本番のインフラでも再現しなければならないからです。ここで手作業のマニフェスト編集に逆戻りしてしまうと、Aspire が抽象化してくれた価値が失われます。
連載第4回では、OpenTelemetry を軸とした可観測性とモニタリングを扱いました。第5回となる今回は、.NET 10 で正式版となった .NET Aspire を前提に、デプロイメントとスケーリングを解説します。Aspire のデプロイモデルとマニフェストの役割から、azd による Azure Container Apps への配置、Kubernetes へのデプロイ、レプリカと KEDA を用いたオートスケール、シークレットや接続情報の受け渡し、そして CI/CD への組み込みまでを順に見ていきます。
Aspire のデプロイモデルとマニフェスト
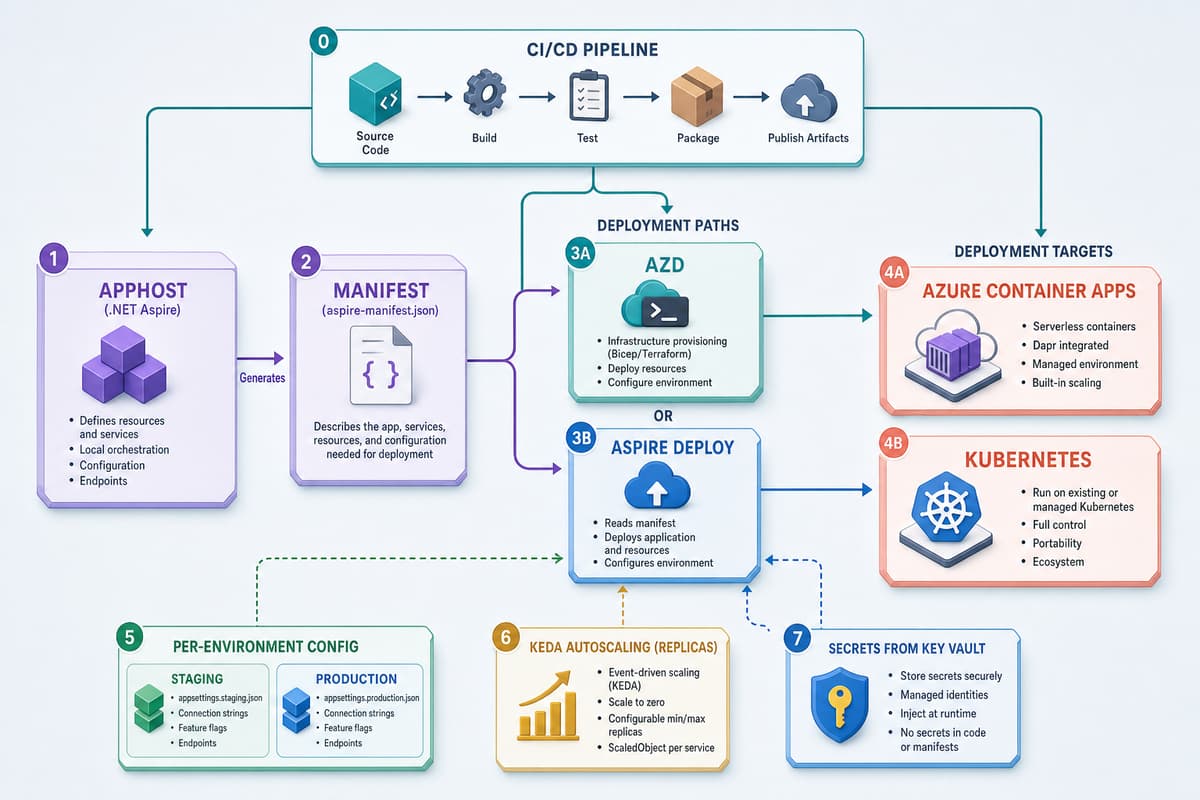
Aspire のアプリケーションモデルは、AppHost に集約されています。どのプロジェクトを起動し、どのコンテナに依存し、どの接続情報をどのサービスへ渡すかが、C# のコードとして一箇所に記述されます。この構成情報を本番環境向けに書き出したものがマニフェストであり、各種のデプロイ先はこのマニフェストを入力として実際のインフラ定義へ変換します。
マニフェストは、デプロイツールが読み取る中間表現です。開発者が直接編集することは想定されておらず、AppHost のコードが唯一の情報源になります。生成には aspire CLI を使います。
# .NET 10 SDK に含まれる aspire CLI を利用する
# マニフェスト(デプロイ用の中間表現)を書き出す
aspire publish --project AppHost/AppHost.csproj --output-path ./artifacts

# 生成物には各リソースの定義と依存関係が含まれる
ls ./artifacts
# aspire-manifest.json  ...
マニフェストには、各リソースの種別(プロジェクト、コンテナ、外部サービス)、公開するエンドポイント、そして {sql.connectionString} のようなプレースホルダで表現された接続情報の参照関係が含まれます。デプロイ先はこの参照を解決し、実際の接続文字列やシークレットへ差し替えます。つまり、どの環境へ出す場合でも、サービス間の依存関係という本質的な構造は AppHost のコードから一貫して導かれます。
AppHost 側では、リソースを登録するだけでこの構造が定義されます。次の例は、Redis と SQL Server に依存する API を宣言したものです。
// AppHost/AppHost.cs
var builder = DistributedApplication.CreateBuilder(args);

var cache = builder.AddRedis("cache");
var sql = builder.AddSqlServer("sql")
    .AddDatabase("appdb");

builder.AddProject<Projects.Api>("api")
    .WithReference(cache)
    .WithReference(sql)
    .WithReplicas(3);

builder.Build().Run();
WithReference による依存の宣言が、マニフェスト上の接続情報の受け渡しへとそのまま対応します。開発者が接続文字列を手で書き写す必要はなく、参照を宣言すれば配線はツールが担います。
azd による Azure Container Apps へのデプロイ
Azure 上で Aspire アプリケーションを動かす際、最も統合が進んでいる配置先が Azure Container Apps です。Container Apps は内部で KEDA を用いたスケーリングを標準搭載しており、Aspire のマニフェストとの相性がよく、Azure Developer CLI(azd)が変換からデプロイまでを引き受けます。
プロジェクトのルートで azd init を実行すると、azd は AppHost を検出し、必要なテンプレートを構成します。あとは環境を作成してデプロイするだけです。
# Aspire プロジェクトを検出して初期化する
azd init

# 環境ごとに構成を分ける(本番用の環境を作成)
azd env new production

# インフラのプロビジョニングとアプリのデプロイをまとめて実行
azd up
azd up は、Container Apps 環境、コンテナレジストリ、Log Analytics といった土台をプロビジョニングし、各プロジェクトをコンテナイメージへビルドしてデプロイします。環境ごとの差異は azd の環境(environment)として管理され、azd env new staging のように分けておけば、同じコードから検証系と本番系を切り替えられます。環境固有の値は環境変数として設定します。
# 現在の環境に固有の設定値を与える
azd env set AZURE_LOCATION japaneast
azd env set API__RATELIMIT 1000

# 環境を切り替える
azd env select staging
Container Apps 側の挙動、たとえばレプリカ数やスケールルールは、AppHost のコードから宣言的に指定できます。PublishAsAzureContainerApp を使うと、生成される Container App の定義に手を入れられます。
// AppHost/AppHost.cs
builder.AddProject<Projects.Api>("api")
    .WithReference(cache)
    .WithReference(sql)
    .PublishAsAzureContainerApp((infra, app) =>
    {
        // 最小・最大レプリカ数を指定する
        app.Template.Scale.MinReplicas = 2;
        app.Template.Scale.MaxReplicas = 10;
    });
この記述により、インフラ定義を別途 Bicep で手書きすることなく、アプリケーションモデルの一部としてスケーリング方針を管理できます。コードとインフラの記述が乖離しないため、構成変更の追跡が容易になります。
Kubernetes へのデプロイ
組織の標準基盤が Kubernetes である場合や、複数のクラウドをまたいで運用する場合には、Aspire アプリケーションを Kubernetes マニフェストへ変換して配置します。Aspire のマニフェストは Kubernetes 固有ではないため、変換ツールを介して Deployment や Service、HorizontalPodAutoscaler といったリソース定義を生成します。コミュニティ製の Aspir8(aspirate)が代表的な選択肢です。
# 変換ツールを導入する
dotnet tool install -g aspirate

# AppHost から Kubernetes マニフェストを生成する
aspirate generate --project AppHost/AppHost.csproj --output-path ./k8s

# クラスタへ適用する
kubectl apply -f ./k8s
生成される Deployment には、リソース要求と上限、ヘルスチェック用のプローブがあらかじめ組み込まれます。次に主要な部分を抜き出します。接続情報は Secret から注入され、CPU とメモリのリクエストとリミットが明示されている点に注目してください。
# k8s/api-deployment.yaml(抜粋)
apiVersion: apps/v1
kind: Deployment
metadata:
  name: api
spec:
  replicas: 3
  selector:
    matchLabels:
      app: api
  template:
    metadata:
      labels:
        app: api
    spec:
      containers:
        - name: api
          image: myregistry.azurecr.io/api:latest
          ports:
            - containerPort: 8080
          env:
            - name: ConnectionStrings__appdb
              valueFrom:
                secretKeyRef:
                  name: api-secrets
                  key: sql-connection
          resources:
            requests:
              cpu: "250m"
              memory: "256Mi"
            limits:
              cpu: "500m"
              memory: "512Mi"
          livenessProbe:
            httpGet:
              path: /health/live
              port: 8080
          readinessProbe:
            httpGet:
              path: /health/ready
              port: 8080
ここで参照している /health/live と /health/ready は、ServiceDefaults の AddDefaultHealthChecks が公開するエンドポイントです。Aspire が用意する既定のヘルスチェックが、そのまま Kubernetes の生存性・準備性プローブと噛み合う設計になっています。リソースのリクエストとリミットは、スケジューリングとオートスケールの前提になるため、実測に基づいて調整していきます。
レプリカとオートスケール
スケーリングには、あらかじめ台数を決めておく静的なレプリカ設定と、負荷に応じて台数を増減させるオートスケールの二つの側面があります。安定した基準負荷はレプリカの下限で確保し、変動する上振れをオートスケールで吸収するのが基本的な考え方です。
Kubernetes 標準の HorizontalPodAutoscaler は CPU やメモリの使用率を指標にしますが、リクエスト数やキューの滞留といった業務に近い指標でスケールさせたい場合は KEDA(Kubernetes Event-driven Autoscaling)を使います。KEDA は多様なイベントソースをトリガーとして扱え、Azure Container Apps のスケーリングも内部的にはこの仕組みに支えられています。
# k8s/keda-scaler.yaml
apiVersion: keda.sh/v1alpha1
kind: ScaledObject
metadata:
  name: api-scaler
spec:
  scaleTargetRef:
    name: api
  minReplicaCount: 2
  maxReplicaCount: 20
  cooldownPeriod: 300
  triggers:
    # 1秒あたりのリクエスト数でスケールする
    - type: prometheus
      metadata:
        serverAddress: http://prometheus:9090
        query: sum(rate(http_server_request_duration_seconds_count[1m]))
        threshold: "100"
    # メッセージキューの滞留でスケールする
    - type: rabbitmq
      metadata:
        host: amqp://rabbitmq:5672
        queueName: orders
        queueLength: "10"
複数のトリガーを並べた場合、KEDA はいずれかの条件が閾値を超えれば必要なレプリカ数を算出します。注文キューが滞留したときにも、CPU 使用率がまだ低いうちからスケールアウトできるため、非同期処理を含むシステムに向いています。cooldownPeriod はトリガーが解消してから縮退するまでの待機時間で、瞬間的な負荷変動でレプリカが激しく振動するのを防ぎます。
Azure Container Apps 上では、同等のスケールルールを AppHost のコードで宣言できます。HTTP の同時リクエスト数を基準にする例を示します。
// AppHost/AppHost.cs
builder.AddProject<Projects.Api>("api")
    .PublishAsAzureContainerApp((infra, app) =>
    {
        app.Template.Scale.MinReplicas = 2;
        app.Template.Scale.MaxReplicas = 20;
        app.Template.Scale.Rules =
        [
            new ContainerAppScaleRule
            {
                Name = "http-scaling",
                Http = new ContainerAppHttpScaleRule
                {
                    ConcurrentRequests = "100"
                }
            }
        ];
    });
レプリカの下限をゼロにすればアイドル時にコストを抑えられますが、コールドスタートによる初回応答の遅延と引き換えになります。常時応答性が求められる API では下限を1以上に保ち、バッチ的なワーカーではゼロを許容するといった使い分けが実務的です。
シークレットの受け渡しと CI/CD 連携
本番デプロイで避けて通れないのが、接続文字列やパスワードといった機密情報の扱いです。これらをコードやマニフェストに直接書き込むことはできません。Aspire では、パラメータとして宣言した値を機密扱いにでき、デプロイ先ごとに適切な保管場所へ橋渡しされます。
// AppHost/AppHost.cs
// secret: true で機密パラメータとして宣言する
var sqlPassword = builder.AddParameter("sql-password", secret: true);

var sql = builder.AddSqlServer("sql", password: sqlPassword)
    .AddDatabase("appdb");
この機密パラメータの実際の値は、環境ごとに外側から与えます。azd を使う場合は環境の設定として安全に保管され、プロビジョニング時に Azure Key Vault へ格納されたうえで、Container Apps のシークレットとして参照されます。Kubernetes へ配置する場合は、対応する Secret リソースとして展開されます。いずれの場合も、値そのものはリポジトリに残りません。
# 機密パラメータの値をデプロイ時に安全に渡す
azd env set-secret sql-password
# プロンプトで入力した値は暗号化して保管される
デプロイの手順が固まったら、CI/CD へ組み込んで自動化します。azd はパイプラインの雛形を生成でき、認証には OpenID Connect(OIDC)によるフェデレーション資格情報を用いるため、長期のシークレットをリポジトリに置かずに済みます。
# GitHub Actions 用のパイプラインを構成する
# OIDC のフェデレーション資格情報とワークフローを準備する
azd pipeline config --provider github
生成されるワークフローは、おおむね次の形になります。認証情報を持たず、OIDC でトークンを取得してから azd でプロビジョニングとデプロイを実行する流れです。
# .github/workflows/azure-dev.yml(抜粋)
on:
  push:
    branches: [main]

permissions:
  id-token: write   # OIDC トークンの発行に必要
  contents: read

jobs:
  deploy:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - uses: Azure/setup-azd@v2
      - name: Log in with OIDC
        run: |
          azd auth login \
            --client-id "$AZURE_CLIENT_ID" \
            --federated-credential-provider "github" \
            --tenant-id "$AZURE_TENANT_ID"
        env:
          AZURE_CLIENT_ID: ${{ vars.AZURE_CLIENT_ID }}
          AZURE_TENANT_ID: ${{ vars.AZURE_TENANT_ID }}
      - name: Provision and deploy
        run: azd up --no-prompt
        env:
          AZURE_ENV_NAME: ${{ vars.AZURE_ENV_NAME }}
          AZURE_SUBSCRIPTION_ID: ${{ vars.AZURE_SUBSCRIPTION_ID }}
環境ごとにワークフローや環境変数を分けておけば、main への統合で検証系へ、リリースタグで本番系へといった段階的な配信も構成できます。デプロイが宣言的なコードに帰着しているため、パイプラインは AppHost の変更をそのまま反映するだけで済みます。
まとめ
今回は、.NET Aspire アプリケーションのデプロイメントとスケーリングを扱いました。要点は、AppHost のアプリケーションモデルを唯一の情報源とし、マニフェストを介して Azure Container Apps や Kubernetes といった配置先へ一貫して展開するという流れです。レプリカの下限で基準負荷を支え、KEDA によるオートスケールで変動を吸収し、機密情報はパラメータとして宣言してデプロイ先の安全な保管場所へ橋渡しします。これらを azd のパイプラインで自動化すれば、コードの変更がそのまま本番へ届く再現性のある配信が実現します。まずは azd init と azd up で検証環境へ一度デプロイし、スケールルールを実測に合わせて調整していくのが取り組みやすい入口です。
エンハンスド株式会社では、.NET Aspire を用いたクラウドネイティブ開発を、アーキテクチャ設計から Azure Container Apps・Kubernetes への本番デプロイ、オートスケールと CI/CD の整備まで一貫して支援しています。既存システムのコンテナ化や、再現性のあるデプロイ基盤の構築を具体化したい方は、お気軽にお問い合わせください。
次回の第6回では、本番環境でのベストプラクティスと運用上の考慮事項を取り上げ、セキュリティ、パフォーマンス最適化、コスト管理を解説します。
このテーマの全体像は .NET モダナイゼーション完全ガイド にまとめています。
本連載「.NET Aspire 入門」全6回
- 第1回 クラウドネイティブ開発の全体像とセットアップ
- 第2回 データベースとキャッシュの統合
- 第3回 メッセージングとイベント駆動アーキテクチャ
- 第4回 可観測性とモニタリング
- 第5回 デプロイメントとスケーリング(本記事)
- 第6回 本番運用のベストプラクティス
実務目線の総論は .NET Aspire で実現するクラウドネイティブ開発の実践ガイド もあわせてご覧ください。
この記事をシェア
関連記事
.NET によるクラウドネイティブ開発の実践ガイド
クラウドネイティブ開発とは、コンテナ・オーケストレーション・マネージドサービスを前提に、スケールと回復性、継続的デリバリを設計の中心へ据える取り組みを指します。.NET は近年のリリースで、…
【.NET Orleans入門】第4回 クラスタリングと高可用性 - 本番環境でのOrleans運用
これまでの連載では、Orleans の基本概念、ステート管理と永続化、そして Grain 間通信とストリーミングを扱ってきました。第4回となる今回は、…
AKS(Azure Kubernetes Service)運用ガイド — .NET アプリの本番運用
AKS(Azure Kubernetes Service)は、Kubernetes のコントロールプレーンをマネージドで提供し、ノードやネットワーク、監視、…