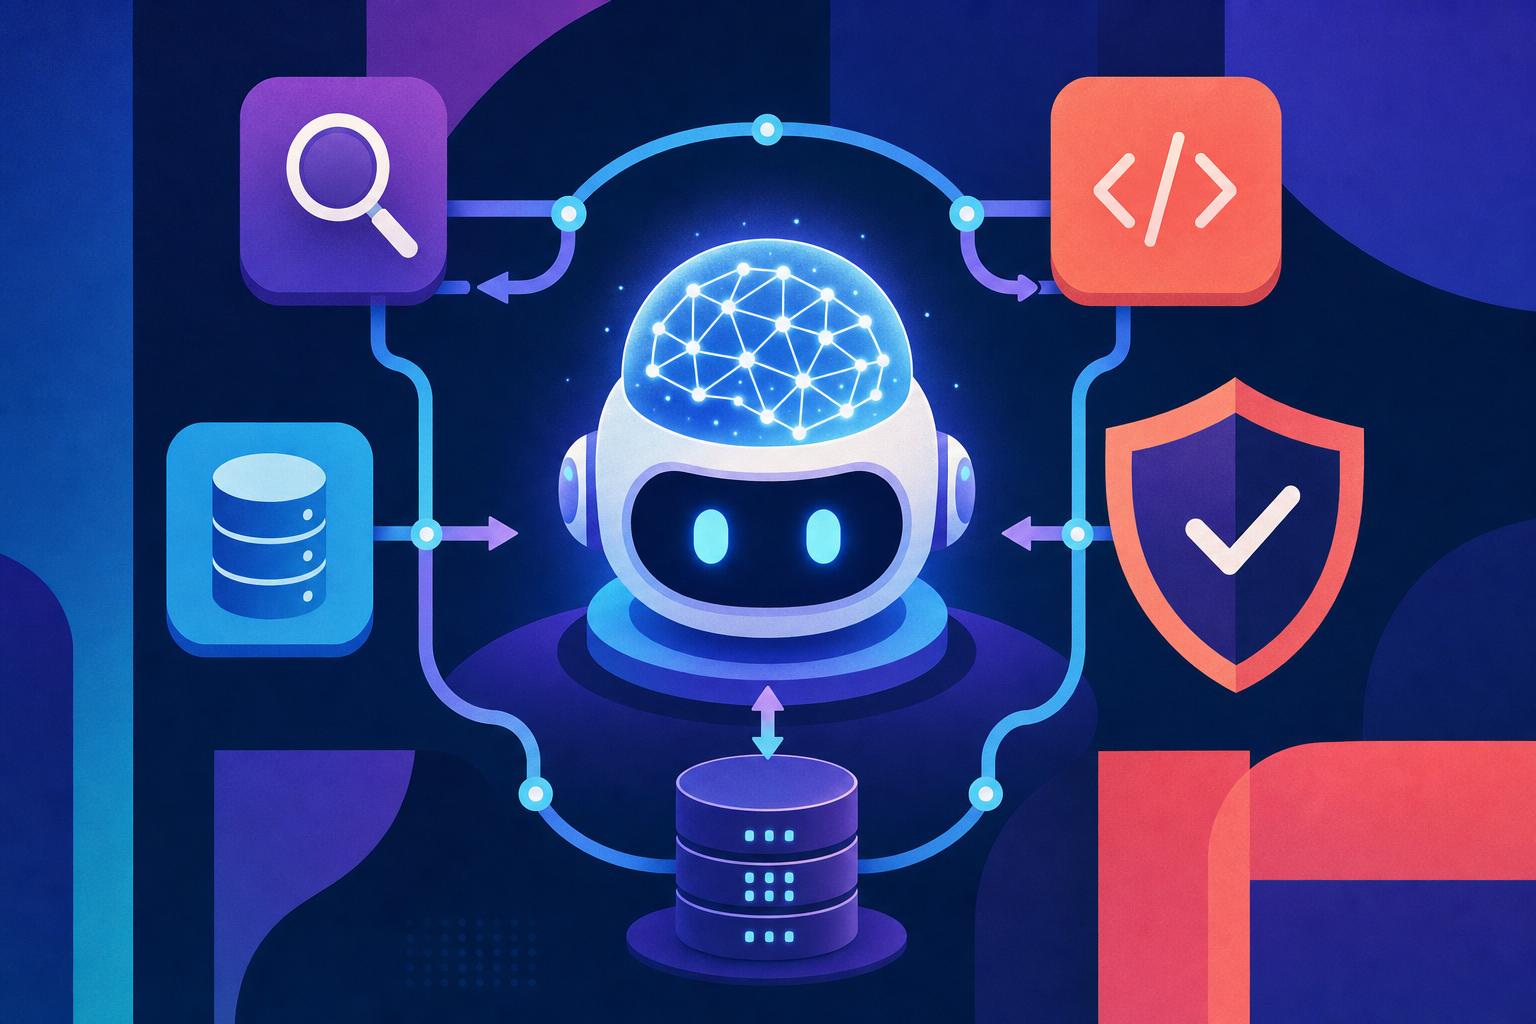
AI エージェントは、LLM を単発の質問応答として使うのではなく、ツール使用・計画・自己検証・ループ制御を組み合わせて、与えられた目標を自律的に達成させる仕組みである。単純なチャット応答と異なり、外部システムへの副作用を伴う実行を含むため、設計を誤ると無限ループやコスト暴走、意図しない操作といった実務上のリスクに直結する。本記事では、代表的な設計パターンと、状態管理・ガードレール・評価、そして .NET での実装イメージまでを、2026 年時点の実装水準に沿って整理する。
AI エージェントとは何か
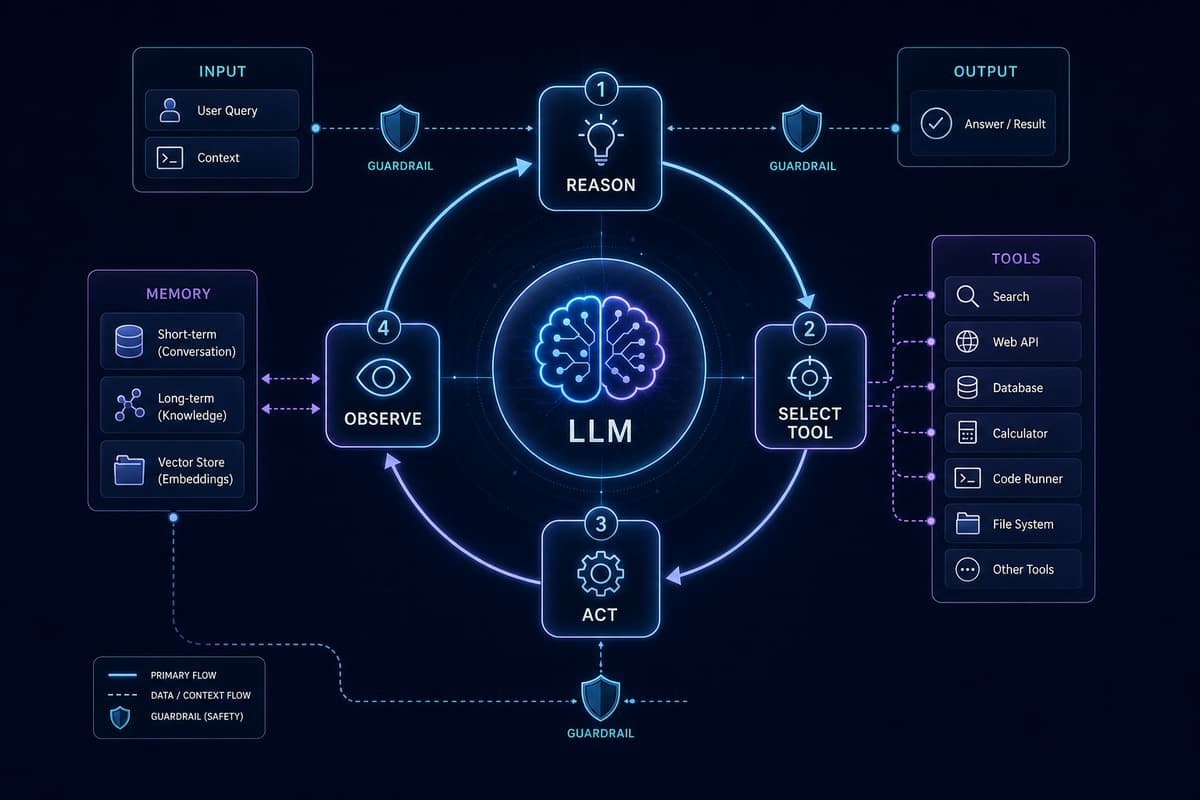
AI エージェントは、大きく4つの要素で構成される。第一に推論の中核を担う LLM、第二に外部と相互作用するためのツール使用(関数呼び出し)、第三に目標を分解するための計画、第四にこれらを繰り返し回すループ制御である。エージェントは「観測 → 推論 → 行動 → 観測」というサイクルを、目標が達成されるか停止条件に到達するまで回し続ける。
この4要素のうち、ツール使用とループ制御がエージェントを通常の LLM 呼び出しと区別する。LLM は自然言語生成そのものは得意だが、正確な計算や最新データの取得、外部システムの状態変更はできない。これらをツールとして与え、LLM に「いつどのツールを呼ぶか」を判断させることで、実務的な自動化が成立する。
代表的な設計パターン
エージェントの構築には確立された設計パターンがあり、要件に応じて選択・組み合わせる。
tool calling / function calling
最も基本となるパターンである。利用可能なツールのスキーマ(名前・説明・引数)をモデルに提示し、モデルはユーザー要求に応じて呼び出すべきツールと引数を構造化された形式で返す。アプリケーション側が実際にツールを実行し、その結果をモデルに戻す。主要な LLM プロバイダはこの機能をネイティブに提供しており、エージェントのほぼすべてのパターンがこの仕組みの上に成り立つ。
ReAct(推論と行動の交互)
Reasoning と Acting を交互に行うパターンである。モデルはまず「次に何をすべきか」を推論し(Thought)、続いてツールを呼び出し(Action)、その結果を観測(Observation)してから次の推論に進む。この明示的な思考ステップを挟むことで、複数ツールを跨ぐ調査型タスクの精度と追跡性が高まる。
planning(計画してから実行)
タスクを最初にサブタスクへ分解し、計画を立ててから順に実行するパターンである。ReAct が逐次的に判断を重ねるのに対し、planning は全体像を先に固定するため、依存関係のある多段タスクや、途中で方針が発散しやすいタスクに向く。計画と実行を別の LLM 呼び出しに分離する構成(プランナーとエグゼキュータ)が典型である。
reflection(自己検証)
生成した出力や実行結果をモデル自身に検証させ、問題があれば修正させるパターンである。コード生成後にテストを実行して失敗を戻す、下書きを批評してから書き直す、といった構成で品質を段階的に高める。ただし検証ステップの分だけ呼び出し回数とコストが増えるため、反復回数の上限は必須である。
multi-agent(役割分担)
単一の巨大なエージェントに全責務を負わせるのではなく、役割ごとに専門エージェントを分け、オーケストレータが調整するパターンである。調査・執筆・レビューのように責務が明確に分かれるタスクで、各エージェントのプロンプトとツール範囲を絞れるため、信頼性と保守性が向上する。一方でエージェント間の通信設計と全体コストの管理が新たな課題になる。
human-in-the-loop
副作用の大きい操作や不確実性の高い判断について、実行前に人間の承認を挟むパターンである。メール送信、決済、データ削除といった不可逆操作の手前で処理を中断し、承認を得てから続行する。完全自律を目指すよりも、重要な分岐点だけを人間に委ねる設計が実務では現実的である。
ツールの定義と安全な実行
ツールは、名前・目的の説明・引数スキーマの3点でモデルに提示する。説明は曖昧さを排して具体的に書く。モデルは説明文を手がかりに呼び出しを判断するため、記述の質がそのまま呼び出し精度に直結する。
実行側では、モデルが返した引数を信頼せずに必ず検証する。型と範囲のバリデーション、SQL やコマンドのインジェクション対策、ファイルパスやURLのホワイトリスト化を行う。ツールは最小権限で動かし、読み取り専用で足りるものに書き込み権限を与えない。副作用を伴うツールには冪等性を持たせるか、実行前に確認ステップを設けることで、誤呼び出しによる被害を抑える。
状態と記憶
エージェントは会話や実行の文脈を保持する必要がある。記憶は短期と長期に分けて考える。
短期メモリは、現在のタスク内でのやり取りやツール実行結果を保持するもので、通常はコンテキストウィンドウ上の会話履歴として扱う。履歴が長くなるとトークン量とコストが増えるため、古いやり取りの要約や、直近と関連分のみを残すトリミングを行う。
長期メモリは、セッションを跨いで保持したい知識やユーザー固有情報であり、外部ストアに永続化する。ここで RAG(検索拡張生成)と組み合わせるのが定石である。関連文書やナレッジをベクトルデータベース等に格納し、必要なときに検索してコンテキストへ注入することで、モデルの学習知識に含まれない社内情報や最新データを扱える。RAG 自体をエージェントのツールの一つとして登録し、モデルに検索の要否を判断させる構成も一般的である。
ガードレール
自律的に動くからこそ、境界を明示的に設けることが不可欠である。最低限、以下の観点を設計に含める。
- 入力検証 - ユーザー入力とツール引数を検証し、プロンプトインジェクションや不正な指示を弾く。
- 権限 - エージェントとツールを最小権限で動かし、実行主体ごとにアクセス範囲を分離する。
- コスト上限 - タスクあたりのトークン数や呼び出し回数に上限を設け、超過時は中断する。
- ループ制限 - 反復回数の上限(最大ステップ数)を必ず設定し、進捗のない繰り返しを検知して停止する。
これらは「あると良い」ものではなく、本番運用の前提条件である。特にコスト上限とループ制限は、後述する失敗モードへの直接的な防御策となる。
評価とオブザーバビリティ
エージェントは非決定的に振る舞うため、単体テストだけでは品質を担保できない。評価とオブザーバビリティを実装に組み込む。
評価は、代表的なタスクを集めた評価セットに対して、成功率・ツール呼び出しの正確性・出力品質を継続的に測る。プロンプトやモデルを変更した際に、この評価セットで回帰を検出できるようにしておく。品質判定を別の LLM に行わせる LLM-as-a-judge も有効だが、判定基準の妥当性は人手で定期的に確認する。
オブザーバビリティは、各ステップの入力・出力・ツール呼び出し・トークン消費・レイテンシをトレースとして記録する。OpenTelemetry など標準的な仕組みで計測し、どのステップで失敗やコスト増が起きたかを追跡できるようにする。エージェントは内部で多段の処理を行うため、この可視化がないと障害の切り分けが困難になる。
.NET での実装イメージ
.NET では、Microsoft.Extensions.AI が LLM 呼び出しとツール(関数)呼び出しの抽象を提供し、プロバイダ非依存でエージェントを構築できる。C# のメソッドをそのままツールとして登録できるため、ツール定義のボイラープレートが少ない。
using Microsoft.Extensions.AI;

// C# メソッドをツールとして公開する
[Description("指定した都市の現在の天気を取得する")]
static string GetWeather(
    [Description("都市名(例: Tokyo)")] string city)
{
    // 実際には外部 API を呼び出す。引数は必ず検証する
    return $"{city} は晴れ、気温 24 度";
}

// プロバイダ実装をラップし、関数呼び出しを有効化する
IChatClient client = baseClient
    .AsBuilder()
    .UseFunctionInvocation()
    .Build();

var options = new ChatOptions
{
    Tools = [AIFunctionFactory.Create(GetWeather)],
    // ループ制限とコスト管理の一環として上限を設ける
    MaxOutputTokens = 1024,
};

var response = await client.GetResponseAsync(
    "東京の天気を教えて", options);

Console.WriteLine(response.Text);
より高度なオーケストレーション(計画、multi-agent、プラグイン管理)が必要な場合は、Semantic Kernel を用いる。Semantic Kernel では、機能をプラグインとしてカーネルに登録し、モデルに自動で呼び出させる。
using Microsoft.SemanticKernel;
using Microsoft.SemanticKernel.Connectors.OpenAI;

var builder = Kernel.CreateBuilder();
builder.AddAzureOpenAIChatCompletion(
    deploymentName: "gpt-deployment",
    endpoint: endpoint,
    apiKey: apiKey);

// C# クラスのメソッドをプラグインとして登録する
builder.Plugins.AddFromType<WeatherPlugin>();
Kernel kernel = builder.Build();

// FunctionChoiceBehavior.Auto でツール呼び出しを自動化する
var settings = new OpenAIPromptExecutionSettings
{
    FunctionChoiceBehavior = FunctionChoiceBehavior.Auto(),
};

var result = await kernel.InvokePromptAsync(
    "東京の天気を教えて",
    new(settings));

Console.WriteLine(result);
いずれの構成でも、ツールメソッド内での引数検証、反復回数と出力トークンの上限、トレースの記録は実装者の責務である。フレームワークは呼び出しの仕組みを提供するが、ガードレールそのものは提供しない。
失敗モードと対策
エージェント特有の代表的な失敗モードと、その対策を整理する。
- ハルシネーション - モデルが存在しない事実やツールを捏造する。対策として、事実は RAG で外部知識に基づかせ、ツールの実行結果を根拠として明示させる。存在しないツールの呼び出しはアプリ側で拒否し、エラーを戻して再試行させる。
- 無限ループ - 進捗のないまま同じ推論と行動を繰り返す。対策として、最大ステップ数の上限を設け、同一ツールを同一引数で連続呼び出しした場合に検知して中断する。停止条件を明確にプロンプトへ記述することも有効である。
- コスト暴走 - ループや過大なコンテキストによりトークン消費が想定を超える。対策として、タスクあたりのトークン・呼び出し回数に上限を設け、履歴を要約してコンテキストを圧縮し、簡単なタスクには軽量モデルを割り当てる。オブザーバビリティで消費を常時監視し、閾値超過でアラートと中断を行う。
これらの失敗モードは相互に関連しており、ループ制限・コスト上限・オブザーバビリティを一体で設計することで、被害を早期に検知・遮断できる。完全な自律よりも、境界を明示した制御された自律を目指すことが、実務で安定運用するための要点である。
関連記事
このテーマの全体像は .NET × AI 活用 完全ガイド にまとめている。あわせて、以下の記事も参照されたい。
エンハンスド株式会社では、AI エージェントを含む AI 機能の実装を支援しています。
- モダンWeb開発支援 & 内製化 - C# と Next.js / Blazor でモダンな開発と内製化を支援
- クラウドネイティブ & 移行 - Azure / AWS でクラウドネイティブな設計と移行を支援
この記事をシェア
関連記事
TensorSharp とは — C# だけで動く GGUF 推論エンジンが llama.cpp に挑む
ローカル LLM のコミュニティ r/LocalLLaMA で、 TensorSharp という .NET 製の推論エンジンが llama.cpp とのベンチマークを公開し、注目を集めました。…
Microsoft Agent Framework Harness とは — LLMを自律エージェントに変える実行基盤
Microsoft は 2026 年 7 月 22 日、 Microsoft Agent Framework の新機能である Agent Harness の一般提供を発表しました。ハーネスは、…
マイクロサービス設計パターンの実践ガイド
マイクロサービスは、サービスを小さく分けること自体が目的ではありません。独立したデプロイと自律的なチーム運営を実現し、変更のリードタイムを短縮するための手段です。一方で、…