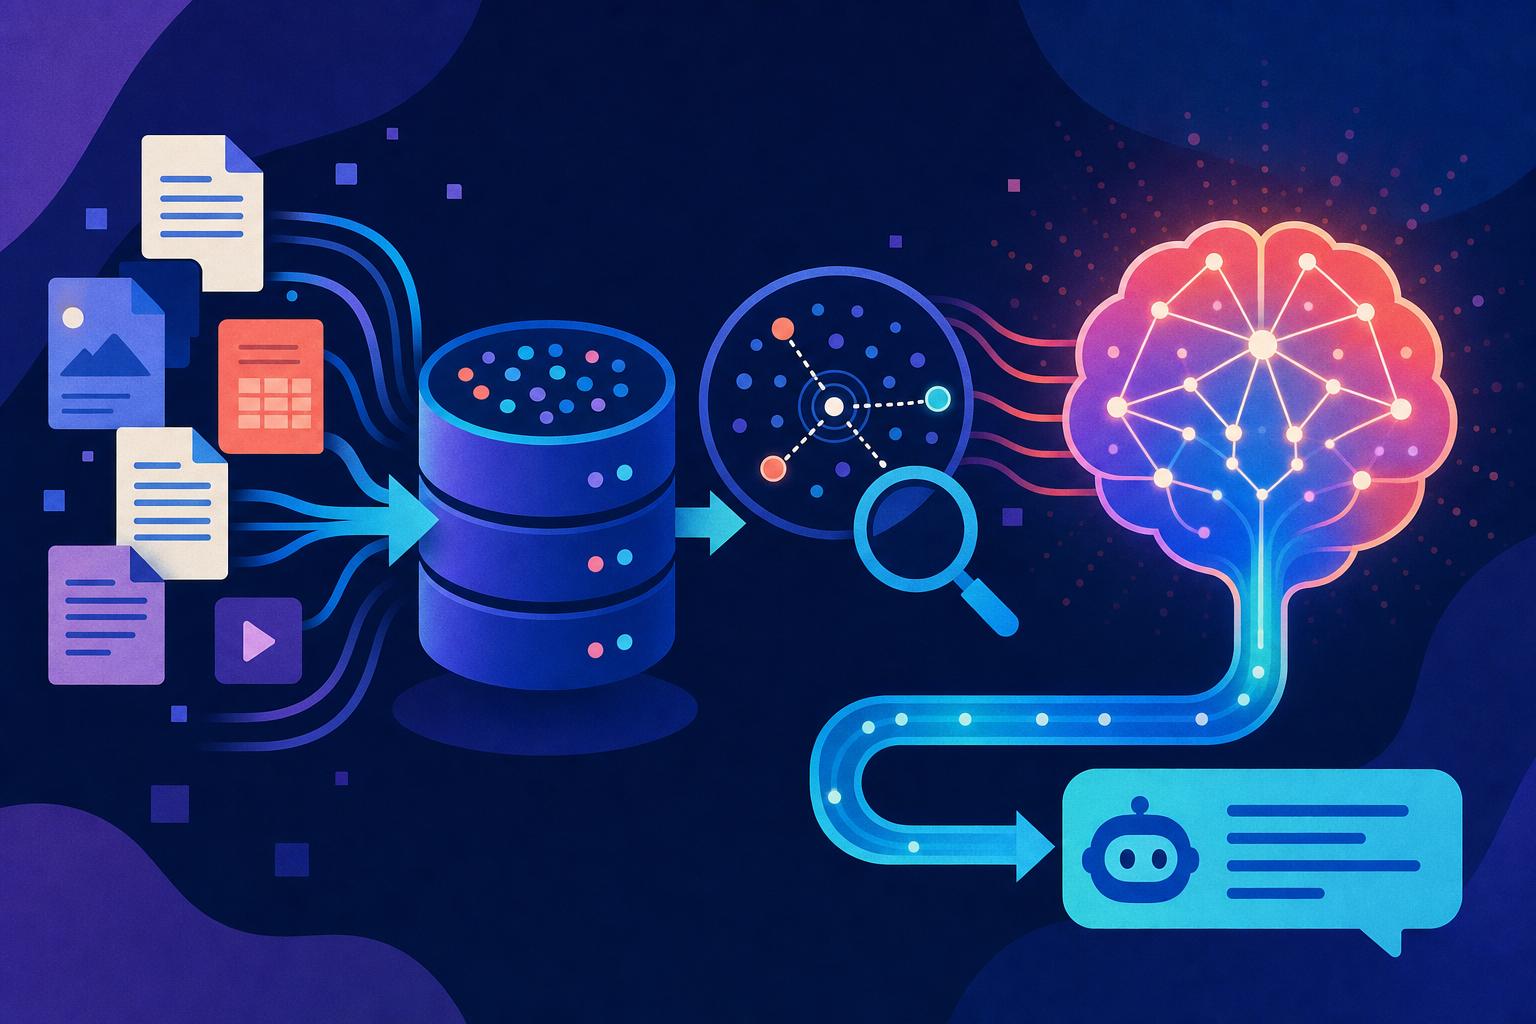
RAG(Retrieval-Augmented Generation、検索拡張生成)は、LLM の生成能力に社内文書などの外部知識を組み合わせ、最新かつ根拠のある回答を生成する手法である。本稿では .NET(C#)と Azure OpenAI を用いて RAG を構築する際の全体像、SDK の選択、ベクトルストアの選び方、実装コード、回答品質を高める工夫、そして本番運用の勘所を整理する。より広い .NET と AI の組み合わせについては.NET × AI 活用 完全ガイドを、RAG そのものの詳細はAzure OpenAI Service で RAG を実装する完全ガイドも参照してほしい。
RAG の全体像
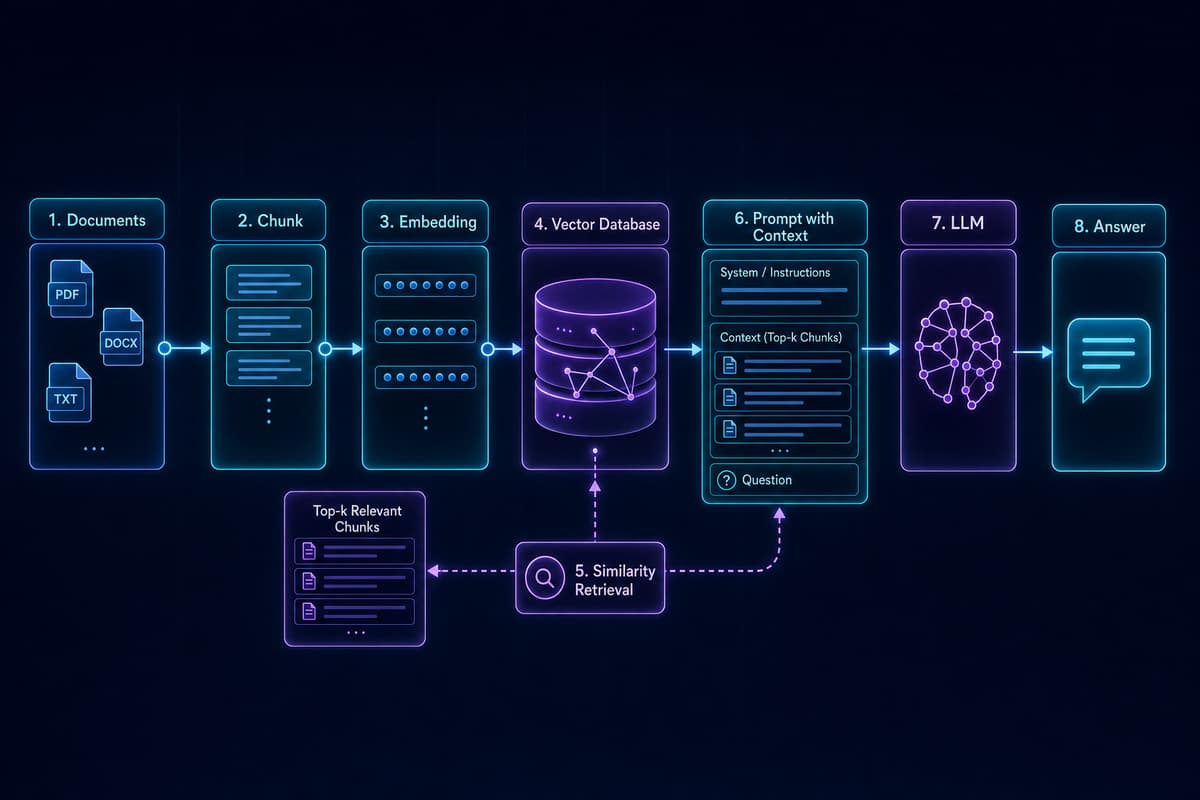
RAG のパイプラインは、事前に文書を検索可能にする「インデックス構築(取り込み)」フェーズと、ユーザーの質問に答える「推論(検索と生成)」フェーズに分かれる。インデックス構築の流れは、文書の取り込み、チャンク分割、埋め込み(embedding)ベクトルの生成、ベクトルストアへの保存という順で進む。推論時は、質問文を埋め込みに変換し、ベクトルストアで類似検索を行って関連チャンクを取得し、それをプロンプトにコンテキストとして付与したうえで LLM が回答を生成する。
この設計の要点は、モデルを再学習させることなく知識を更新できる点にある。文書を差し替えてインデックスを更新すれば、翌日には新しい情報に基づいて回答できる。ファインチューニングと比べて反映が速く、出典の提示によって回答の根拠を検証できることが RAG の実務的な価値である。
.NET での実装方式と SDK の選択
.NET から Azure OpenAI を利用する方法は主に三通りある。用途と抽象度の要件に応じて選択する。
- Azure.AI.OpenAI SDK。Azure OpenAI に直接アクセスする公式クライアント。埋め込み生成とチャット補完を最小の依存関係で扱いたい場合に適する。
- Microsoft.Extensions.AI。
IChatClientやIEmbeddingGeneratorといった共通抽象を提供する .NET の標準的な AI 抽象化レイヤー。プロバイダー差し替えやミドルウェア(キャッシュ、テレメトリ、リトライ)の合成がしやすい。 - Semantic Kernel。プロンプトテンプレート、メモリ、プラグイン、エージェント的なオーケストレーションまで含めて構築したい場合の高水準フレームワーク。RAG の構成要素を宣言的に組み立てられる。
モデルは、埋め込みに Azure OpenAI の text-embedding-3-large または text-embedding-3-small を、生成に gpt-4o などの最新チャットモデルを用いるのが標準的な構成である。text-embedding-3 系はベクトルの次元数を切り詰められるため、精度とストレージコストのトレードオフを調整できる。
ベクトルストアの選択肢
.NET と Azure の組み合わせで現実的な選択肢は次の三つである。
- Azure AI Search。ベクトル検索とキーワード検索(BM25)、セマンティックランカーを備えたマネージド検索サービス。ハイブリッド検索やリランキングを標準機能として利用できるため、RAG の検索基盤として最も汎用性が高い。
- EF Core 10 の Vector Search。既存のリレーショナルデータと同一の DbContext でベクトル列を扱えるため、アプリのデータモデルにベクトルを統合したい場合に適する。詳細はEF Core 10 の Compiled Models と Vector Searchを参照。
- Azure Cosmos DB の vector 検索。グローバル分散と柔軟なスキーマを持つドキュメント DB にベクトルインデックスを併設できる。運用データとベクトルを同居させたいケースで有効である。
埋め込み生成の実装
まず、取り込んだチャンクとユーザーの質問を埋め込みベクトルに変換する。ここでは Microsoft.Extensions.AI の IEmbeddingGenerator を用いた例を示す。Azure.AI.OpenAI を直接使う場合も呼び出しの構造はほぼ同じである。
using Microsoft.Extensions.AI;

// DI で IEmbeddingGenerator<string, Embedding<float>> を登録しておく
public sealed class EmbeddingService(
    IEmbeddingGenerator<string, Embedding<float>> generator)
{
    public async Task<ReadOnlyMemory<float>> EmbedAsync(
        string text,
        CancellationToken ct = default)
    {
        // text-embedding-3-large 等のデプロイに対して埋め込みを生成
        Embedding<float> embedding =
            await generator.GenerateEmbeddingAsync(text, cancellationToken: ct);

        return embedding.Vector;
    }
}
チャンクの埋め込みはインデックス構築時に一度だけ生成してベクトルストアに保存する。質問側の埋め込みは推論のたびに生成するため、後述するキャッシュの対象になりやすい。
ベクトル検索と生成
取得したコンテキストをプロンプトに付与してチャット補完を呼び出す。ここでは Azure AI Search でベクトル検索を行い、その結果を IChatClient に渡す流れを示す。
using Azure.Search.Documents;
using Azure.Search.Documents.Models;
using Microsoft.Extensions.AI;

public sealed class RagService(
    SearchClient search,
    EmbeddingService embedder,
    IChatClient chat)
{
    public async Task<string> AskAsync(string question, CancellationToken ct = default)
    {
        // 1. 質問を埋め込みに変換
        ReadOnlyMemory<float> queryVector = await embedder.EmbedAsync(question, ct);

        // 2. ベクトル検索で関連チャンクを取得(ハイブリッド検索も可)
        var options = new SearchOptions
        {
            Size = 5,
            VectorSearch = new()
            {
                Queries =
                {
                    new VectorizedQuery(queryVector)
                    {
                        KNearestNeighborsCount = 5,
                        Fields = { "contentVector" }
                    }
                }
            }
        };

        SearchResults<SearchDocument> results =
            await search.SearchAsync<SearchDocument>(question, options, ct);

        var chunks = new List<string>();
        await foreach (SearchResult<SearchDocument> r in results.GetResultsAsync())
        {
            chunks.Add($"[出典: {r.Document["source"]}] {r.Document["content"]}");
        }

        string context = string.Join("\n\n", chunks);

        // 3. コンテキストを付与して生成
        var messages = new List<ChatMessage>
        {
            new(ChatRole.System,
                "以下のコンテキストのみを根拠に回答し、該当情報が無ければ不明と答え、" +
                "回答には出典を併記すること。"),
            new(ChatRole.User, $"コンテキスト:\n{context}\n\n質問: {question}")
        };

        ChatResponse response = await chat.GetResponseAsync(messages, cancellationToken: ct);
        return response.Text;
    }
}
キーワード引数(question)とベクトルクエリを同時に渡すことで、Azure AI Search はハイブリッド検索として動作する。システムプロンプトでコンテキスト外の推測を禁じ、出典併記を要求している点が、ハルシネーションを抑える最初の防波堤になる。
回答品質を高める工夫
RAG の品質は、生成モデルよりも検索の精度に強く依存する。以下の観点を段階的に組み込むと効果が大きい。
- チャンク設計。文脈が途切れないよう見出しや段落の意味単位で分割し、隣接チャンクを一定量オーバーラップさせる。過度に大きいチャンクは検索のノイズを増やし、過度に小さいチャンクは文脈を失う。
- ハイブリッド検索。ベクトル検索は意味的な近さに、キーワード検索は固有名詞や型番などの厳密一致に強い。両者を組み合わせることで取りこぼしを減らせる。
- リランキング。一次検索で多めに取得し、セマンティックランカーやクロスエンコーダで並べ替えてから上位のみをプロンプトに渡す。文脈長とコストを抑えつつ関連度を高められる。
- 引用の付与。各チャンクに出典メタデータを持たせ、回答に出典を併記させる。利用者が根拠を検証でき、信頼性が向上する。
- ハルシネーション対策。コンテキスト外の回答を禁じ、根拠が無い場合は「不明」と答えさせる。取得結果が空の場合は生成をスキップするガードも有効である。
- 評価。想定質問と正解のデータセットを用意し、検索のヒット率(recall)と回答の正確性・根拠性を定期的に測定する。プロンプトやチャンク戦略の変更を回帰なく比較できる。
本番運用の勘所
RAG を本番で安定運用するには、コスト・レイテンシ・セキュリティの三点を設計段階から織り込む必要がある。
- コスト。埋め込みの再生成はインデックス更新分だけに限定し、生成モデルへ渡すコンテキスト量をリランキングで絞る。埋め込み次元数を落とせばストレージと検索コストも下げられる。
- レイテンシ。埋め込み生成、検索、生成の各段はネットワーク往復を伴う。ストリーミング応答で体感待ち時間を短縮し、検索の並列化やタイムアウト設定でテールレイテンシを抑える。
- キャッシュ。頻出質問の埋め込みや検索結果、生成結果をキャッシュする。Microsoft.Extensions.AI の分散キャッシュミドルウェアを噛ませれば、アプリコードを変えずにキャッシュを差し込める。
- セキュリティ。API キーを避け、Managed Identity と Microsoft Entra ID による認証を用いる。文書のアクセス権を検索フィルタに反映し、利用者が閲覧権限を持つチャンクだけを取得させる。データが Azure のテナント境界内に留まることを確認し、必要に応じてプライベートエンドポイントで通信経路を閉じる。
Azure OpenAI の基本的な構成やモデル選定についてはAzure OpenAI Service 活用ガイドも併せて確認すると、全体の構成判断がしやすくなる。
まとめ
.NET と Azure OpenAI による RAG は、取り込みから生成までを Microsoft.Extensions.AI や Semantic Kernel の抽象化、Azure AI Search などのベクトルストアで組み合わせて構築できる。品質は検索精度に、運用の成否はコスト・レイテンシ・セキュリティの設計に左右される。小さく作って評価データで測定しながら、チャンク設計とハイブリッド検索、リランキングを段階的に強化していくのが堅実な進め方である。
エンハンスド株式会社では、Azure OpenAI を用いた RAG や AI 機能の実装を支援しています。
- モダンWeb開発支援 & 内製化 - C# と Next.js / Blazor でモダンな開発と内製化を支援
- クラウドネイティブ & 移行 - Azure / AWS でクラウドネイティブな設計と移行を支援
この記事をシェア
関連記事
.NET × AI 活用 完全ガイド — アプリ組み込みからAI駆動開発まで
AI を「アプリに組み込む」側と、AI で「開発そのものを速くする」側——その両方をまとめた入り口ページです。 Azure OpenAI や RAG の実装、各種 LLM API の統合、…
Azure OpenAI と AI Search で作る RAG の実装ガイド
大規模言語モデルは一般的な知識には強い一方で、社内規程や製品仕様、契約書といった組織固有の情報は持ちません。この差を埋める手法が RAG(Retrieval-Augmented Generation、…
TensorSharp とは — C# だけで動く GGUF 推論エンジンが llama.cpp に挑む
ローカル LLM のコミュニティ r/LocalLLaMA で、 TensorSharp という .NET 製の推論エンジンが llama.cpp とのベンチマークを公開し、注目を集めました。…