大規模言語モデルは一般的な知識には強い一方で、社内規程や製品仕様、契約書といった組織固有の情報は持ちません。この差を埋める手法が RAG(Retrieval-Augmented Generation、検索拡張生成)です。質問に関連する社内文書を検索して取り出し、その内容をプロンプトに添えたうえでモデルに回答させることで、根拠を伴った最新の回答を得られます。本稿では Azure OpenAI と Azure AI Search を用いた RAG の設計と実装を、2026年時点の構成にもとづいて解説します。
RAG とは何か
RAG は、モデルの内部知識だけに頼らず、外部の知識ソースを検索して回答の根拠とするアプローチです。モデルを再学習(ファインチューニング)せずに知識を更新できるため、文書を差し替えるだけで回答内容を最新化できます。導入の主な利点は次の3点です。
- 鮮度 — 検索対象の文書を更新すれば、追加学習なしで回答へ即座に反映されます。
- 根拠の提示 — どの文書のどの箇所を参照したかを出典(citation)として示せます。
- 領域適応 — 社内の専門用語や独自プロセスを、検索で補うことで正確に扱えます。
ファインチューニングが「モデルの振る舞いや口調を変える」手法であるのに対し、RAG は「モデルに与える知識を差し込む」手法です。両者は排他ではありませんが、社内知識の活用という目的であれば、まず RAG から検討するのが定石です。
アーキテクチャの全体像
2026年現在、Azure OpenAI は Azure AI Foundry に統合され、モデルのデプロイや評価、監視を一貫した基盤上で扱えるようになっています。RAG を構成する主要なマネージドサービスは次の2つです。
- Azure OpenAI(AI Foundry 上で提供) — 埋め込み生成と回答生成を担当します。埋め込みは text-embedding-3-large もしくは text-embedding-3-small、生成は GPT-4.1 や GPT-5 系のモデルを利用します。
- Azure AI Search — 旧称 Azure Cognitive Search から改称された検索基盤です。ベクトル検索、キーワード検索、そして両者を束ねるハイブリッド検索に対応し、セマンティックランカーによる再ランクも備えます。
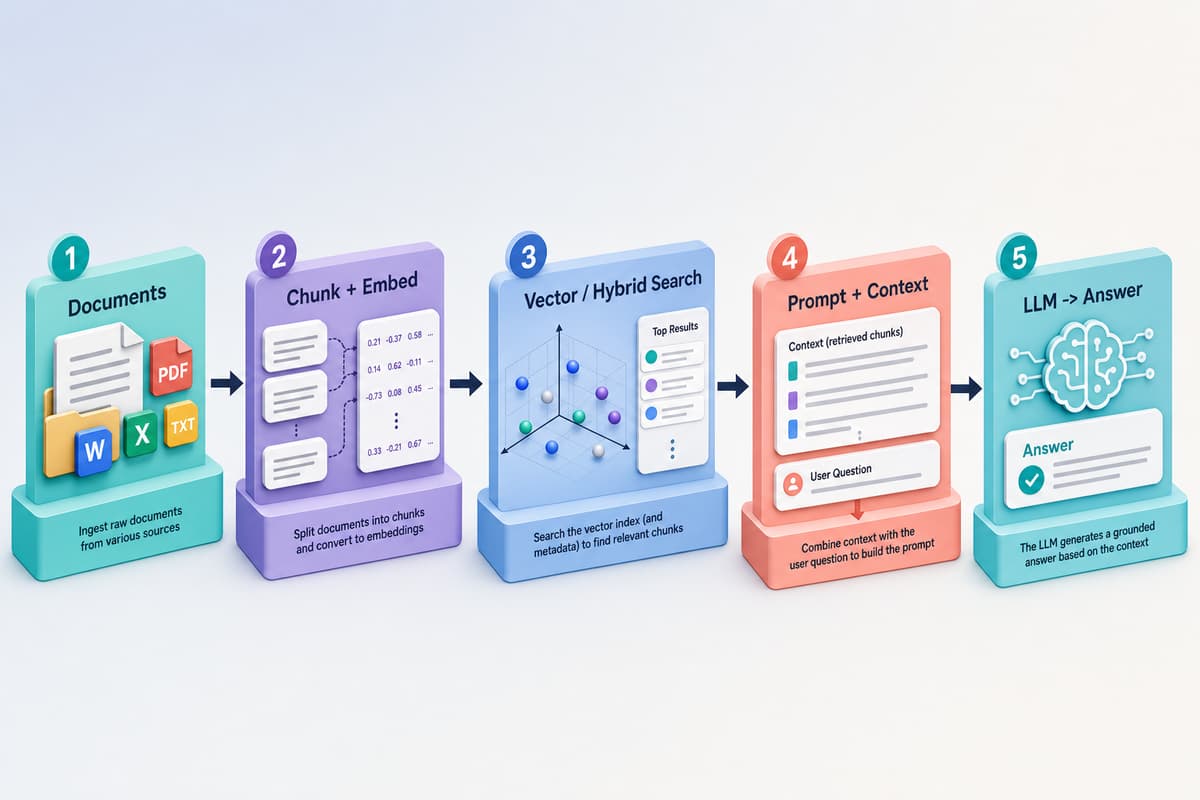
処理の流れは、事前に文書を検索インデックスへ取り込む「取り込みパイプライン」と、実行時に質問へ回答する「推論パイプライン」の二段に分かれます。取り込み側ではドキュメントをチャンクに分割し、埋め込みベクトルを付与してインデックスへ格納します。推論側では、質問をベクトル化して関連チャンクを検索し、再ランクで絞り込んだうえでプロンプトに文脈として注入し、モデルに出典付きで回答させます。
統合ベクトル化で取り込みを簡素化する
チャンク分割と埋め込み生成を自前で実装することもできますが、Azure AI Search の統合ベクトル化(integrated vectorization)を使うと、この工程をインデクサーのスキルセットとして宣言的に構成できます。Blob Storage などのデータソースを指定すれば、テキスト抽出、チャンク分割、埋め込み呼び出しまでを検索サービス側が実行し、インデックスへ書き込みます。運用対象のコードを減らせるため、まずはこの方式で骨格を組み、要件に応じて個別工程を差し替える進め方が扱いやすいでしょう。
実装手順
ここでは C# の Azure SDK を用い、推論パイプラインの中核となる「ハイブリッド検索」と「回答生成」を示します。まず、質問文をベクトル化しつつキーワード検索も併用し、セマンティックランカーで再ランクする検索処理です。
using Azure;
using Azure.Search.Documents;
using Azure.Search.Documents.Models;

// 質問ベクトルとキーワードを組み合わせたハイブリッド検索+セマンティック再ランク
public async Task<List<SearchDocument>> SearchAsync(
    SearchClient searchClient,
    string query,
    float[] queryVector,
    int topK = 5)
{
    var options = new SearchOptions
    {
        Size = topK,
        QueryType = SearchQueryType.Semantic,
        SemanticSearch = new SemanticSearchOptions
        {
            SemanticConfigurationName = "default"
        },
        VectorSearch = new VectorSearchOptions
        {
            Queries =
            {
                new VectorizedQuery(queryVector)
                {
                    KNearestNeighborsCount = 50,
                    Fields = { "contentVector" }
                }
            }
        }
    };
    options.Select.Add("id");
    options.Select.Add("title");
    options.Select.Add("content");

    // searchText にキーワードを渡すことでベクトルとキーワードのハイブリッド検索になる
    var response = await searchClient.SearchAsync<SearchDocument>(query, options);

    var results = new List<SearchDocument>();
    await foreach (var item in response.Value.GetResultsAsync())
    {
        results.Add(item.Document);
    }
    return results;
}
検索で得たチャンクを文脈としてまとめ、システムメッセージで根拠にもとづく回答を指示したうえで生成モデルを呼び出します。次のように、参照した文書を明示させることで出典提示につなげます。
using Azure.AI.OpenAI;
using OpenAI.Chat;

public async Task<string> GenerateAnswerAsync(
    ChatClient chatClient,
    string question,
    IEnumerable<SearchDocument> sources)
{
    var context = string.Join("\n\n", sources.Select((s, i) =>
        $"[{i + 1}] {s["title"]}\n{s["content"]}"));

    var systemPrompt =
        "あなたは社内向けの回答アシスタントです。" +
        "以下のコンテキストに含まれる情報だけを根拠に回答してください。" +
        "コンテキストに根拠がない場合は、その旨を明確に伝え、推測で補わないでください。" +
        "回答の末尾に、参照した番号付き出典を必ず示してください。";

    var messages = new List<ChatMessage>
    {
        new SystemChatMessage(systemPrompt),
        new UserChatMessage($"コンテキスト:\n{context}\n\n質問: {question}")
    };

    var options = new ChatCompletionOptions { Temperature = 0.2f };
    var completion = await chatClient.CompleteChatAsync(messages, options);
    return completion.Value.Content[0].Text;
}
生成の温度(Temperature)は低めに設定し、コンテキスト外の内容を作り出さないようシステムメッセージで制約する点が要点です。取り込み側では、同じ埋め込みモデルで文書チャンクをベクトル化してインデックスへ格納しておきます。質問と文書で異なる埋め込みモデルを混在させると検索精度が落ちるため、両者は必ず同一のモデルに揃えます。
まず動かすなら On Your Data
検索と生成を個別に実装せずに素早く試したい場合は、Azure OpenAI の「On Your Data(データに基づく回答)」機能が有効です。Azure AI Search のインデックスをデータソースとして指定するだけで、検索・文脈注入・出典付き回答までをサービス側が担います。プロトタイプや小規模用途はこの機能で立ち上げ、細かな検索制御や独自のリランクが必要になった段階で自前パイプラインへ移行する、という段階的な進め方が現実的です。
検索精度を上げる工夫
RAG の回答品質は、生成モデルよりも検索段階の設計に大きく左右されます。関連文書を取りこぼせば、モデルがどれほど優秀でも正しい回答は返りません。精度を高めるうえで押さえたい観点は次のとおりです。
チャンク設計
チャンクが大きすぎると1つのベクトルに複数の話題が混ざり、検索の的中率が下がります。小さすぎると文脈が断片化し、回答に必要な情報が分散します。目安として、日本語では数百文字程度を基準に、段落や見出しといった文書構造の区切りを尊重して分割します。前後のチャンクを一定量重ねるオーバーラップを設けると、境界で文脈が途切れる問題を緩和できます。表や見出しは構造を保ったまま扱い、単なる文字列へ潰さないことも重要です。
ハイブリッド検索とリランク
ベクトル検索は意味的な近さに強い一方、型番や固有名詞のような厳密一致には弱い傾向があります。キーワード検索と組み合わせるハイブリッド検索により、両者の弱点を補えます。さらにセマンティックランカーで上位候補を意味的な関連度で並べ替えると、プロンプトへ渡す少数のチャンクの質が上がり、回答の的確さが向上します。
メタデータの活用
作成日、作成部署、公開範囲、承認状態といったメタデータをインデックスに持たせ、検索時のフィルターに使うと精度と安全性の双方を高められます。たとえば「最新の情報」という要求に対して承認済みかつ新しい文書へ絞り込む、閲覧権限に応じて対象文書を制限する、といった制御が可能になります。
回答品質と評価
RAG で最も警戒すべきは、検索結果に根拠がないにもかかわらずモデルがもっともらしい回答を作り出すハルシネーションです。これを抑えるには、コンテキスト外の生成を禁じるシステムメッセージ、根拠が無い場合に「該当情報が見つかりません」と答えさせる指示、そして出典提示の強制が基本となります。回答が実際に検索チャンクへ裏づけられているか(グラウンディング)を検証する姿勢が欠かせません。
品質は感覚ではなく指標で継続的に測ります。代表的な評価軸は、回答が根拠文書に忠実か(忠実性)、必要な情報を検索が取り出せているか(検索の再現率)、そして質問に対する回答の妥当性です。Azure AI Foundry には生成品質を評価する機能が用意されており、代表的な質問と期待回答のセットを用いて、モデルやチャンク設計を変更するたびに回帰的にスコアを比較できます。評価データを整備しておくことが、改善のたびに品質を落とさないための土台になります。
運用とセキュリティ
社内情報を扱う以上、認証・ネットワーク・アクセス制御を最初から設計へ織り込みます。API キーによる認証は運用負荷と漏洩リスクを伴うため、Microsoft Entra ID と Managed Identity を用いたキーレス構成を推奨します。アプリケーションのマネージド ID に対して、Azure OpenAI と Azure AI Search それぞれへ必要最小限のロールを RBAC で割り当てれば、資格情報をコードや設定に埋め込まずに済みます。
- キーレス認証 — Managed Identity と RBAC により、API キーを排し最小権限で各サービスへ接続します。
- ネットワーク分離 — Private Endpoint を用いて通信を仮想ネットワーク内に閉じ、公衆インターネットからのアクセスを遮断します。
- 監査とアクセス制御 — 誰がいつ何を照会したかを記録し、文書のメタデータと閲覧権限にもとづいて回答対象を制限します。
データの取り扱いについても正しく理解しておく必要があります。Azure OpenAI では、プロンプトや生成結果が基盤モデルの学習に使われることはなく、入力データは顧客の管理下にとどまります。この点は、社内データの活用にあたって情報システム部門や法務部門の合意を得るうえでの前提となります。
まとめ
Azure OpenAI と Azure AI Search を組み合わせた RAG は、モデルの再学習に頼らず社内知識を回答へ反映できる、実運用に耐える構成です。品質を左右するのは検索段階の設計であり、チャンク設計、ハイブリッド検索とリランク、メタデータの活用が精度向上の核となります。加えて、グラウンディングと定量評価によるハルシネーション対策、キーレス認証と Private Endpoint によるセキュリティ確保を初期段階から組み込むことで、安心して展開できる基盤になります。まずは On Your Data や統合ベクトル化で小さく立ち上げ、評価データにもとづいて段階的に自前パイプラインへ発展させる進め方が堅実です。
エンハンスド株式会社では、RAG や生成 AI の導入を、要件定義からアーキテクチャ設計、Azure 上での構築、評価・運用体制の整備まで一貫してご支援しています。社内文書の活用や既存システムとの連携でお困りの際は、実現可能性の相談段階からお気軽にお問い合わせください。
このテーマの全体像は .NET × AI 活用 完全ガイド にまとめています。
この記事をシェア
関連記事
.NET × Azure OpenAI で作る RAG 実装ガイド
RAG(Retrieval-Augmented Generation、検索拡張生成)は、LLM の生成能力に社内文書などの外部知識を組み合わせ、最新かつ根拠のある回答を生成する手法である。…
.NET × AI 活用 完全ガイド — アプリ組み込みからAI駆動開発まで
AI を「アプリに組み込む」側と、AI で「開発そのものを速くする」側——その両方をまとめた入り口ページです。 Azure OpenAI や RAG の実装、各種 LLM API の統合、…
Azure OpenAI Service 活用ガイド — 企業で安全に生成AIを動かす
生成AIを業務に組み込みたいという要望は多くの企業で共通しています。一方で、入力したデータが外部に残らないか、誰がどのように利用したかを追跡できるか、…