C#(.NET)は生産性とエコシステムに優れた言語ですが、計算量の多い数値処理やバイナリ解析、既存の高品質なライブラリがすべて Rust に揃っている領域では、その一部を Rust に委ねたくなる場面があります。両者は C ABI(Application Binary Interface)を介した FFI(Foreign Function Interface)で接続でき、アプリケーション全体を書き換えることなく、性能が要求される中核だけをネイティブに置き換えられます。
本記事では .NET 10 を前提に、Rust 側で cdylib を作って C ABI を公開する方法から、C# 側の LibraryImport ソースジェネレータによる呼び出し、プリミティブ・文字列・構造体・配列・スパンのマーシャリング、メモリ所有権とエラーハンドリングの設計、ビルドと配布までを、Rust と C# のコードを対にして解説します。
なぜ C# に Rust を組み合わせるのか
C# 単体でも十分に速く、Native AOT やスパンによるゼロコピー最適化も進んでいます。それでも Rust を併用する動機は、大きく次の三つに整理できます。
- 性能 — GC を持たず、SIMD や並列処理を細かく制御できるため、画像処理・暗号・パーサなど CPU バウンドな処理でネイティブ速度を引き出せます。
- メモリ安全 — 所有権と借用の検査により、C/C++ で書かれたネイティブ処理にありがちなメモリ破壊やデータ競合をコンパイル時に排除できます。安全性を保ったままネイティブ層を持てる点が、従来の C 相互運用との決定的な違いです。
- 既存クレートの活用 — 圧縮、暗号、正規表現、画像コーデックなど、Rust のクレートエコシステムには成熟した実装が揃っています。これらを薄いラッパー越しにそのまま .NET から利用できます。
逆に、UI やビジネスロジック、データアクセス、Web API といった層は C# が得意とするところです。境界を明確に引き、性能が支配的な処理だけを Rust に渡すのが、保守性と速度を両立する現実的な設計になります。
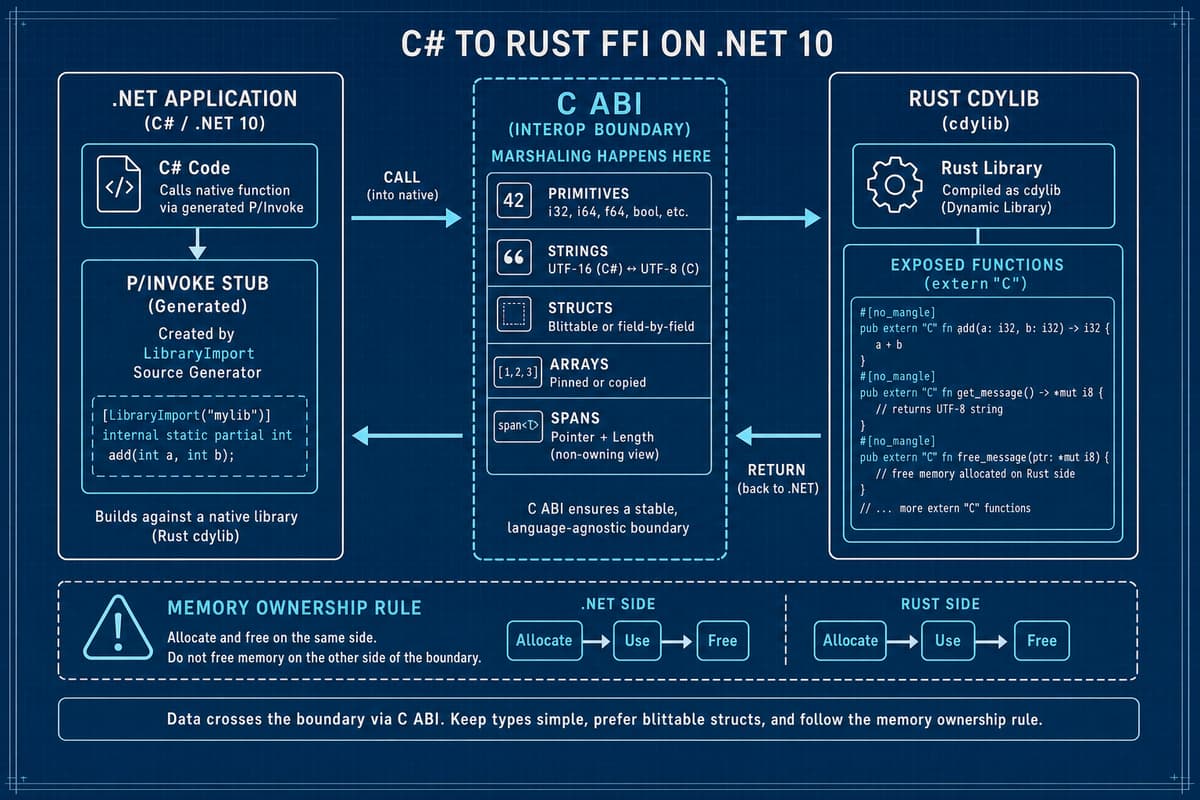
Rust 側で C ABI を公開する
Rust から C 互換の関数を公開するには、ライブラリの種別を cdylib にし、関数を extern "C" で宣言してシンボル名を保持します。まず Cargo.toml でクレート種別を指定します。
[lib]
crate-type = ["cdylib"]

[profile.release]
lto = true
codegen-units = 1
最小の関数は次のコードです。extern "C" は呼び出し規約を C に合わせ、シンボル名のマングリングを抑止する属性を付けて公開名を固定します。Rust 2024 エディションでは no_mangle が unsafe 属性となり、#[unsafe(no_mangle)] と書く点に注意してください。
// src/lib.rs
#[unsafe(no_mangle)]
pub extern "C" fn add(a: i32, b: i32) -> i32 {
    a + b
}
ポインタを受け取る関数は unsafe extern "C" とし、ポインタが有効であることは呼び出し側の責任として明示します。なお extern "C" 関数の内部で panic! が発生した場合、Rust 1.81 以降は境界をまたぐ前にプロセスが abort します。パニックを回復可能なエラーとして扱いたいときは、後述するステータスコード方式と std::panic::catch_unwind を組み合わせて、境界の内側でパニックを封じ込めます。
C# から呼び出す(LibraryImport と DllImport の違い)
.NET 10 では、P/Invoke の宣言に LibraryImport ソースジェネレータを使うのが標準的な選択です。従来の DllImport がマーシャリングのスタブを実行時に IL で生成するのに対し、LibraryImport はコンパイル時に安全なマーシャリングコードを生成します。リフレクションに依存しないため Native AOT と相性がよく、生成コードを追って挙動を確認できる利点もあります。
宣言する型とメソッドは partial かつ static にする必要があります。先ほどの add を呼び出す例は次のとおりです。
using System.Runtime.InteropServices;

internal static partial class Native
{
    [LibraryImport("rustcore")]
    public static partial int add(int a, int b);
}

int sum = Native.add(2, 3); // 5
ライブラリ名 "rustcore" は拡張子なしで指定します。ランタイムがプラットフォームごとに rustcore.dll(Windows)、librustcore.so(Linux)、librustcore.dylib(macOS)へ解決します。DllImport は既存資産との互換性のために引き続き有効ですが、新規実装では LibraryImport を第一候補にし、対応していない特殊なマーシャリングが必要な箇所だけ DllImport を使うのが妥当です。解決先を細かく制御したい場合は NativeLibrary.SetDllImportResolver でカスタムローダを差し込めます。
境界を越えるデータのマーシャリング
FFI 設計の要は、境界でどのようにデータを表現するかです。ここではプリミティブ・文字列・構造体・配列/スパンの順に、Rust と C# の対応を示します。
文字列
文字列は所有権が絡むため最も注意が必要です。C# から渡すときは UTF-8 でマーシャリングし、Rust から返すときは CString::into_raw で所有権を放棄したポインタを返して、解放用の関数を別に用意します。
use std::ffi::{c_char, CStr, CString};

#[unsafe(no_mangle)]
pub unsafe extern "C" fn greet(name: *const c_char) -> *mut c_char {
    let name = unsafe { CStr::from_ptr(name) }.to_string_lossy();
    let msg = format!("Hello, {name}!");
    CString::new(msg).unwrap().into_raw()
}

#[unsafe(no_mangle)]
pub unsafe extern "C" fn free_string(s: *mut c_char) {
    if s.is_null() { return; }
    drop(unsafe { CString::from_raw(s) });
}
internal static partial class Native
{
    [LibraryImport("rustcore", StringMarshalling = StringMarshalling.Utf8)]
    public static partial IntPtr greet(string name);

    [LibraryImport("rustcore")]
    public static partial void free_string(IntPtr s);
}

IntPtr ptr = Native.greet("Rust");
string message = Marshal.PtrToStringUTF8(ptr)!;
Native.free_string(ptr); // 確保した Rust 側の関数で解放する
構造体・配列・スパン
構造体は Rust 側で #[repr(C)] を付けてメモリレイアウトを C 互換に固定し、C# 側で [StructLayout(LayoutKind.Sequential)] のフィールド順を一致させます。配列は「先頭ポインタ+要素数」の形で渡すのが基本で、C# の ReadOnlySpan<T> を使うと LibraryImport がスパンをピン留めしてポインタとして渡すため、余分なコピーが発生しません。次は倍精度配列から統計値を計算し、結果を構造体で返す例です。
#[repr(C)]
pub struct Stats {
    count: usize,
    mean: f64,
    max: f64,
}

#[unsafe(no_mangle)]
pub unsafe extern "C" fn compute_stats(ptr: *const f64, len: usize) -> Stats {
    let data = unsafe { std::slice::from_raw_parts(ptr, len) };
    let sum: f64 = data.iter().sum();
    let max = data.iter().copied().fold(f64::MIN, f64::max);
    let count = data.len();
    Stats {
        count,
        mean: if count == 0 { 0.0 } else { sum / count as f64 },
        max,
    }
}
[StructLayout(LayoutKind.Sequential)]
internal struct Stats
{
    public nuint Count;
    public double Mean;
    public double Max;
}

internal static partial class Native
{
    [LibraryImport("rustcore")]
    public static partial Stats compute_stats(ReadOnlySpan<double> data, nuint len);
}

double[] values = { 1.0, 2.0, 3.0, 4.0 };
Stats s = Native.compute_stats(values, (nuint)values.Length);
usize と nuint、i32 と int、f64 と double のように、ビット幅と符号を厳密に一致させることが破綻を防ぐ鍵です。bool は Rust では 1 バイトですが、LibraryImport の既定マーシャリングは 4 バイトの Win32 BOOL のため、Rust の bool に合わせるなら [MarshalAs(UnmanagedType.U1)] を明示します。ポインタから作った slice は Rust がその領域を所有していない点にも注意し、境界を越えて生存させないようにします。
メモリ所有権とエラーハンドリングの設計
FFI で最も事故が起きやすいのが、確保した側と解放する側の食い違いです。原則として「確保した言語で解放する」を徹底し、Rust が into_raw や Box::into_raw で返したポインタは、必ず対になる Rust 側の解放関数へ戻します。C# 側では IDisposable や SafeHandle でその解放を確実に呼び出す形にまとめると、リークと二重解放を構造的に防げます。
エラーは、境界を越えて例外を投げるのではなく、戻り値のステータスコードと出力パラメータで表現するのが堅実です。次はテキストを整数に変換し、成否をコードで返す例です。C# 側では成功以外を例外へ変換します。
use std::ffi::{c_char, CStr};

#[repr(i32)]
pub enum Status { Ok = 0, InvalidUtf8 = 1, ParseError = 2 }

#[unsafe(no_mangle)]
pub unsafe extern "C" fn parse_i64(text: *const c_char, out: *mut i64) -> i32 {
    let text = match unsafe { CStr::from_ptr(text) }.to_str() {
        Ok(s) => s,
        Err(_) => return Status::InvalidUtf8 as i32,
    };
    match text.trim().parse::<i64>() {
        Ok(v) => { unsafe { *out = v; } Status::Ok as i32 }
        Err(_) => Status::ParseError as i32,
    }
}
internal static partial class Native
{
    [LibraryImport("rustcore", StringMarshalling = StringMarshalling.Utf8)]
    public static partial int parse_i64(string text, out long value);
}

if (Native.parse_i64("42", out long value) == 0)
    Console.WriteLine(value);
else
    throw new FormatException("Rust 側での数値変換に失敗しました。");
この方式なら、パニックによる abort や境界越えの未定義動作を避けつつ、失敗理由を呼び出し側へ明確に伝えられます。より詳細な情報が必要な場合は、エラーメッセージ文字列を Rust が確保して返し、解放関数を対で用意する構成に拡張します。
ビルドと配布
Rust 側は cargo build --release で target/release にネイティブライブラリを生成します。C# プロジェクトからは、生成物を出力ディレクトリへコピーするのが最も単純です。csproj に次のような項目を追加します。
<ItemGroup>
  <None Include="../rustcore/target/release/rustcore.dll"
        Link="rustcore.dll"
        CopyToOutputDirectory="PreserveNewest" />
</ItemGroup>
複数プラットフォームへ配布する場合は、各 OS 向けにクロスビルドし、RID(win-x64、linux-x64、osx-arm64 など)ごとに runtimes/<rid>/native/ へ配置します。この規約に従っておくと、NuGet パッケージ化したときにランタイムが実行環境に合ったライブラリを自動選択します。ビルドは Rust と .NET のツールチェーンを両方セットアップした CI で、OS マトリクスを回して各 RID のバイナリを揃えるのが定石です。
手作業のバインディング記述を減らしたい場合は、Rust のソースから C# の P/Invoke 定義を生成する csbindgen を併用すると、構造体や関数シグネチャの同期ミスを抑えられます。ただし、生成された定義もこれまで述べたマーシャリングと所有権の原則の上に成り立っている点は変わりません。
まとめ
C# と Rust の FFI 連携は、アプリケーション全体の生産性を保ったまま、性能とメモリ安全が要求される中核だけをネイティブに置き換えるための現実的な手段です。Rust 側は cdylib と extern "C" で C ABI を公開し、C# 側は LibraryImport で安全なマーシャリングコードを生成する。境界ではデータ型を厳密に一致させ、所有権は「確保した側で解放する」を徹底し、エラーはステータスコードで受け渡す。この四点を守れば、境界越えで起きがちな事故の大半を設計段階で排除できます。まずは性能が支配的なひとつの関数から Rust に切り出し、計測しながら適用範囲を広げていくのが堅実な進め方です。
エンハンスド株式会社では、高性能なネイティブ連携を含む .NET 開発を支援しています。Rust をはじめとするネイティブ処理の切り出し、FFI 境界の設計、マルチプラットフォームのビルドと配布、既存システムへの段階的な組み込みまで、システムの状況に合わせてご提案します。性能改善やハイブリッド構成の技術相談がございましたら、お気軽にお問い合わせください。
関連リンク
- .NET LibraryImport ソース生成の公式ドキュメント
- Rust FFI ガイド(The Rustonomicon)
- csbindgen(Rust から C# バインディングを生成)
- Rust FFI Omnibus
関連記事
- TensorSharp とは — C# だけで動く GGUF 推論エンジン
- C# で機械学習モデルを本番運用する(ML.NET と ONNX)
- Span<T> / Memory<T> で書くゼロコピー C#
- .NET 10 Native AOT で高速起動を実現する実践ガイド
よくある質問
C# から Rust を呼び出すことはできますか?
できます。Rust 側で C ABI の関数を公開し、C# 側は LibraryImport(ソース生成)や DllImport(P/Invoke)で呼び出します。ネイティブの性能を保ちつつ、既存の C# 資産と組み合わせられます。
LibraryImport と DllImport の違いは何ですか?
DllImport は実行時にマーシャリングコードを生成しますが、LibraryImport(.NET 7 以降)はコンパイル時にソース生成するため高速で、Native AOT とも互換性があります。新規実装では LibraryImport を推奨します。
FFI 境界でメモリ管理はどう設計すべきですか?
「どちらが確保し、どちらが解放するか」を関数ごとに一方へ定めるのが鉄則です。Rust 側で確保したメモリは Rust 側に解放関数を用意し、C# から明示的に呼び出して二重解放やリークを防ぎます。
.NET 10 の全体像は .NET 10 の新機能完全ガイド にまとめています。
この記事をシェア
関連記事
C# / .NET でトレーディングボットを開発する — 自動取引システムを支える技術的優位性
自動取引システム、いわゆるトレーディングボットは、市場データの受信から売買判断、注文執行、リスク管理までを人手を介さずに回す仕組みです。ミリ秒単位の遅延が結果を左右する一方で、…
C# に Union 型がやってきた — Result 型で安全・簡潔にエラーを扱う
F# や TypeScript を触ったことがある開発者なら、一度は「C# にも 判別共用体(union 型) があれば」と思ったはずです。…
.NET 10 Minimal APIs 実践ガイド
ASP.NET Core の Minimal APIs は、.NET 6 での導入から改良を重ね、.NET 10 の時点で本格的な業務システムにも十分耐える成熟度に達しています。ルーティング、…