機械学習モデルの学習と本番運用では、求められる関心事が大きく異なります。学習時は精度や実験の速さが主眼になりますが、運用時にはレイテンシ、可用性、監視、既存システムとの統合が問われます。多くの企業システムが .NET で構築されている以上、モデルの推論も同じ .NET プロセス内、あるいは同じ運用基盤の上で完結できれば、言語をまたぐ通信やコンテナ構成の複雑さを避けられます。
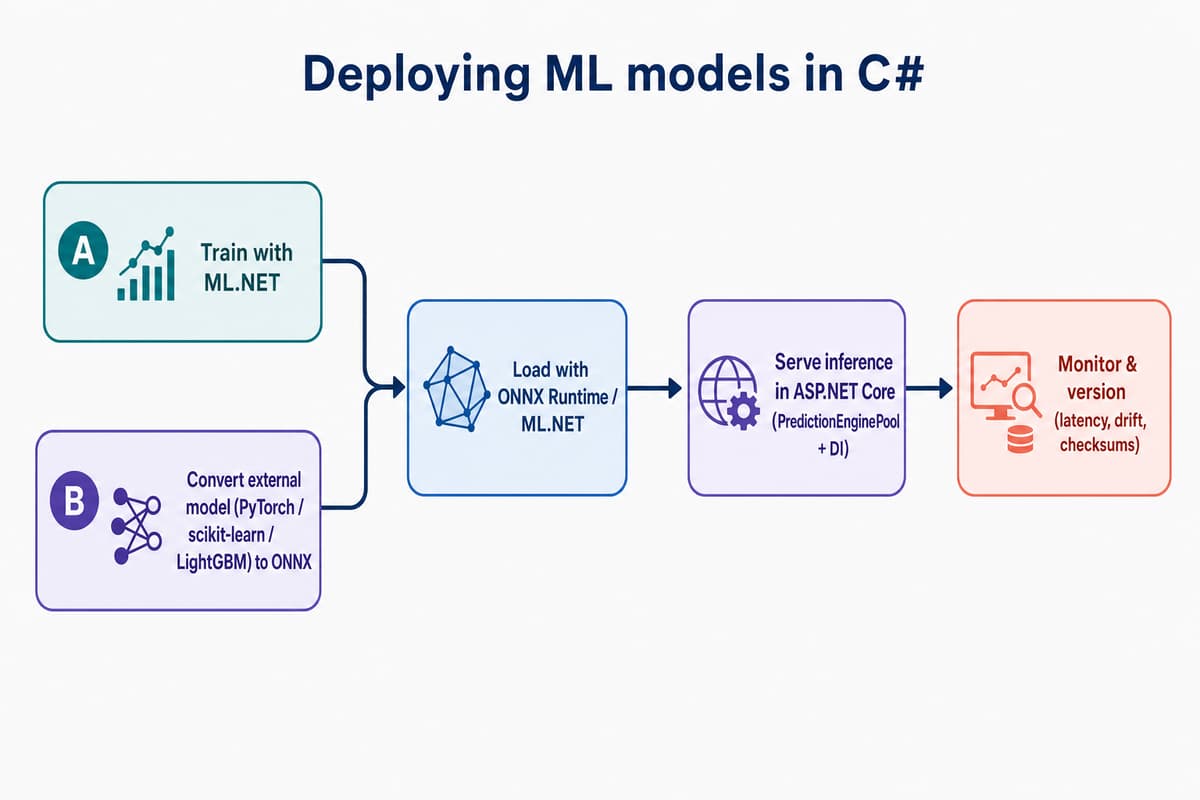
本記事では .NET 10 を前提に、ML.NET でのモデル学習と読み込み、PyTorch や scikit-learn、LightGBM といった外部フレームワークで作ったモデルの ONNX 変換、ONNX Runtime による C# 推論、ASP.NET Core への組み込み、バッチ推論とハードウェアアクセラレーション、そしてバージョン管理と監視までを一通り解説します。
C# で機械学習モデルを本番運用する理由
Python は学習と実験の主戦場ですが、本番の推論を担う先としては必ずしも唯一の選択肢ではありません。すでに ASP.NET Core で API を運用している組織であれば、推論を同じアプリケーションに載せることで得られる利点があります。
- 既存インフラとの統合 — 認証、ロギング、DI、構成管理といった横断的関心事を、既存の .NET の仕組みでそのまま扱えます。
- 型安全な入出力 — モデルの入力スキーマと出力スキーマをクラスとして定義でき、列名の食い違いをコンパイル時やパイプライン構築時に検出しやすくなります。
- 低いプロセス間オーバーヘッド — 推論をインプロセスで実行すれば、別言語のサービスへ HTTP や gRPC で問い合わせる往復コストを避けられます。
選択肢は二つあります。ML.NET でモデルそのものを .NET 上で学習・保存する道と、他フレームワークで学習した資産を ONNX に変換して ONNX Runtime で読み込む道です。実務ではこの二つを併用し、表形式データは ML.NET、深層学習モデルは ONNX という使い分けが現実的です。
ML.NET でのモデル学習と読み込み
ML.NET は前処理から学習、評価、保存までを一貫して扱えるライブラリです。入力と出力をクラスで定義し、変換とトレーナーをパイプラインとして連結します。以下は回帰モデルを学習して保存する最小構成です。
using Microsoft.ML;
using Microsoft.ML.Data;

public class SalesInput
{
    [LoadColumn(0)] public float PreviousSales { get; set; }
    [LoadColumn(1)] public float MarketingSpend { get; set; }
    [LoadColumn(2)] public string ProductCategory { get; set; } = string.Empty;
    [LoadColumn(3), ColumnName("Label")] public float Sales { get; set; }
}

public class SalesPrediction
{
    [ColumnName("Score")] public float PredictedSales { get; set; }
}

public sealed class SalesTrainer
{
    private readonly MLContext _ml = new(seed: 1);

    public void TrainAndSave(string csvPath, string modelPath)
    {
        IDataView data = _ml.Data.LoadFromTextFile<SalesInput>(
            csvPath, hasHeader: true, separatorChar: ',');

        DataOperationsCatalog.TrainTestData split =
            _ml.Data.TrainTestSplit(data, testFraction: 0.2);

        var pipeline = _ml.Transforms.Categorical
            .OneHotEncoding("CategoryEncoded", nameof(SalesInput.ProductCategory))
            .Append(_ml.Transforms.Concatenate("Features",
                nameof(SalesInput.PreviousSales),
                nameof(SalesInput.MarketingSpend),
                "CategoryEncoded"))
            .Append(_ml.Transforms.NormalizeMinMax("Features"))
            .Append(_ml.Regression.Trainers.LightGbm(
                labelColumnName: "Label", featureColumnName: "Features"));

        ITransformer model = pipeline.Fit(split.TrainSet);

        RegressionMetrics metrics = _ml.Regression.Evaluate(
            model.Transform(split.TestSet), labelColumnName: "Label");
        Console.WriteLine($"RMSE={metrics.RootMeanSquaredError:F3} R2={metrics.RSquared:F3}");

        _ml.Model.Save(model, data.Schema, modelPath);
    }
}
保存したモデルは MLContext.Model.Load で復元できます。単発の推論には PredictionEngine が便利ですが、これはスレッドセーフではないため、Web アプリケーションでは後述の PredictionEnginePool を用いてインスタンスを共有・再利用するのが定石です。
外部フレームワークのモデルを ONNX 経由で取り込む
深層学習や勾配ブースティングを Python 側で学習した場合は、ONNX(Open Neural Network Exchange)に変換することで C# から利用できます。ONNX はフレームワーク非依存の中間表現であり、PyTorch、scikit-learn、LightGBM のいずれも変換経路が整備されています。
# PyTorch モデルを ONNX へエクスポート
import torch

model.eval()
dummy = torch.randn(1, 10)
torch.onnx.export(
    model, dummy, "model.onnx",
    input_names=["input"], output_names=["output"],
    dynamic_axes={"input": {0: "batch"}, "output": {0: "batch"}},
    opset_version=17)

# scikit-learn / LightGBM は skl2onnx / onnxmltools を利用
# from skl2onnx import to_onnx
# onx = to_onnx(clf, X_sample.astype(numpy.float32))
変換時は入力次元を動的軸(dynamic axes)として宣言しておくと、推論時に任意のバッチサイズを渡せます。C# 側では ML.NET のパイプラインに ApplyOnnxModel を組み込む方法と、ONNX Runtime を直接使う方法があります。ML.NET に組み込むと前処理や後処理を同じパイプラインで扱えます。
using Microsoft.ML;
using Microsoft.ML.Transforms.Onnx;

public class OnnxInput
{
    [ColumnName("input"), VectorType(10)]
    public float[] Input { get; set; } = new float[10];
}

public class OnnxOutput
{
    [ColumnName("output"), VectorType(1)]
    public float[] Output { get; set; } = System.Array.Empty<float>();
}

public sealed class OnnxPipelineFactory
{
    private readonly MLContext _ml = new();

    public ITransformer Build(string onnxPath)
    {
        var pipeline = _ml.Transforms.ApplyOnnxModel(
            outputColumnNames: new[] { "output" },
            inputColumnNames: new[] { "input" },
            modelFile: onnxPath,
            gpuDeviceId: null,      // GPU を使う場合はデバイス ID を指定
            fallbackToCpu: true);

        IDataView empty = _ml.Data.LoadFromEnumerable(new List<OnnxInput>());
        return pipeline.Fit(empty);
    }
}
ASP.NET Core への組み込み — PredictionEnginePool と DI
Web アプリケーションでは、リクエストごとに PredictionEngine を生成すると生成コストがかさみ、共有すればスレッド安全性の問題が生じます。Microsoft.Extensions.ML パッケージが提供する PredictionEnginePool は、内部でエンジンをプールし、スレッドセーフに再利用するためのものです。DI コンテナへ登録して利用します。
using Microsoft.Extensions.ML;

var builder = WebApplication.CreateBuilder(args);

builder.Services
    .AddPredictionEnginePool<SalesInput, SalesPrediction>()
    .FromFile(modelName: "sales", filePath: "models/sales.zip", watchForChanges: true);

var app = builder.Build();

app.MapPost("/predict/sales", (
    SalesInput input,
    PredictionEnginePool<SalesInput, SalesPrediction> pool) =>
{
    SalesPrediction result = pool.Predict(modelName: "sales", example: input);
    return Results.Ok(new { result.PredictedSales });
});

app.Run();
watchForChanges: true を指定すると、ディスク上のモデルファイルが更新された際にプールが自動的に新しいモデルを読み込みます。これにより、アプリケーションを再起動せずにモデルを差し替えられます。ONNX モデルを扱う場合も、入出力型を対応するクラスに変えれば同じ登録方法が使えます。
バッチ推論とハードウェアアクセラレーション
1 件ずつの推論はオーバーヘッドが相対的に大きくなります。大量データを処理する場合は、複数の入力をまとめて IDataView に流し込み、Transform を一度だけ呼ぶことでスループットを高められます。
public IReadOnlyList<float> PredictBatch(
    MLContext ml, ITransformer model, IEnumerable<SalesInput> inputs)
{
    IDataView view = ml.Data.LoadFromEnumerable(inputs);
    IDataView scored = model.Transform(view);
    return ml.Data
        .CreateEnumerable<SalesPrediction>(scored, reuseRowObject: false)
        .Select(p => p.PredictedSales)
        .ToList();
}
ONNX Runtime を直接使う場合は、実行プロバイダ(Execution Provider)を切り替えることでハードウェアアクセラレーションを利用できます。NVIDIA GPU なら CUDA、Windows 環境なら DirectML といった具合に、環境に応じて追加します。SessionOptions のグラフ最適化レベルを上げておくと、起動時にモデルグラフが最適化されます。
using Microsoft.ML.OnnxRuntime;
using Microsoft.ML.OnnxRuntime.Tensors;

public sealed class OnnxRuntimeInference : IDisposable
{
    private readonly InferenceSession _session;

    public OnnxRuntimeInference(string modelPath, bool useGpu)
    {
        var options = new SessionOptions
        {
            GraphOptimizationLevel = GraphOptimizationLevel.ORT_ENABLE_ALL
        };
        if (useGpu)
            options.AppendExecutionProvider_CUDA(deviceId: 0);

        _session = new InferenceSession(modelPath, options);
    }

    public float[] Run(float[] flatInput, int batch, int features)
    {
        var tensor = new DenseTensor<float>(flatInput, new[] { batch, features });
        var inputs = new[] { NamedOnnxValue.CreateFromTensor("input", tensor) };

        using IDisposableReadOnlyCollection<DisposableNamedOnnxValue> results =
            _session.Run(inputs);
        return results.First().AsEnumerable<float>().ToArray();
    }

    public void Dispose() => _session.Dispose();
}
InferenceSession はスレッドセーフに Run を呼べる一方、生成コストが高いため、アプリケーションの生存期間を通じて 1 つのインスタンスを保持し、DI にシングルトンとして登録するのが適切です。CPU 環境でも、スレッド数の調整やバッチ化だけで実用的なスループットが得られる場合が少なくありません。
モデルのバージョン管理と本番監視
本番運用では、どのモデルがいつ配信されたかを追跡できることが欠かせません。モデルファイルにセマンティックなバージョンを付与し、チェックサムで完全性を検証したうえで読み込む運用を推奨します。読み込み時に軽い推論を一度実行し、入出力スキーマが期待どおりかを確認しておくと、壊れたモデルの配信を早期に止められます。
public sealed record ModelDescriptor(
    string Name, string Version, string Path, string Sha256);

public sealed class VersionedModelLoader
{
    private readonly MLContext _ml = new();

    public ITransformer Load(ModelDescriptor descriptor)
    {
        byte[] bytes = File.ReadAllBytes(descriptor.Path);
        string actual = Convert.ToHexString(
            System.Security.Cryptography.SHA256.HashData(bytes)).ToLowerInvariant();

        if (!string.Equals(actual, descriptor.Sha256, StringComparison.OrdinalIgnoreCase))
            throw new InvalidOperationException(
                $"Checksum mismatch for {descriptor.Name}:{descriptor.Version}");

        using var stream = new MemoryStream(bytes);
        return _ml.Model.Load(stream, out _);
    }
}
監視では、次の観点を継続的に記録します。いずれもモデルの劣化を検知するための基礎データになります。
- 推論レイテンシ — 平均だけでなく P95・P99 を記録し、閾値超過をアラートします。
- 予測分布 — スコアの分布が学習時から乖離していないかを追跡し、データドリフトの兆候を捉えます。
- 入力の妥当性 — 欠損や範囲外の値の割合を計測し、上流データの異常を検知します。
これらは System.Diagnostics.Metrics と OpenTelemetry を組み合わせれば、既存の可観測性基盤へそのまま送出できます。ドリフトを検知した際にモデルを前のバージョンへ切り戻せるよう、PredictionEnginePool の複数モデル登録やファイル差し替えの仕組みをあらかじめ組み込んでおくと、運用時の切り替えが安全になります。
エンハンスド株式会社では、ML.NET と ONNX を活用した機械学習モデルの本番実装を支援しています。学習済みモデルの ONNX 変換、ASP.NET Core への推論組み込み、バッチ処理やハードウェアアクセラレーションの最適化、バージョン管理と監視基盤の整備まで、既存の .NET システムに合わせた設計と実装をご提案します。機械学習を実運用へ乗せる段階でお困りの際は、ぜひご相談ください。
よくある質問
ONNX Runtime は C# から直接使えますか?
使えます。Microsoft.ML.OnnxRuntime パッケージを参照し、InferenceSession にモデル(.onnx)を読み込んで Run を呼ぶだけで推論できます。ML.NET を介さず、PyTorch や scikit-learn から書き出したモデルをそのまま .NET で動かせます。
ML.NET と ONNX Runtime はどう使い分けますか?
.NET 内でモデルを学習・前処理まで含めて完結させたいなら ML.NET、他フレームワークで学習済みのモデルを高速に推論したいなら ONNX Runtime(または ML.NET の ONNX 取り込み)が向きます。両者は組み合わせて使えます。
ONNX 推論を GPU で高速化できますか?
できます。Microsoft.ML.OnnxRuntime.Gpu(CUDA)や DirectML の実行プロバイダーを指定すると GPU を利用できます。バッチ推論と組み合わせるとスループットがさらに伸びます。
このテーマの全体像は .NET × AI 活用 完全ガイド にまとめています。あわせて TensorSharp(C# だけで動く GGUF 推論エンジン) や C# と Rust の相互運用(FFI) もご覧ください。
この記事をシェア
関連記事
ML.NET で機械学習を内製化した、ある製造業チームの記録
「精度は出ているんです。ただ、現場で使えなくて」。最初の打ち合わせで、先方の開発リーダーが口にした一言を今でも覚えている。ある精密部品メーカーの品質検査チームが、…
Python×LightGBM入門 第6回 実践応用とベストプラクティス
本記事は全6回でお届けしてきた「Python × LightGBM 入門」の最終回です。第1回から第5回までで、勾配ブースティングの仕組み、分類と回帰の実装、ハイパーパラメータの調整、…
【Ver1.0到達🎉】ReactネイティブエンジンJsxCoreが正式版をリリース!同時にAstroにC#を持ち込むAstroSharpを発表
先日、 ASP.NET Core のビューを JSX/TSX で書き、React/Preact でレンダリングする ビューエンジン JsxCore を 前回の記事 で紹介しました。…