
はじめに
表形式データの予測タスクにおいて、勾配ブースティング決定木は現在でも最も信頼される手法のひとつです。なかでも LightGBM は、学習の速さと精度の高さを両立し、Kaggle をはじめとするデータ分析コンペティションから業務システムの需要予測まで、幅広い場面で使われ続けています。
本記事は全6回でお届けする「Python × LightGBM 入門」の第1回です。初回となる今回は、そもそも勾配ブースティングとは何か、LightGBM がどのような仕組みで速さと精度を実現しているのか、そして手元の環境で動かすための準備までを丁寧に整理します。数式の細部よりも、全体像をつかむことを重視した構成です。第2回以降で扱う分類・回帰・チューニング・交差検証といった実践的なテーマの土台として読んでいただければと思います。
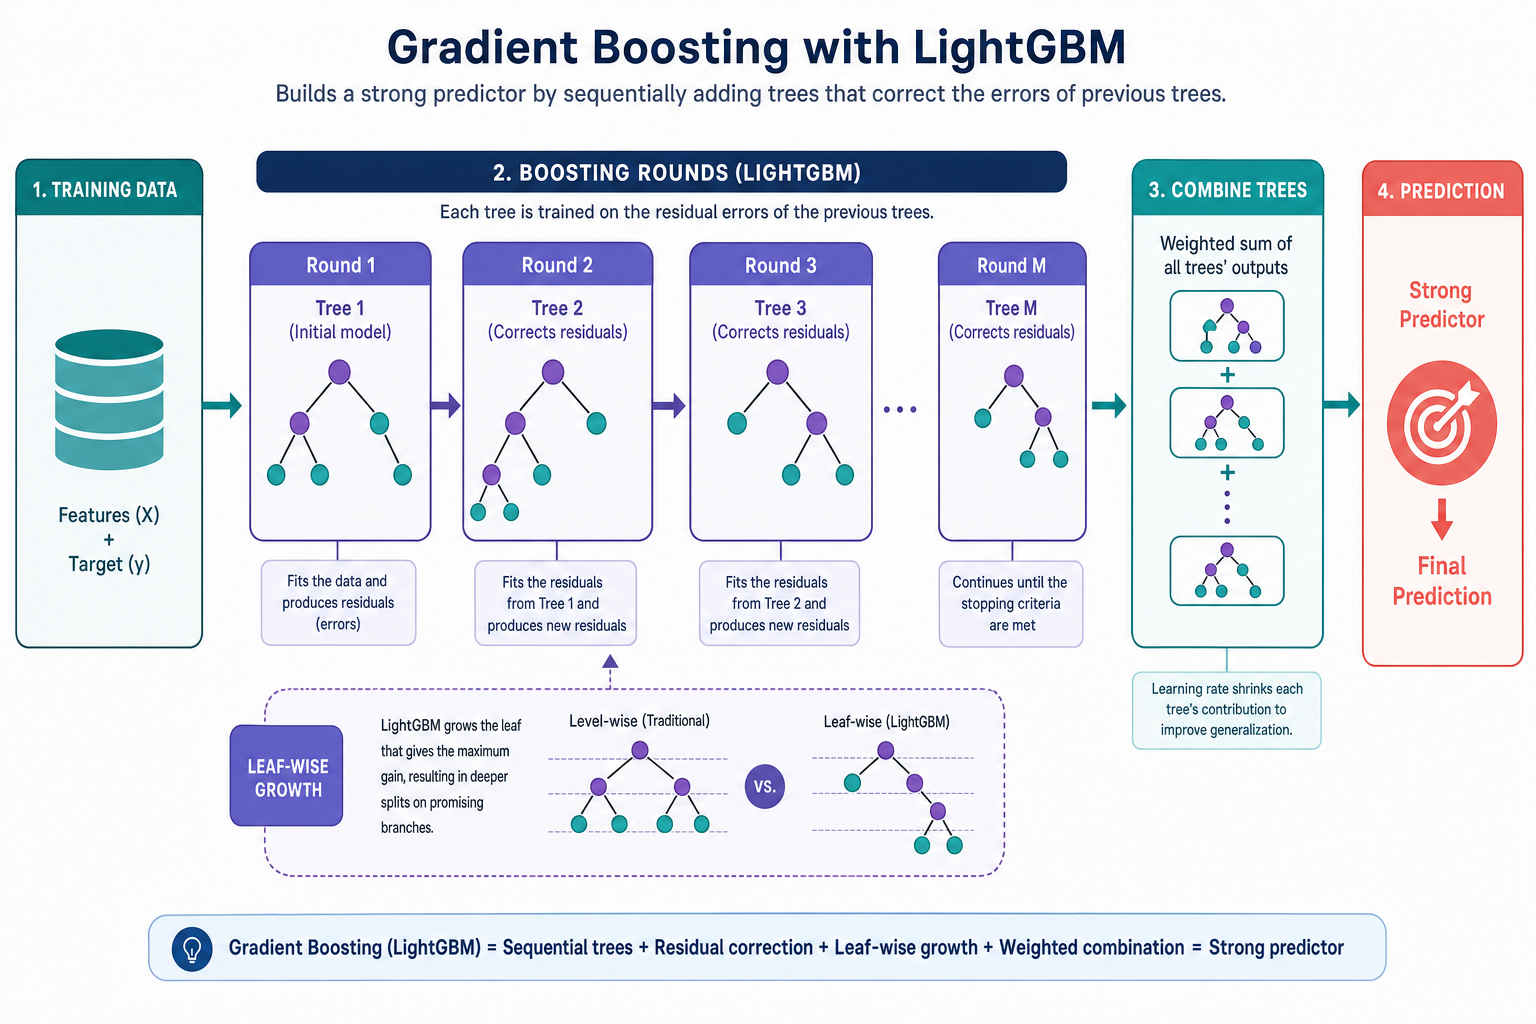
勾配ブースティング決定木の基本
LightGBM を理解するには、その基盤である勾配ブースティング決定木(GBDT: Gradient Boosting Decision Trees)の考え方を押さえておくと見通しがよくなります。
決定木という弱い予測器
決定木は「特徴量がある値より大きいか小さいか」という条件分岐を繰り返し、データを小さなグループへ振り分けて予測を行うモデルです。1本だけの決定木は解釈しやすい反面、複雑なパターンを十分に捉えきれず、単体では精度が伸びにくいという弱点を持っています。こうした単体では力の弱いモデルを「弱学習器」と呼びます。
誤差を順番に埋めていく仕組み
勾配ブースティングは、弱学習器である決定木を1本ずつ順番に追加し、前の木では説明しきれなかった誤差(残差)を次の木が補うように学習させる手法です。1本目の木がおおまかな傾向を捉え、2本目の木はその予測が外した部分を修正し、3本目はさらに残った誤差を埋めていく、という流れを繰り返します。
「勾配」という名前は、この誤差の修正方向を損失関数の勾配を使って決めることに由来します。最終的な予測は、こうして積み上げた多数の木の出力を足し合わせて求めます。1本1本は弱くても、誤差を補い合う多数の木を束ねることで、全体として非常に強い予測器ができあがります。この考え方はアンサンブル学習の一種であり、ランダムフォレストのように木を独立に並列で作る手法とは対照的です。
LightGBM の特徴
LightGBM(Light Gradient Boosting Machine)は、Microsoft が開発した GBDT の実装です。同じ勾配ブースティングでも、木の作り方やデータの扱い方に工夫があり、大規模データでも軽快に動く点が支持されています。
Leaf-wise の木成長
多くの実装は木を階層ごとに均等に広げる Level-wise(レベル優先)方式を採るのに対し、LightGBM は誤差を最も減らせる葉を選んで優先的に分割する Leaf-wise(葉優先)方式を採用しています。無駄な分割を避けて効きどころに計算資源を集中させるため、同じ木の本数でも精度が出やすく、学習も速くなります。一方で木が深く不均衡に伸びやすく過学習を招きやすい面があるため、後述する num_leaves などで複雑さを抑える調整が欠かせません。
ヒストグラムベースの分割探索
連続値の特徴量をそのまま扱うと、分割点の候補が膨大になり計算量が増えます。LightGBM は特徴量の値をあらかじめ有限個の区間(ビン)にまとめ、ヒストグラムとして集計してから分割点を探します。これにより探索対象が大幅に減り、メモリ使用量と計算時間の両方を抑えられます。速さと省メモリを支える中核的な仕組みです。
カテゴリ変数の直接サポート
性別や地域といったカテゴリ変数は、多くの手法ではワンホットエンコーディングなどの前処理を必要とします。LightGBM はカテゴリ変数を内部で直接扱えるため、前処理の手間を減らしつつ、カテゴリの分割を効率よく学習できます。
高速かつ高精度
以上の工夫に加え、マルチコアでの並列学習や GPU 学習、分散学習にも対応しており、数十万行を超えるような大規模データでも実用的な時間で学習を終えられます。速さと精度のバランスに優れる点が、LightGBM が長く選ばれ続ける理由です。
他手法との位置づけ
勾配ブースティングの実装は LightGBM だけではありません。代表的な選択肢として XGBoost と CatBoost があり、いずれも高い性能を持ちます。それぞれ得意分野が異なるため、特徴を押さえたうえで使い分けるとよいでしょう。
XGBoost は勾配ブースティングを広く普及させた実装で、安定した挙動と豊富な実績があります。CatBoost はカテゴリ変数の扱いに特化しており、カテゴリの多いデータで手間なく高精度を狙えます。LightGBM はとりわけ学習速度と大規模データへの対応で強みを発揮します。XGBoost との主な違いを整理すると次の通りです。
| 観点 | LightGBM | XGBoost |
|---|---|---|
| 木の成長方法 | Leaf-wise(葉優先) | Level-wise(レベル優先) |
| 分割探索 | ヒストグラムベース | ヒストグラム/厳密探索を選択可 |
| 学習速度 | 大規模データで高速 | 標準的 |
| メモリ使用量 | 少なめ | 標準的 |
| カテゴリ変数 | 直接サポート | エンコーディングが必要 |
どれかひとつが常に最良というわけではありません。データの規模やカテゴリ変数の割合、求める学習時間に応じて比較検討するのが実務的な進め方です。本シリーズではまず LightGBM を軸に、勾配ブースティングの勘所を身につけていきます。
環境構築
ここからは、実際に LightGBM を動かすための環境を整えます。本シリーズでは Python 3.12 以上を前提とします。
Python のバージョン確認
まず、利用中の Python のバージョンを確認します。3.12 未満の場合は、公式サイトなどから新しいバージョンの導入を検討してください。
python --version
# 環境によっては python3 を使います
python3 --version
仮想環境の作成
プロジェクトごとにライブラリを独立させておくと、バージョンの衝突を避けられます。標準の venv で仮想環境を作成し、有効化します。
# 仮想環境の作成
python -m venv lightgbm_env

# 有効化(Windows)
lightgbm_env\Scripts\activate

# 有効化(macOS / Linux)
source lightgbm_env/bin/activate
パッケージのインストール
LightGBM 本体と、データ処理や可視化に使う周辺パッケージをまとめて導入します。近年の LightGBM は主要な OS 向けにビルド済みパッケージが提供されており、pip で手軽にインストールできます。
pip install lightgbm numpy pandas scikit-learn matplotlib
インストールの確認
次のコードを実行し、各ライブラリが正しく読み込めてバージョンが表示されれば準備完了です。
import lightgbm as lgb
import numpy as np
import pandas as pd
import sklearn

print(f"LightGBM: {lgb.__version__}")
print(f"NumPy: {np.__version__}")
print(f"pandas: {pd.__version__}")
print(f"scikit-learn: {sklearn.__version__}")
最小限の学習・予測コード
環境が整ったところで、LightGBM の一連の流れを最小構成で体験してみましょう。ここでは scikit-learn に付属するアイリス(あやめ)データセットを使い、3種類の品種を分類する多クラス分類に取り組みます。
データの準備
データを読み込み、学習用とテスト用に分割します。テスト用データは学習には使わず、最後の精度確認のために取り分けておきます。
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
import lightgbm as lgb
import numpy as np

iris = load_iris()
X, y = iris.data, iris.target

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

print(f"学習データ: {X_train.shape}")
print(f"テストデータ: {X_test.shape}")
モデルの学習
LightGBM 専用の Dataset 形式に変換し、学習の設定をまとめた辞書を渡して学習します。objective で解きたい問題の種類を、metric で評価に使う指標を指定します。early_stopping を併用すると、検証データの精度が改善しなくなった時点で学習を打ち切り、過学習を抑えられます。
train_data = lgb.Dataset(X_train, label=y_train)
valid_data = lgb.Dataset(X_test, label=y_test, reference=train_data)

params = {
    "objective": "multiclass",   # 多クラス分類
    "num_class": 3,              # クラス数
    "metric": "multi_logloss",   # 評価指標
    "learning_rate": 0.05,       # 学習率
    "num_leaves": 15,            # 葉の数(小さめに設定して過学習を抑制)
    "verbose": -1,
}

model = lgb.train(
    params,
    train_data,
    num_boost_round=200,
    valid_sets=[valid_data],
    callbacks=[lgb.early_stopping(20), lgb.log_evaluation(20)],
)
予測と精度の確認
学習したモデルで予測を行います。多クラス分類では、各クラスに属する確率が出力されるため、最も確率の高いクラスを argmax で選びます。取り分けておいたテストデータで精度を確認しましょう。
from sklearn.metrics import accuracy_score, classification_report

y_prob = model.predict(X_test, num_iteration=model.best_iteration)
y_pred = np.argmax(y_prob, axis=1)

accuracy = accuracy_score(y_test, y_pred)
print(f"テストデータの正解率: {accuracy:.4f}")

print(classification_report(y_test, y_pred, target_names=iris.target_names))
数行のコードで、データの分割から学習、予測、精度評価までひと通り行えました。LightGBM はこのように手順が簡潔でありながら、実務レベルの性能を引き出せる点が魅力です。
押さえておきたい基本パラメータ
LightGBM には多数のパラメータがありますが、入門段階でまず理解しておきたいのは次のものです。
- objective — 解きたい問題の種類を指定します(回帰は
regression、二値分類はbinary、多クラス分類はmulticlassなど)。 - metric — 学習中の性能を測る評価指標です(
rmse、binary_logloss、multi_loglossなど)。 - num_leaves — 1本の木が持つ葉の最大数で、モデルの複雑さを左右する最重要パラメータです。大きいほど表現力が増す一方、過学習しやすくなります。
- learning_rate — 各木の寄与の大きさを決める学習率です。小さくするほど安定しますが、必要な木の本数は増えます。
- num_boost_round — 追加する木の本数です。
early_stoppingと組み合わせて適切な本数を自動的に見極めるのが定石です。
Leaf-wise の LightGBM では、とりわけ num_leaves と学習率、木の本数のバランスが精度を大きく左右します。パラメータ調整の具体的な進め方は、シリーズ後半で詳しく取り上げます。
まとめ
第1回では、勾配ブースティング決定木の基本的な考え方から、LightGBM が速さと精度を両立する仕組み、他手法との位置づけ、環境構築、そして最小構成での学習・予測までを扱いました。要点を振り返ります。
- 勾配ブースティングは、決定木を1本ずつ追加して前の誤差を補い、多数の木を束ねて強い予測器を作る手法である。
- LightGBM は Leaf-wise の成長とヒストグラムベースの分割探索により、大規模データでも高速かつ高精度に学習できる。
- カテゴリ変数を直接扱え、
pipで手軽に導入でき、scikit-learn との連携も容易である。 - Leaf-wise ゆえに過学習しやすいため、
num_leavesなどで複雑さを抑える調整が重要になる。
次回の第2回では、より実践的な分類問題を題材に、データの前処理からモデルの評価までを掘り下げます。実データを使いながら、今回学んだ基礎を手を動かして定着させていきましょう。
エンハンスド株式会社では、機械学習モデルの構築からデータ活用基盤の整備、業務への組み込みまで、企業のデータ活用を一貫してご支援しています。予測モデルの導入や既存分析の高度化をご検討の際は、ぜひお気軽にご相談ください。
参考リンク
よくある質問
LightGBM は Python でどう導入しますか?
pip install lightgbm で導入できます。scikit-learn 互換の API も備えているため、既存の機械学習パイプラインにそのまま組み込めます。
LightGBM と XGBoost はどちらが速いですか?
一般に LightGBM の方が高速です。Leaf-wise の木の成長とヒストグラムベースの分割探索により、大規模データでも学習が速く、メモリ効率にも優れます。
LightGBM で過学習を防ぐには?
Leaf-wise は過学習しやすいため、num_leaves を抑える、min_child_samples を増やす、早期終了(early stopping)を使う、といった調整が有効です。
このテーマの全体像は .NET × AI 活用 完全ガイド にまとめています。
本連載「Python×LightGBM入門」全6回
- 第1回 勾配ブースティングの基礎と環境構築(本記事)
- 第2回 分類問題の実装とモデル評価
- 第3回 回帰問題とハイパーパラメータ調整
- 第4回 特徴量エンジニアリングと重要度分析
- 第5回 交差検証とアンサンブル学習
- 第6回 実践応用とベストプラクティス
この記事をシェア
.NET / C# 案件のご相談はお気軽に
レガシー移行からクラウドネイティブ開発まで、
プロフェッショナルエンジニアが無料でご相談を承ります。
最短当日中にご返信。オンライン面談・NDA 締結にも対応します。
関連記事

【Python×LightGBM入門】第4回 特徴量エンジニアリングと重要度分析
第3回までで、LightGBM の学習・評価とパラメータ調整の基本を扱ってきました。第4回のテーマは、モデルの精度を最終的に左右する 特徴量エンジニアリング です。…

Python×LightGBM入門 第5回 交差検証とアンサンブル学習
本記事は全6回でお届けする「Python × LightGBM 入門」の第5回です。第4回までで、分類・回帰の実装から特徴量エンジニアリングと重要度分析までを扱ってきました。今回のテーマは、…

Python×LightGBM入門 第2回 分類問題の実装とモデル評価
本記事は全6回でお届けする「Python × LightGBM 入門」の第2回です。第1回では勾配ブースティング決定木の考え方と環境構築、最小構成での学習・予測までを扱いました。…