はじめに
第3回までで、LightGBM の学習・評価とパラメータ調整の基本を扱ってきました。第4回のテーマは、モデルの精度を最終的に左右する特徴量エンジニアリングです。勾配ブースティング決定木は生のデータからでも一定の性能を出せますが、カテゴリ変数の扱い方、欠損値への向き合い方、そして日時や集約から派生させる特徴の作り込みによって、到達できる精度の上限は大きく変わります。
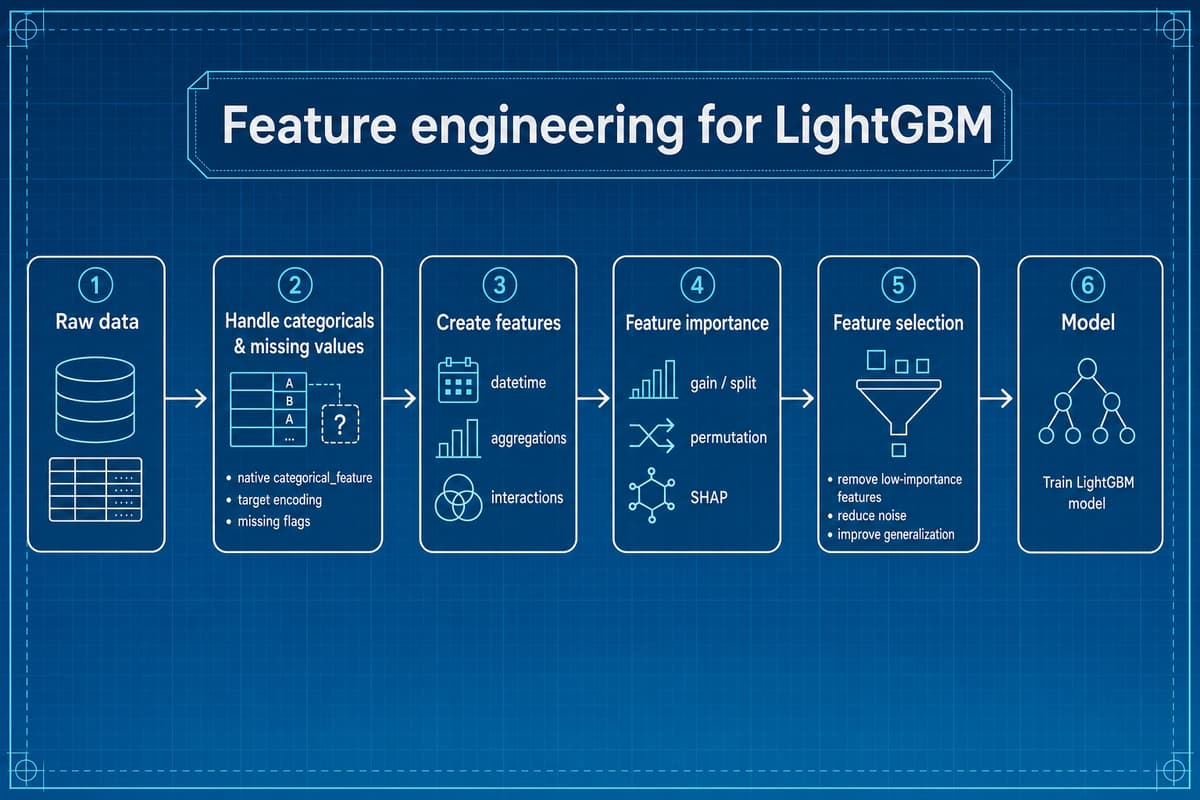
本稿では、LightGBM のネイティブなカテゴリ変数サポートを起点に、ターゲットエンコーディング、数値変換とビン化、交互作用、日時・集約特徴までを順に見ていきます。あわせて、gain や split といった組み込みの重要度、permutation importance、SHAP を使った解釈と特徴選択、そして実務で最も事故につながりやすいデータリークの防ぎ方までを一通り整理します。題材は、EC サイトの店舗別・日次売上を予測する回帰問題を想定します。
カテゴリ変数の扱い
LightGBM の大きな利点のひとつが、カテゴリ変数をワンホット展開せずに直接扱える点です。内部では、カテゴリごとの目的変数の統計量にもとづいて値をソートし、集合を二分する形で最適な分割を探索します。ワンホット化した場合に比べて木が浅くなりやすく、学習も高速です。使い方としては、pandas の category 型にしておくか、lgb.Dataset の categorical_feature に列を明示します。
import pandas as pd
import numpy as np
import lightgbm as lgb

# EC サイトの店舗別・日次売上を想定したデータを読み込む
df = pd.read_csv("sales.csv", parse_dates=["date"])

# カテゴリ列は category 型にしておくと LightGBM が自動認識する
cat_cols = ["category", "brand", "store", "weather"]
for col in cat_cols:
    df[col] = df[col].astype("category")

features = [c for c in df.columns if c not in ["date", "sales"]]
train_set = lgb.Dataset(
    df[features],
    label=df["sales"],
    categorical_feature=cat_cols,  # ネイティブに扱う列を明示する
)
注意したいのは、カテゴリの水準数(カーディナリティ)が大きい場合です。商品 ID やユーザー ID のように数万を超える水準を持つ列は、ネイティブ分割でも過学習を招きやすく、木がその列に張り付いてしまうことがあります。こうした高カーディナリティの列には、次に述べるターゲットエンコーディングや、頻度エンコーディング(各水準の出現回数への置き換え)を検討します。
ターゲットエンコーディングは、各カテゴリを目的変数の平均値などに置き換える手法で、高カーディナリティの列を少ない次元で表現できます。ただし、同じデータで平均を計算してそのまま特徴に使うと、目的変数の情報が特徴へ漏れ出し、検証スコアだけが不当に高くなります。これを避けるため、アウトオブフォールドで計算し、さらに件数の少ないカテゴリを全体平均へ寄せるスムージングを併用します。
from sklearn.model_selection import KFold

def target_encode_cv(train_df, col, target, n_splits=5, smoothing=10.0, seed=42):
    """アウトオブフォールドでターゲットエンコーディングを行う"""
    global_mean = train_df[target].mean()
    encoded = pd.Series(np.nan, index=train_df.index)
    kf = KFold(n_splits=n_splits, shuffle=True, random_state=seed)

    for tr_idx, val_idx in kf.split(train_df):
        tr = train_df.iloc[tr_idx]
        stats = tr.groupby(col)[target].agg(["mean", "count"])
        # 件数が少ないカテゴリは全体平均に寄せる(スムージング)
        smooth = (stats["mean"] * stats["count"] + global_mean * smoothing) \
                 / (stats["count"] + smoothing)
        encoded.iloc[val_idx] = train_df.iloc[val_idx][col].map(smooth)

    return encoded.fillna(global_mean)

df["category_te"] = target_encode_cv(df, "category", "sales")
テストデータへ適用する際は、学習データ全体で計算した平均をそのまま当てはめます。学習と推論でエンコーディングの基準がずれないよう、算出した対応表を保存しておくのが安全です。
欠損値の扱い
LightGBM は欠損値を補完せずに学習へ利用できます。分割の際、欠損値を左右いずれの枝に振り分けると損失が小さくなるかを学習し、推論時にも同じ方向へ流します。この挙動は既定で有効なので、木モデルにおいては平均値や中央値での安易な補完は必ずしも必要ありません。
むしろ実務で効くのは、欠損しているという事実そのものを特徴として残すことです。たとえば競合価格が取得できなかった、センサーの値が欠けたといった欠損は、ランダムではなく理由を伴って生じることが多く、欠損フラグが予測に寄与します。一方で、本来ゼロと欠損の意味が異なる列を一律に 0 で埋めてしまうと、両者の区別が失われて情報が劣化します。
# 欠損の「有無」自体が情報を持つ場合はフラグ化して残す
for col in ["competitor_price", "temperature"]:
    df[f"{col}_isna"] = df[col].isna().astype("int8")

# ゼロと欠損の意味が異なる列は、安易な 0 埋めを避けて欠損のまま渡す
補完を行う場合でも、その基準値は学習データから求め、テストデータには同じ値を当てはめます。テストデータを含めて中央値などを計算するのは、後述するデータリークの典型例のひとつです。
数値特徴の変換・ビン化・交互作用
数値特徴の変換については、木モデルの性質を踏まえて取捨選択する必要があります。決定木は各特徴のしきい値で分割するため、対数変換や標準化のような単調変換を単独の列に施しても、分割位置が対応して移るだけで精度はほとんど変わりません。線形モデルでは重要な前処理であっても、LightGBM では効果が限定的だという点を押さえておきます。
効果が出やすいのは、複数の特徴を組み合わせて木が単独では表現しにくい関係を明示的に渡す場合です。価格と競合価格の差や比、単価と数量の積といった交互作用は、モデルが自力で近似するより先に特徴として与えたほうが、少ない木の本数で捉えられます。ビン化は、連続値を分位点で離散化してカテゴリ的に扱いたいときや、集約のキーとして使いたいときに役立ちます。
# 交互作用(差・比・積)は木が単独では捉えにくい関係を明示的に渡す
df["price_gap"] = df["price"] - df["competitor_price"]
df["price_ratio"] = df["price"] / (df["competitor_price"] + 1e-6)

# ビン化(分位点で離散化)。集約キーやカテゴリ的な扱いに使う
df["price_bin"] = pd.qcut(df["price"], q=10, labels=False, duplicates="drop")

# 分布が大きく歪む列は対数変換しておくと集約や比の計算が安定する
df["price_log"] = np.log1p(df["price"])
交互作用は闇雲に総当たりで作ると次元が膨れ上がり、ノイズと過学習の温床になります。価格と需要、天候と季節商材のように、ドメイン知識から意味づけできる組み合わせに絞るのが現実的です。作った特徴が本当に効いているかは、後述の重要度分析で確認します。
日時特徴と集約特徴
日時列は、そのままでは木が扱いにくいため、年・月・日・曜日といった構成要素へ分解します。加えて、月や曜日のような周期を持つ量は、値の大小に連続性がある一方で 12 月と 1 月が隣接するといった循環構造を持ちます。これを表現するために、sin と cos による変換を併用します。
def add_datetime_features(df, col="date"):
    d = df[col].dt
    df["year"] = d.year
    df["month"] = d.month
    df["day"] = d.day
    df["dayofweek"] = d.dayofweek
    df["is_weekend"] = (d.dayofweek >= 5).astype("int8")
    df["weekofyear"] = d.isocalendar().week.astype("int32")
    # 周期性は sin / cos で連続化し、月末と月初の隣接を表現する
    df["month_sin"] = np.sin(2 * np.pi * d.month / 12)
    df["month_cos"] = np.cos(2 * np.pi * d.month / 12)
    return df

df = add_datetime_features(df)
集約特徴は、店舗や商品といった単位で目的変数や関連量を要約し、個々の行に水準感を与えます。時系列を含むデータでは、集約に未来の情報を混ぜないことが決定的に重要です。ラグや移動統計を作るときは、対象日を含めないよう shift してから rolling を適用し、過去の値だけで計算します。
df = df.sort_values(["store", "date"])
grp = df.groupby("store")["sales"]

# 過去の値だけを使うため、当日を含めないよう shift してから集計する
df["sales_lag_7"] = grp.shift(7)
df["sales_roll_mean_28"] = grp.shift(1).rolling(28, min_periods=7).mean()
df["sales_roll_std_28"] = grp.shift(1).rolling(28, min_periods=7).std()
店舗とカテゴリの組み合わせごとの平均売上のような、時間軸を持たない水準特徴も有効です。ただしこの種の集約は、学習データだけを使って対応表を作り、検証・テストへは map で当てはめます。データ全体で transform("mean") を計算すると検証データの情報が学習側に漏れるため、次節の観点で必ず切り分けます。
特徴量重要度と特徴選択
作り込んだ特徴が実際に効いているかを見極める手段として、まず LightGBM の組み込み重要度があります。gain は各特徴が分割で減らした損失の合計、split はその特徴が分割に使われた回数です。両者はしばしば順位が食い違い、一般には損失への貢献を直接測る gain のほうが解釈しやすい指標です。
params = {
    "objective": "regression",
    "metric": "rmse",
    "learning_rate": 0.05,
    "num_leaves": 63,
    "feature_fraction": 0.8,
    "bagging_fraction": 0.8,
    "bagging_freq": 1,
    "verbose": -1,
}
model = lgb.train(params, train_set, num_boost_round=500)

imp = pd.DataFrame({
    "gain": model.feature_importance("gain"),
    "split": model.feature_importance("split"),
}, index=features).sort_values("gain", ascending=False)
print(imp.head(15))
組み込み重要度には注意点もあります。連続値や高カーディナリティのカテゴリは分割の候補が多いぶん重要度が高く出やすく、値が大きいことが必ずしも予測への真の寄与を意味しません。この偏りを補うのが permutation importance です。検証データで対象特徴の値だけをシャッフルし、性能がどれだけ悪化したかで寄与を測るため、モデルに依存しすぎない評価ができます。
from sklearn.inspection import permutation_importance

# scikit-learn API のモデルを検証データで評価する
result = permutation_importance(
    sk_model, X_valid, y_valid,
    n_repeats=10, random_state=42,
    scoring="neg_root_mean_squared_error",
)
perm = pd.Series(result.importances_mean, index=X_valid.columns)
print(perm.sort_values(ascending=False).head(15))
より細かな解釈には SHAP を用います。SHAP は各予測に対して特徴ごとの寄与を加法的に分解するため、全体傾向だけでなく、特定の予測がなぜその値になったのかまで説明できます。平均絶対 SHAP 値を並べれば、符号と大きさを踏まえた重要度ランキングとしても使えます。
import shap

explainer = shap.TreeExplainer(model)
shap_values = explainer.shap_values(X_valid)

# 平均絶対 SHAP 値で重要度をランキングする
shap_imp = pd.Series(np.abs(shap_values).mean(axis=0), index=X_valid.columns)
print(shap_imp.sort_values(ascending=False).head(15))

# 全体傾向は summary plot、個別予測の説明は waterfall plot で確認する
shap.summary_plot(shap_values, X_valid, show=False)
特徴選択では、これらの指標を突き合わせて判断します。とりわけ permutation importance がゼロ以下、つまり値を壊しても性能が悪化しない特徴は、寄与がないかノイズである可能性が高く、削除の候補になります。特徴を減らすことは、推論の高速化や運用の単純化だけでなく、過学習の抑制にもつながります。
# 並べ替えても性能が悪化しない特徴を削除候補にする
weak = perm[perm <= 0].index.tolist()
selected = [c for c in features if c not in weak]
print(f"{len(features)} 列から {len(selected)} 列を選択")
ただし相関の強い特徴どうしでは、片方をシャッフルしてももう片方が情報を補うため、重要度が互いに低く見積もられることがあります。削除は一度に大量に行わず、選択後に交差検証でスコアを確認しながら段階的に進めるのが安全です。
データリークを防ぐ
特徴量エンジニアリングで最も避けたいのがデータリークです。リークとは、本番の推論時には手に入らない情報が、学習時の特徴へ紛れ込む状態を指します。検証スコアは高いのに本番でまったく再現しない、という典型的な失敗はここから生まれます。これまでの各節でも触れましたが、防止の要点を改めて整理します。
- 目的変数由来の統計 — ターゲットエンコーディングはアウトオブフォールドで作り、テストへは学習データの対応表を当てはめる。
- スケーリングや補完の基準 — 平均・中央値・分位点は学習データだけから求め、検証・テストへ同じ値を適用する。
- 集約特徴 — 全データに対する
transformではなく、学習データで対応表を作りmapで当てはめる。 - 時系列のラグ・移動統計 — 対象日を含めないよう
shiftしてから集計し、未来の値を混ぜない。 - データ分割の方法 — 時系列予測では時間で切って検証し、シャッフル分割で未来を学習に含めない。
これらを個別に気をつけるのは負担が大きいため、前処理を関数やパイプラインとしてまとめ、学習時に fit、推論時に transform と役割を分離しておくと、リークが構造的に入り込みにくくなります。特徴の妥当性は、検証スコアだけでなく、時間的に後ろのデータで測った成績や、単純なモデルとの差分でも確認しておくと安心です。
まとめ
第4回では、LightGBM で精度を引き上げるための特徴量エンジニアリングと、その効果を見極める重要度分析を扱いました。要点を振り返ります。
- カテゴリ変数はネイティブに扱えるが、高カーディナリティの列にはアウトオブフォールドのターゲットエンコーディングやスムージングを検討する。
- 欠損値は補完せずに学習でき、欠損の有無自体をフラグとして残すと寄与することが多い。
- 木モデルでは単調変換の効果は薄く、差・比・積といった交互作用や、日時・集約の特徴づくりが精度を押し上げる。
- gain / split の組み込み重要度、permutation importance、SHAP を組み合わせて特徴の寄与を評価し、効かない特徴を段階的に整理する。
- 目的変数由来の統計や集約、スケーリングの基準はすべて学習データから作り、データリークを構造的に防ぐ。
次回の第5回では、こうして整えた特徴量を土台に、交差検証とアンサンブル学習へ進みます。モデルの汎化性能を正しく測り、複数のモデルを組み合わせて予測をさらに安定させる手法を掘り下げていきます。
エンハンスド株式会社では、特徴量設計やモデル構築にとどまらず、データ活用基盤の整備から予測モデルの業務組み込み、運用の内製化支援までを一貫してご提供しています。需要予測や離脱予測といった機械学習プロジェクトの立ち上げ、既存モデルの精度改善をご検討の際は、ぜひお気軽にご相談ください。
本連載の全体像は Python×LightGBM入門(第1回 基礎と環境構築) にまとめています。
本連載「Python×LightGBM入門」全6回
- 第1回 勾配ブースティングの基礎と環境構築
- 第2回 分類問題の実装とモデル評価
- 第3回 回帰問題とハイパーパラメータ調整
- 第4回 特徴量エンジニアリングと重要度分析(本記事)
- 第5回 交差検証とアンサンブル学習
- 第6回 実践応用とベストプラクティス
この記事をシェア
関連記事
Python×LightGBM入門 第1回 勾配ブースティングの基礎と環境構築
表形式データの予測タスクにおいて、 勾配ブースティング決定木 は現在でも最も信頼される手法のひとつです。なかでも LightGBM は、学習の速さと精度の高さを両立し、…
Python×LightGBM入門 第5回 交差検証とアンサンブル学習
本記事は全6回でお届けする「Python × LightGBM 入門」の第5回です。第4回までで、分類・回帰の実装から特徴量エンジニアリングと重要度分析までを扱ってきました。今回のテーマは、…
Python×LightGBM入門 第6回 実践応用とベストプラクティス
本記事は全6回でお届けしてきた「Python × LightGBM 入門」の最終回です。第1回から第5回までで、勾配ブースティングの仕組み、分類と回帰の実装、ハイパーパラメータの調整、…