はじめに
本連載「Python × LightGBM 入門」の第3回です。前回は二値分類を題材に、データの前処理からモデル評価までの流れを確認しました。今回は回帰問題への適用と、モデルの性能を左右するハイパーパラメータ調整を扱います。回帰では予測値が連続量になるため、目的関数と評価指標の選び方が結果に直結します。あわせて、主要なハイパーパラメータが何を制御しているのかを整理し、過学習を抑えながら精度を引き上げる手順を、Optuna による自動最適化まで含めて解説します。
題材には住宅価格の予測を使います。面積や築年数、駅からの距離といった特徴量から価格を推定する、実務でも頻出する構造の問題です。以降のコードは LightGBM 4 系と Python 3.11 以降を想定しています。
回帰の目的関数と評価指標
回帰で最初に決めるのが目的関数です。LightGBM は objective パラメータで最適化の対象を切り替えます。代表的な選択肢は次のとおりです。
regression(L2 損失) — 二乗誤差を最小化する標準的な設定で、まず基準として選びます。誤差の大きい点を強く罰するため、外れ値の影響を受けやすい性質があります。regression_l1(L1 損失、MAE) — 絶対誤差を最小化します。外れ値に対して L2 よりも頑健で、中央値的な予測に寄ります。huber— 誤差が小さい領域では二乗損失、大きい領域では線形損失に切り替わる中間的な目的関数です。alphaで切り替え点を調整し、外れ値の影響を抑えつつ滑らかに学習できます。fairやquantile— さらに頑健さを求める場合や、予測区間を得たい場合に用います。quantileではalphaに分位点を指定します。
評価指標は目的関数とは別に選べます。回帰でよく使うのは次の3つです。RMSE は誤差を二乗して平均し平方根をとった値で、大きな外れに敏感です。MAE は絶対誤差の平均で、外れ値の影響が相対的に小さく解釈しやすい指標です。R2(決定係数)はモデルが目的変数の分散をどれだけ説明できたかを 0 から 1 の範囲で表します。ビジネス要件に応じて主指標を決め、補助的に残りを確認する運用が扱いやすいでしょう。
import numpy as np
import pandas as pd
import lightgbm as lgb
from sklearn.model_selection import train_test_split, KFold
from sklearn.metrics import mean_squared_error, mean_absolute_error, r2_score

# 住宅価格を模した回帰用データを用意する(実務ではCSVやDBから読み込む)
rng = np.random.default_rng(42)
n = 5000
df = pd.DataFrame({
    "area": rng.uniform(50, 300, n),            # 面積(平米)
    "rooms": rng.integers(1, 6, n),             # 部屋数
    "age": rng.integers(0, 50, n),              # 築年数
    "distance_station": rng.exponential(2, n),  # 駅からの距離(km)
    "floor": rng.integers(1, 20, n),            # 階数
    "parking": rng.choice([0, 1], n, p=[0.3, 0.7]),
    "renovation": rng.choice([0, 1], n, p=[0.8, 0.2]),
})

# 価格(万円)を特徴量から合成し、ノイズを加える
df["price"] = (
    2.0 * df["area"] + 50 * df["rooms"] - 5 * df["age"]
    - 30 * df["distance_station"] + 5 * df["floor"]
    + 100 * df["parking"] + 200 * df["renovation"]
    + rng.normal(0, 50, n)
)

feature_cols = ["area", "rooms", "age", "distance_station",
                "floor", "parking", "renovation"]
X, y = df[feature_cols], df["price"]
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)
基本モデルの学習と評価
まずは既定に近いパラメータで基準となるモデルを作り、後続の調整でどれだけ改善したかを比較できるようにします。学習には lgb.train を使い、検証用データを渡して過学習の兆候を監視します。
train_set = lgb.Dataset(X_train, label=y_train)
valid_set = lgb.Dataset(X_test, label=y_test, reference=train_set)

params = {
    "objective": "regression",  # L2損失
    "metric": "rmse",
    "boosting_type": "gbdt",
    "num_leaves": 31,
    "learning_rate": 0.05,
    "feature_fraction": 0.9,
    "bagging_fraction": 0.8,
    "bagging_freq": 5,
    "seed": 42,
    "verbose": -1,
}

model = lgb.train(
    params,
    train_set,
    num_boost_round=2000,
    valid_sets=[train_set, valid_set],
    callbacks=[
        lgb.early_stopping(stopping_rounds=100),
        lgb.log_evaluation(period=200),
    ],
)

y_pred = model.predict(X_test, num_iteration=model.best_iteration)
rmse = np.sqrt(mean_squared_error(y_test, y_pred))
mae = mean_absolute_error(y_test, y_pred)
r2 = r2_score(y_test, y_pred)
print(f"RMSE={rmse:.2f}  MAE={mae:.2f}  R2={r2:.4f}")
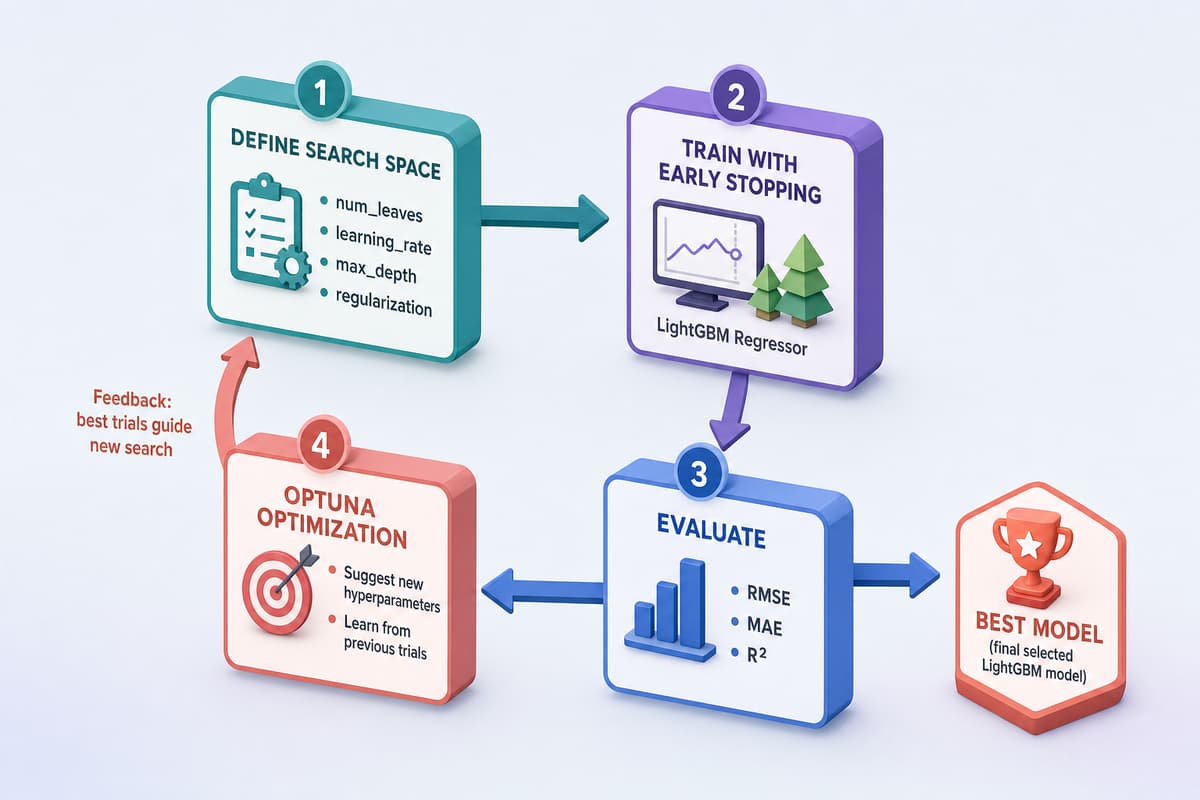
ここで登場する early_stopping は、検証スコアが指定回数だけ改善しなくなった時点で学習を打ち切るコールバックです。num_boost_round を大きめに設定しておき、実際の反復数は early stopping に決めさせるのが定石です。学習後は model.best_iteration を predict に渡し、最良の反復時点のモデルで推論します。
主要ハイパーパラメータの意味と調整方針
LightGBM のパラメータは数が多いものの、精度と過学習に効くものは限られます。役割を理解して優先順位をつけると、闇雲な探索を避けられます。
num_leaves— 1本の木がもつ葉の最大数で、モデルの複雑さを最も強く決めます。大きいほど表現力は上がりますが過学習しやすく、目安として2^max_depthより小さく保つと安定します。learning_rate— 各木の寄与を縮小する係数です。小さくすると精度は上がりやすい一方で必要な木の本数が増えます。小さめの学習率と early stopping を組み合わせる形が扱いやすいでしょう。max_depth— 木の深さの上限です。num_leavesと併せて複雑さを抑える保険として使います。min_child_samples(min_data_in_leaf) — 1つの葉に必要な最小データ数です。大きくすると細かすぎる分割を抑え、過学習を緩和します。feature_fraction— 各木で使う特徴量の割合です。1未満にすると木ごとに見る特徴が変わり、多様性が生まれて汎化しやすくなります。bagging_fractionとbagging_freq— 各木で使う行(サンプル)の割合と、その再抽出の頻度です。両方を有効にして初めてサンプリングが働きます。lambda_l1とlambda_l2— それぞれ L1・L2 正則化の強さです。葉の重みにペナルティをかけ、過学習を直接抑えます。
調整の順序としては、まず num_leaves と min_child_samples でモデルの複雑さの当たりをつけ、次に feature_fraction と bagging_fraction でサンプリングを効かせ、最後に lambda_l1 と lambda_l2 で正則化を締めるとまとまりやすくなります。learning_rate は探索中は 0.05 程度に固定し、最終学習で小さくして本数を伸ばすのが効率的です。
過学習への対策
過学習は、訓練スコアが伸び続ける一方で検証スコアが頭打ちや悪化に転じる形で現れます。LightGBM では次の手立てを組み合わせて抑えます。木の複雑さは num_leaves と max_depth で制限し、葉の最小データ数 min_child_samples を引き上げて過剰な分割を防ぎます。feature_fraction と bagging_fraction によるサンプリングでモデルに多様性をもたせ、lambda_l1 と lambda_l2 の正則化で葉の重みを抑えます。加えて early stopping で反復を打ち切れば、木の本数の過剰も避けられます。
外れ値が精度を乱している場合は、目的関数を huber や regression_l1 に切り替える選択肢もあります。次の例では Huber 損失を使い、大きな誤差の影響を和らげています。
params_huber = {
    "objective": "huber",
    "alpha": 0.9,          # 二乗損失と線形損失の切り替え点
    "metric": "mae",
    "num_leaves": 31,
    "learning_rate": 0.05,
    "min_child_samples": 30,
    "feature_fraction": 0.8,
    "bagging_fraction": 0.8,
    "bagging_freq": 5,
    "seed": 42,
    "verbose": -1,
}

model_huber = lgb.train(
    params_huber,
    train_set,
    num_boost_round=2000,
    valid_sets=[valid_set],
    callbacks=[lgb.early_stopping(100), lgb.log_evaluation(0)],
)
Optunaによる自動最適化
手動での調整には限界があります。パラメータ同士が影響し合うため、格子状に総当たりすると組み合わせが爆発してしまいます。Optuna はベイズ最適化系のアルゴリズム(既定は TPE)で有望な領域を優先的に探索し、少ない試行で良い組み合わせに近づけます。
目的関数の内部では交差検証で汎化性能を測り、その平均スコアを返します。返り値を最小化する方向に study を回すことで、テストデータに触れずにパラメータを選べます。
import optuna

def objective(trial):
    params = {
        "objective": "regression",
        "metric": "rmse",
        "boosting_type": "gbdt",
        "learning_rate": 0.05,
        "num_leaves": trial.suggest_int("num_leaves", 15, 255),
        "max_depth": trial.suggest_int("max_depth", 3, 12),
        "min_child_samples": trial.suggest_int("min_child_samples", 5, 100),
        "feature_fraction": trial.suggest_float("feature_fraction", 0.5, 1.0),
        "bagging_fraction": trial.suggest_float("bagging_fraction", 0.5, 1.0),
        "bagging_freq": trial.suggest_int("bagging_freq", 1, 7),
        "lambda_l1": trial.suggest_float("lambda_l1", 1e-8, 10.0, log=True),
        "lambda_l2": trial.suggest_float("lambda_l2", 1e-8, 10.0, log=True),
        "seed": 42,
        "verbose": -1,
    }

    kf = KFold(n_splits=5, shuffle=True, random_state=42)
    scores = []
    for train_idx, valid_idx in kf.split(X_train):
        X_tr, X_va = X_train.iloc[train_idx], X_train.iloc[valid_idx]
        y_tr, y_va = y_train.iloc[train_idx], y_train.iloc[valid_idx]

        tr_set = lgb.Dataset(X_tr, label=y_tr)
        va_set = lgb.Dataset(X_va, label=y_va, reference=tr_set)
        model = lgb.train(
            params,
            tr_set,
            num_boost_round=2000,
            valid_sets=[va_set],
            callbacks=[lgb.early_stopping(100), lgb.log_evaluation(0)],
        )
        pred = model.predict(X_va, num_iteration=model.best_iteration)
        scores.append(np.sqrt(mean_squared_error(y_va, pred)))
    return float(np.mean(scores))

study = optuna.create_study(
    direction="minimize",
    sampler=optuna.samplers.TPESampler(seed=42),
)
study.optimize(objective, n_trials=100)

print("best RMSE:", round(study.best_value, 3))
print("best params:", study.best_params)
試行を早く打ち切りたい場合は、Pruning を併用します。LightGBM 連携のコールバックは optuna-integration パッケージにあり、pip install optuna-integration[lightgbm] で導入したうえで from optuna_integration.lightgbm import LightGBMPruningCallback として利用します。見込みの薄い試行を途中で止められるため、探索全体の時間を短縮できます。
最適化が終わったら、得られたパラメータで全訓練データを使って学習し直し、初めてテストデータで評価します。学習率をここで小さくし、num_boost_round を伸ばすと、もう一段の精度向上を狙えます。
best_params = {
    **study.best_params,
    "objective": "regression",
    "metric": "rmse",
    "boosting_type": "gbdt",
    "learning_rate": 0.02,   # 最終学習では小さくして本数を伸ばす
    "seed": 42,
    "verbose": -1,
}

final_model = lgb.train(
    best_params,
    train_set,
    num_boost_round=5000,
    valid_sets=[valid_set],
    callbacks=[lgb.early_stopping(200), lgb.log_evaluation(0)],
)

pred = final_model.predict(X_test, num_iteration=final_model.best_iteration)
print("RMSE:", round(np.sqrt(mean_squared_error(y_test, pred)), 2))
print("MAE :", round(mean_absolute_error(y_test, pred), 2))
print("R2  :", round(r2_score(y_test, pred), 4))
まとめ
今回は、LightGBM を回帰問題へ適用し、精度を引き上げるための調整手順を整理しました。要点は次の4つです。
- 目的関数は問題の性質で選ぶ。外れ値が多ければ
huberやregression_l1を検討する。 - 評価指標は RMSE・MAE・R2 を役割で使い分け、主指標を決めて補助指標も確認する。
- 調整は複雑さ、サンプリング、正則化の順で効かせ、early stopping で反復を制御する。
- Optuna で交差検証を組み込んだ自動最適化を行い、最後にテストデータで一度だけ評価する。
次回は「特徴量エンジニアリングと重要度分析」として、モデルの入力そのものを改善する手法と、予測根拠を読み解く方法を扱います。
エンハンスド株式会社では、LightGBM をはじめとする機械学習モデルの構築や、既存業務データを活かした予測基盤の設計・運用を支援しています。回帰モデルの精度改善やチューニングの自動化にお悩みの際は、ぜひお気軽にご相談ください。
本連載の全体像は Python×LightGBM入門(第1回 基礎と環境構築) にまとめています。
本連載「Python×LightGBM入門」全6回
- 第1回 勾配ブースティングの基礎と環境構築
- 第2回 分類問題の実装とモデル評価
- 第3回 回帰問題とハイパーパラメータ調整(本記事)
- 第4回 特徴量エンジニアリングと重要度分析
- 第5回 交差検証とアンサンブル学習
- 第6回 実践応用とベストプラクティス
この記事をシェア
関連記事
Python×LightGBM入門 第1回 勾配ブースティングの基礎と環境構築
表形式データの予測タスクにおいて、 勾配ブースティング決定木 は現在でも最も信頼される手法のひとつです。なかでも LightGBM は、学習の速さと精度の高さを両立し、…
Python×LightGBM入門 第2回 分類問題の実装とモデル評価
本記事は全6回でお届けする「Python × LightGBM 入門」の第2回です。第1回では勾配ブースティング決定木の考え方と環境構築、最小構成での学習・予測までを扱いました。…
【Python×LightGBM入門】第4回 特徴量エンジニアリングと重要度分析
第3回までで、LightGBM の学習・評価とパラメータ調整の基本を扱ってきました。第4回のテーマは、モデルの精度を最終的に左右する 特徴量エンジニアリング です。…