はじめに
本記事は全6回でお届けしてきた「Python × LightGBM 入門」の最終回です。第1回から第5回までで、勾配ブースティングの仕組み、分類と回帰の実装、ハイパーパラメータの調整、特徴量エンジニアリング、そして交差検証とアンサンブルまでを扱ってきました。ここまでは、いわば「精度の高いモデルをどう作るか」に軸足を置いた内容でした。
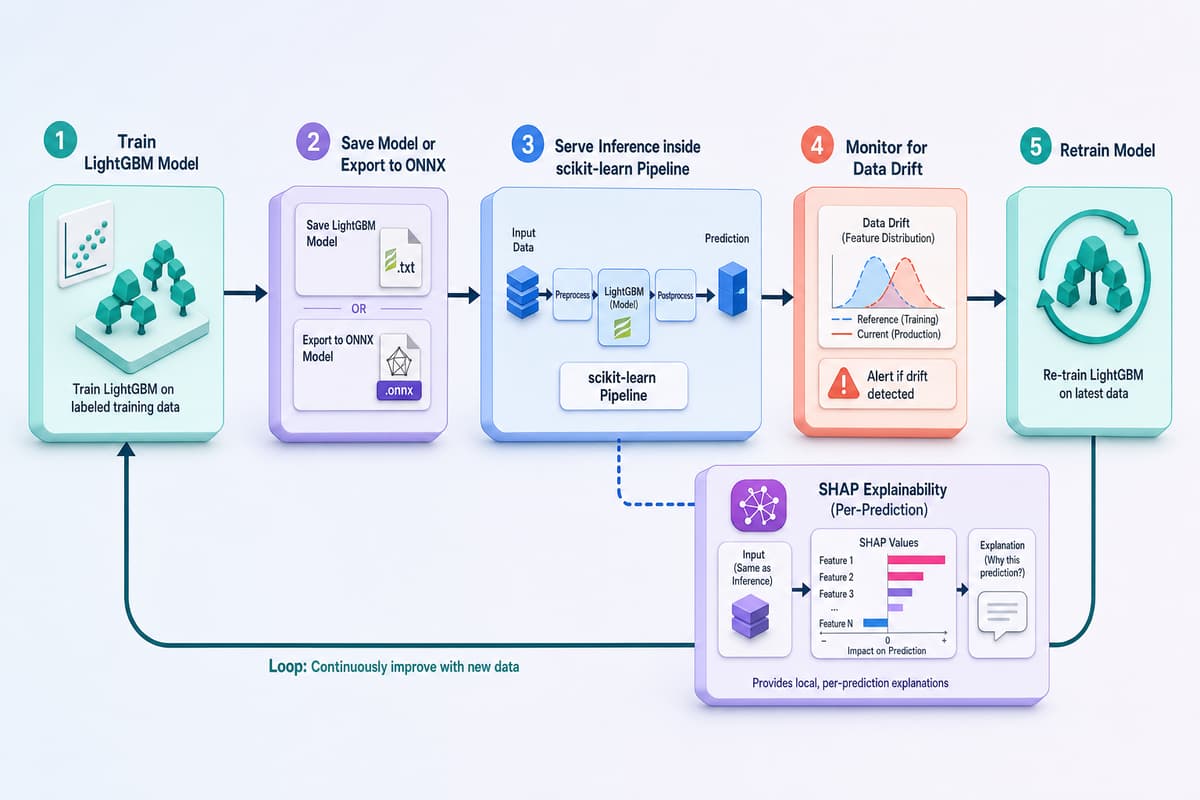
最終回のテーマは、その先にある「作ったモデルをどう届け、どう保つか」です。学習が終わったモデルは、保存され、別のプロセスで読み込まれ、本番の入力に対して安定して予測を返し続けて初めて価値を生みます。今回は、モデルの保存と読み込み、scikit-learn パイプラインへの統合、ONNX への書き出し、SHAP による説明性、そして運用を支えるベストプラクティスと落とし穴までを一続きに整理します。コードは LightGBM 4 系と scikit-learn 1.5 以降を前提としています。
学習済みモデルの保存と読み込み
モデルの永続化には大きく二つの方法があります。一つは LightGBM 自身のテキスト形式で保存する方法、もう一つは Python オブジェクトごと直列化する方法です。用途が異なるため、両方を押さえておくと運用の選択肢が広がります。
Booster の save_model は、木の構造をテキストとして書き出します。バージョンや実装言語に依存しにくく、C++ や他言語のランタイムからも読み込めるため、長期保存や言語をまたいだ配布に向いています。一方の joblib は、前処理器やラベルエンコーダーなど周辺オブジェクトをまとめて保存できる手軽さが利点です。
import lightgbm as lgb
import numpy as np
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split

X, y = make_classification(n_samples=20000, n_features=20,
                           n_informative=10, random_state=42)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y)

params = {"objective": "binary", "metric": "auc",
          "num_leaves": 31, "learning_rate": 0.05, "verbose": -1}

train_set = lgb.Dataset(X_train, label=y_train)
valid_set = lgb.Dataset(X_test, label=y_test, reference=train_set)

booster = lgb.train(
    params, train_set, num_boost_round=500,
    valid_sets=[valid_set],
    callbacks=[lgb.early_stopping(50), lgb.log_evaluation(0)])

# 1. LightGBM ネイティブ形式(テキスト)で保存
#    best_iteration までを書き出し、推論時の反復数を固定する
booster.save_model("model.txt", num_iteration=booster.best_iteration)

# 読み込みは Booster に model_file を渡すだけ
loaded = lgb.Booster(model_file="model.txt")
pred = loaded.predict(X_test)
print("AUC 用スコアの先頭:", np.round(pred[:5], 4))
ここで大切なのは、保存時に num_iteration=booster.best_iteration を指定している点です。早期終了で得た最良の反復数をモデルに焼き込んでおくと、読み込み側で反復数を指定し忘れても過学習した末尾の木まで使われる事故を防げます。周辺オブジェクトも一緒に配布する場合は、次のように joblib でまとめると管理が単純になります。
import joblib

# 前処理器やメタ情報を辞書にまとめて一括保存する
artifact = {
    "booster": booster,
    "feature_names": [f"f{i}" for i in range(X_train.shape[1])],
    "best_iteration": booster.best_iteration,
    "trained_at": "2026-01-15",
}
joblib.dump(artifact, "model_bundle.joblib")

bundle = joblib.load("model_bundle.joblib")
pred = bundle["booster"].predict(
    X_test, num_iteration=bundle["best_iteration"])
joblib は pickle を土台にしているため、保存時と読み込み時で LightGBM や NumPy のバージョンが大きくずれると失敗することがあります。長期保存にはネイティブ形式、短期の受け渡しには joblib と、目的で使い分けるのが安全です。
scikit-learn パイプラインと本番推論
本番の推論で最も事故が起きやすいのは、学習時と推論時で前処理がずれる場面です。学習では標準化やエンコードをしていたのに、推論側で同じ変換を再現し損ねると、モデルは静かに誤った予測を返し続けます。これを防ぐ最も確実な方法が、前処理とモデルを一つの scikit-learn パイプラインに束ねることです。
パイプライン全体を一つの成果物として保存すれば、推論側は生の入力を渡すだけで、学習時とまったく同じ変換を経て予測が返ります。前処理の再現漏れという典型的な不具合を、構造的に取り除けます。
import pandas as pd
from sklearn.pipeline import Pipeline
from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import StandardScaler, OneHotEncoder
from lightgbm import LGBMClassifier

# 数値列とカテゴリ列が混在した入力を想定する
df = pd.DataFrame(X_train, columns=[f"f{i}" for i in range(X_train.shape[1])])
df["region"] = np.random.choice(["east", "west", "north"], len(df))

numeric = [c for c in df.columns if c.startswith("f")]
categorical = ["region"]

pre = ColumnTransformer([
    ("num", StandardScaler(), numeric),
    ("cat", OneHotEncoder(handle_unknown="ignore"), categorical),
])

pipe = Pipeline([
    ("pre", pre),
    ("model", LGBMClassifier(n_estimators=400, num_leaves=31,
                             learning_rate=0.05, random_state=42)),
])

pipe.fit(df, y_train)

# パイプラインごと保存すれば前処理も一緒に持ち運べる
joblib.dump(pipe, "pipeline.joblib")

# 本番側は生の DataFrame を渡すだけでよい
service = joblib.load("pipeline.joblib")
proba = service.predict_proba(df.iloc[:3])[:, 1]
print("陽性確率:", np.round(proba, 4))
OneHotEncoder に handle_unknown="ignore" を指定している点にも触れておきます。本番では学習時に存在しなかったカテゴリが入力されることが珍しくありません。この指定があれば、未知のカテゴリを全ゼロのベクトルとして扱い、例外で推論が止まる事態を避けられます。
ONNX へのエクスポート
Python のランタイムを持たない環境や、推論の遅延を切り詰めたい場面では、モデルを ONNX 形式に書き出す選択肢があります。ONNX は機械学習モデルの共通フォーマットで、ONNX Runtime を使えば C#、Java、C++ など多様な言語から同じモデルを高速に呼び出せます。.NET のバックエンドに予測機能を組み込む場合にも扱いやすい形式です。
from skl2onnx import to_onnx
from skl2onnx.common.data_types import FloatTensorType
import onnxruntime as ort

# 数値のみの LGBMClassifier を ONNX に変換する例
clf = LGBMClassifier(n_estimators=300, num_leaves=31, random_state=42)
clf.fit(X_train, y_train)

initial_type = [("input", FloatTensorType([None, X_train.shape[1]]))]
onnx_model = to_onnx(clf, initial_types=initial_type,
                     target_opset={"": 17, "ai.onnx.ml": 3})

with open("model.onnx", "wb") as f:
    f.write(onnx_model.SerializeToString())

# ONNX Runtime で推論する
sess = ort.InferenceSession("model.onnx")
input_name = sess.get_inputs()[0].name
X_in = X_test[:5].astype(np.float32)
label, proba = sess.run(None, {input_name: X_in})
print("予測ラベル:", label)
変換で注意したいのは、元のモデルと ONNX 版で予測値がわずかにずれる場合がある点です。内部の数値型や丸めの違いが原因で、多くは無視できる範囲ですが、確率を厳密に扱う用途では、変換後に元モデルとの差分を検証しておくべきです。ColumnTransformer を含むパイプライン全体も ONNX に変換できますが、対応していない変換器もあるため、複雑な前処理では一部を Python 側に残す構成のほうが現実的なこともあります。
SHAP でモデルの判断根拠を示す
本番でモデルを使う以上、「なぜこの予測になったのか」を説明できることは、精度と同じくらい重要です。第4回で扱った特徴量重要度はモデル全体の傾向を示しますが、個々の予測がどう決まったかまでは語りません。SHAP はこの隙間を埋め、ある一件の予測に対して各特徴量がどれだけ寄与したかを、加法的に分解して示します。
LightGBM は木ベースのため、SHAP の中でも高速な TreeExplainer が使えます。大量のサンプルに対しても現実的な時間で寄与度を計算できます。
import shap

explainer = shap.TreeExplainer(booster)
shap_values = explainer.shap_values(X_test)

# 1 件の予測を構成する寄与度を確認する
i = 0
base = explainer.expected_value
contrib = shap_values[i]
print("ベース値:", round(float(base), 4))
print("寄与の大きい特徴量トップ3:")
order = np.argsort(np.abs(contrib))[::-1][:3]
for j in order:
    print(f"  f{j}: 寄与 {contrib[j]:+.4f}, 値 {X_test[i, j]:.3f}")

# 全サンプルにわたる特徴量の平均的な影響(要約プロット用の値)
mean_abs = np.abs(shap_values).mean(axis=0)
top = np.argsort(mean_abs)[::-1][:5]
print("影響の大きい特徴量:", [f"f{j}" for j in top])
SHAP の値は、ベース値に各特徴量の寄与を足し合わせると、その予測値に一致するという性質を持ちます。この加法性のおかげで、審査や与信のように説明責任が問われる場面でも、一件ごとに根拠を提示できます。運用では、予測 API のレスポンスに寄与度上位の特徴量を添えておくと、担当者が結果を検証しやすくなります。
運用を支えるベストプラクティス
モデルは一度デプロイして終わりではありません。データは時間とともに変わり、モデルの精度は静かに劣化していきます。長く使い続けるために押さえておきたい観点を整理します。
再現性を確保する
同じデータと設定から同じモデルが再現できることは、運用の土台です。乱数シードの固定に加えて、学習に使ったデータのバージョン、特徴量の一覧、ハイパーパラメータ、ライブラリのバージョンを、モデルと一緒に記録しておきます。これらが揃っていれば、障害調査や監査のときに「そのとき何を学習したのか」を正確にたどれます。
予測とデータドリフトを監視する
精度の劣化は、正解ラベルが遅れて届く業務では気づきにくいものです。そこで、正解を待たずに監視できる指標として、入力データの分布と予測値の分布を継続的に観察します。学習時の分布と本番の分布を統計的に比較し、ずれが一定を超えたら警告を出す仕組みが有効です。
from scipy import stats

def detect_drift(reference, current, threshold=0.05):
    """数値特徴量ごとに KS 検定でドリフトを判定する"""
    report = {}
    for j in range(reference.shape[1]):
        stat, p = stats.ks_2samp(reference[:, j], current[:, j])
        report[f"f{j}"] = {"p_value": round(float(p), 4),
                           "drift": bool(p < threshold)}
    return report

# 学習時データを基準に、本番の直近データと比較する
result = detect_drift(X_train, X_test)
drifted = [k for k, v in result.items() if v["drift"]]
print("ドリフトの疑いがある特徴量:", drifted)
データドリフトの検知は、あくまで再学習を検討する「きっかけ」を与えるものです。ドリフトが即座に精度低下を意味するわけではないため、警告が出たら実際の性能指標も併せて確認し、対応を判断します。
再学習の方針を決めておく
再学習は、決まった間隔で回す定期的なものと、ドリフトや精度低下を検知して回すトリガー型に分けられます。どちらを採るにせよ、新しいモデルをいきなり全量に適用するのは避け、まず一部のトラフィックで新旧を比較してから切り替えると安全です。切り替え前後の指標を記録しておけば、問題が起きたときに元のモデルへ戻す判断も素早く下せます。
よくある落とし穴
シリーズ全体を通じて繰り返し現れた注意点を、運用の視点で改めてまとめます。
- 学習と推論の前処理のずれ — 別々に実装した前処理は必ずどこかでずれます。パイプラインに束ねて一つの成果物として扱うのが確実です。
- 検証への情報漏れ — 標準化やターゲットエンコードを全データで先に計算すると、検証スコアが本番で再現しません。前処理は分割の内側で行います。
- 反復数の指定漏れ — 推論時に
best_iterationを渡し忘れると、早期終了の意味が失われます。保存時に反復数を焼き込んでおくと安全です。 - カテゴリの扱いの不一致 — 未知カテゴリで推論が止まらないよう、エンコーダー側で明示的に扱いを決めておきます。
- デプロイ後の放置 — 監視の仕組みがないモデルは、劣化に気づけません。ドリフトと性能の観察を運用に組み込みます。
まとめ
最終回では、精度を作る段階から一歩進めて、モデルを本番で使い続けるための設計を扱いました。要点を振り返ります。
- 保存は目的で使い分ける。長期保存や言語をまたぐ配布にはネイティブ形式、周辺オブジェクトごとの受け渡しには joblib が向く。
- 前処理とモデルをパイプラインに束ねると、学習と推論のずれという最も多い不具合を構造的に防げる。
- ONNX への書き出しで、Python 以外のランタイムからの高速な推論や、.NET バックエンドへの組み込みが視野に入る。
- SHAP は個々の予測を加法的に分解し、説明責任の求められる場面で判断根拠を示す手段になる。
- 再現性の記録、データドリフトの監視、再学習の方針をあらかじめ決めておくことが、モデルを長く健全に保つ。
全6回を通じて、勾配ブースティングの原理から本番運用までを一続きに歩いてきました。LightGBM は学習の速さと扱いやすさが際立つ一方、その真価は、堅実な検証と運用設計と組み合わせたときにこそ発揮されます。本連載が、皆様の機械学習プロジェクトを前へ進める一助になれば幸いです。
エンハンスド株式会社では、機械学習モデルの設計と検証から、ONNX を用いた .NET システムへの組み込み、モデル運用基盤の整備までを一貫してご支援しています。予測モデルの本番導入や、既存の分析フローの信頼性向上をご検討の際は、ぜひお気軽にご相談ください。
参考リンク
本連載の全体像は Python×LightGBM入門(第1回 基礎と環境構築) にまとめています。
本連載「Python×LightGBM入門」全6回
- 第1回 勾配ブースティングの基礎と環境構築
- 第2回 分類問題の実装とモデル評価
- 第3回 回帰問題とハイパーパラメータ調整
- 第4回 特徴量エンジニアリングと重要度分析
- 第5回 交差検証とアンサンブル学習
- 第6回 実践応用とベストプラクティス(本記事)
この記事をシェア
関連記事
【Python×LightGBM入門】第4回 特徴量エンジニアリングと重要度分析
第3回までで、LightGBM の学習・評価とパラメータ調整の基本を扱ってきました。第4回のテーマは、モデルの精度を最終的に左右する 特徴量エンジニアリング です。…
Python×LightGBM入門 第1回 勾配ブースティングの基礎と環境構築
表形式データの予測タスクにおいて、 勾配ブースティング決定木 は現在でも最も信頼される手法のひとつです。なかでも LightGBM は、学習の速さと精度の高さを両立し、…
Python×LightGBM入門 第2回 分類問題の実装とモデル評価
本記事は全6回でお届けする「Python × LightGBM 入門」の第2回です。第1回では勾配ブースティング決定木の考え方と環境構築、最小構成での学習・予測までを扱いました。…