はじめに
本記事は全6回でお届けする「Python × LightGBM 入門」の第2回です。第1回では勾配ブースティング決定木の考え方と環境構築、最小構成での学習・予測までを扱いました。今回はいよいよ実践に踏み込み、分類問題を題材に、目的関数と評価指標の選び方から、クラス不均衡への対処、混同行列や ROC/AUC を使ったモデル評価、そして予測確率と閾値の扱いまでを順を追って解説します。
分類は機械学習のなかでも登場頻度が高いタスクです。顧客が離脱するかどうか、取引が不正かどうか、メールが迷惑メールかどうかといった判断は、いずれも分類として定式化できます。本記事では Python 3.12 以上と最新の LightGBM を前提に、手を動かしながら実務で使える型を身につけていきます。コードは順番に実行できるよう構成しているので、手元の環境で試しながら読み進めてください。
分類問題の種類と目的関数
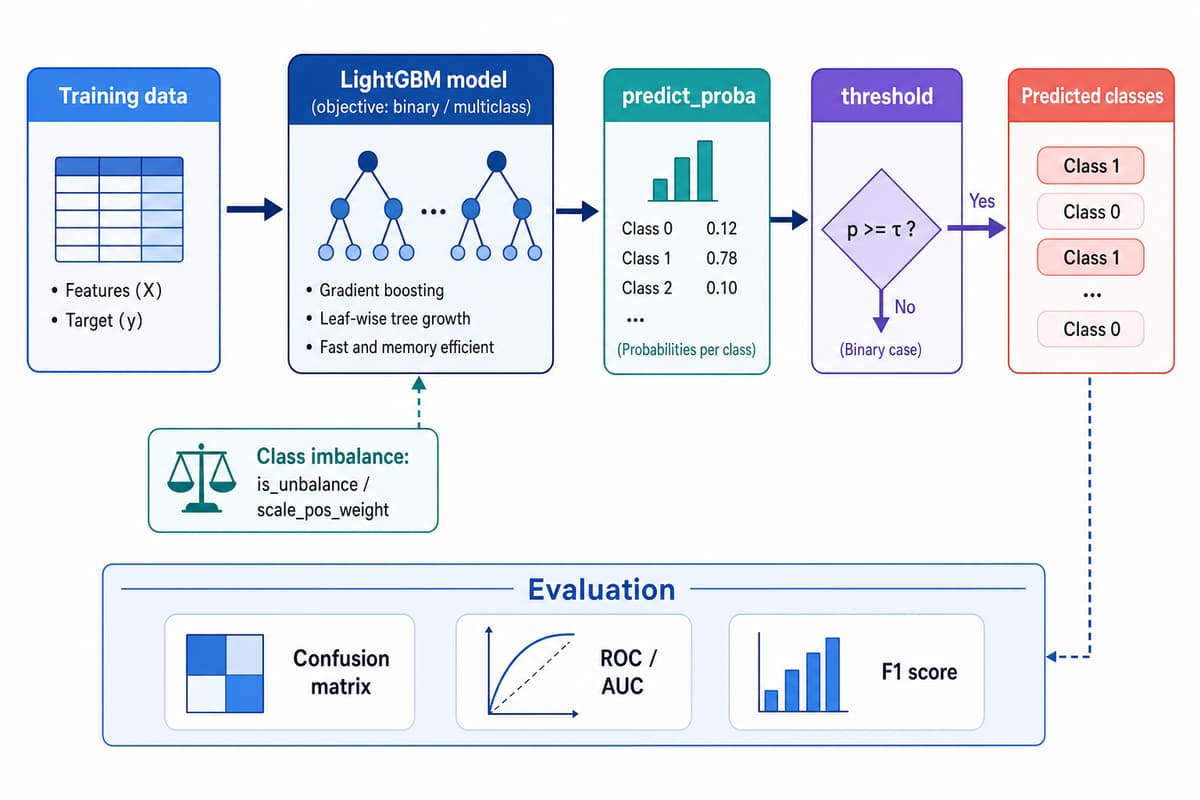
LightGBM で分類に取り組む際、最初に決めるのは objective(目的関数)です。解きたい問題が「はい/いいえ」の二者択一なのか、三つ以上のクラスへの振り分けなのかによって、指定する値が変わります。
- binary — 二値分類に使います。離脱するか否か、不正か正常かといった2クラスの問題が対象です。出力は「陽性クラスに属する確率」になります。
- multiclass — 3クラス以上の多クラス分類に使います。
num_classでクラス数をあわせて指定し、出力は各クラスに属する確率のベクトルになります。
目的関数はモデルが学習中に最小化する損失を定めるもので、分類の骨格を決める設定です。まずは本記事の中心となる二値分類を掘り下げ、記事後半で多クラス分類への拡張を扱います。
題材とするデータセット
ここでは、通信サービスの顧客離脱予測(チャーン予測)を題材にします。契約期間や料金、契約形態といった属性から、その顧客が解約するかどうかを予測する二値分類問題です。実務でも需要の高いテーマであり、後述するクラス不均衡の問題も自然に登場します。
本来は実データを読み込みますが、ここでは再現しやすいよう擬似的な顧客データを生成して進めます。
import numpy as np
import pandas as pd
import lightgbm as lgb
from sklearn.model_selection import train_test_split

rng = np.random.default_rng(42)
n_samples = 10000

data = pd.DataFrame({
    "age": rng.integers(18, 70, n_samples),
    "tenure": rng.integers(0, 72, n_samples),          # 契約月数
    "monthly_charges": rng.uniform(20, 120, n_samples),
    "total_charges": rng.uniform(100, 8000, n_samples),
    "contract": rng.choice(["Month-to-month", "One year", "Two year"], n_samples),
    "internet_service": rng.choice(["DSL", "Fiber optic", "No"], n_samples),
    "payment_method": rng.choice(["Electronic check", "Mailed check", "Bank transfer", "Credit card"], n_samples),
})

# 契約が月単位で在籍が短い顧客ほど離脱しやすい、という傾向を反映
churn_prob = 0.15 + 0.30 * (data["contract"] == "Month-to-month") - 0.15 * (data["tenure"] > 24)
churn_prob = churn_prob.clip(0.02, 0.95)
data["churn"] = rng.binomial(1, churn_prob)

print(f"データ形状: {data.shape}")
print(f"離脱率: {data['churn'].mean():.2%}")
離脱率はおよそ2割前後になります。陽性(離脱)が少数派となるため、後ほどクラス不均衡への配慮が必要になる点を意識しておいてください。
特徴量の準備とデータ分割
LightGBM はカテゴリ変数を内部で直接扱えます。ここでは文字列のカテゴリ列を pandas の category 型に変換し、そのまま渡す方法をとります。ワンホットエンコーディングのような前処理を挟まずに済むのが LightGBM の利点です。
categorical_cols = ["contract", "internet_service", "payment_method"]
for col in categorical_cols:
    data[col] = data[col].astype("category")

feature_cols = ["age", "tenure", "monthly_charges", "total_charges"] + categorical_cols
X = data[feature_cols]
y = data["churn"]

# 学習・検証・テストを 60:20:20 に分割し、クラス比率を維持する
X_temp, X_test, y_temp, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)
X_train, X_val, y_train, y_val = train_test_split(
    X_temp, y_temp, test_size=0.25, random_state=42, stratify=y_temp
)

print(f"学習: {X_train.shape}, 検証: {X_val.shape}, テスト: {X_test.shape}")
分割時に stratify=y を指定すると、各データセットの離脱率がほぼ揃います。不均衡なデータでは、この層化抽出を行わないと分割ごとにクラス比率が偏り、評価が不安定になりやすいので注意してください。
モデルの学習と早期終了
いよいよ学習に入ります。二値分類なので objective は binary、学習中の評価指標には対数損失(binary_logloss)と AUC を指定します。木の本数は多めに設定したうえで、検証データの精度が改善しなくなった時点で学習を打ち切る早期終了(early_stopping)を組み合わせ、過学習を抑えつつ適切な反復回数を自動で見極めます。
train_set = lgb.Dataset(X_train, label=y_train, categorical_feature=categorical_cols)
valid_set = lgb.Dataset(X_val, label=y_val, categorical_feature=categorical_cols, reference=train_set)

params = {
    "objective": "binary",          # 二値分類
    "metric": ["binary_logloss", "auc"],
    "learning_rate": 0.05,
    "num_leaves": 31,
    "feature_fraction": 0.9,
    "bagging_fraction": 0.8,
    "bagging_freq": 5,
    "verbose": -1,
    "seed": 42,
}

model = lgb.train(
    params,
    train_set,
    num_boost_round=1000,
    valid_sets=[train_set, valid_set],
    valid_names=["train", "valid"],
    callbacks=[
        lgb.early_stopping(stopping_rounds=50),
        lgb.log_evaluation(period=100),
    ],
)

print(f"最適な反復回数: {model.best_iteration}")
評価指標として対数損失と AUC の両方を渡していますが、早期終了は最後に指定した指標(ここでは AUC)を基準に判断します。損失の絶対値ではなく順位の良さを重視したい場合、AUC を基準にするのは分類では自然な選択です。
評価指標の意味を押さえる
分類の評価では、単一の数値だけを見て判断しないことが肝心です。それぞれの指標が何を測っているのかを整理しておきます。
- 正解率(accuracy) — 全体のうち正しく分類できた割合です。直感的ですが、不均衡データでは多数派を当てるだけで高く見えてしまう欠点があります。
- 適合率(precision) — 陽性と予測したもののうち、実際に陽性だった割合です。誤検知のコストが高い場面で重視します。
- 再現率(recall) — 実際の陽性のうち、正しく陽性と予測できた割合です。見逃しのコストが高い場面で重視します。
- F1 スコア — 適合率と再現率の調和平均で、両者のバランスを1つの数値で表します。
- AUC — 予測確率の順位づけの良さを表し、閾値に依存せずモデルの識別力を測れます。不均衡データでも比較的安定した指標です。
クラス不均衡への対処
離脱予測のように陽性が少数派の問題では、モデルが多数派(非離脱)ばかりを予測して見かけ上の正解率だけが高くなりがちです。LightGBM には、この偏りを緩和するための設定がいくつか用意されています。
- is_unbalance —
Trueにすると、クラスの出現頻度から重みを自動で調整します。手軽に試せる出発点です。 - scale_pos_weight — 陽性クラスの重みを数値で明示的に指定します。おおよそ「陰性の件数 ÷ 陽性の件数」を目安に設定します。
is_unbalance と scale_pos_weight は役割が重複するため、両方を同時に指定するのは避け、どちらか一方を使います。ここでは陰陽比から重みを計算して scale_pos_weight を渡します。
n_pos = int(y_train.sum())
n_neg = int(len(y_train) - n_pos)
scale_pos_weight = n_neg / n_pos
print(f"scale_pos_weight の目安: {scale_pos_weight:.2f}")

params_balanced = params.copy()
params_balanced["scale_pos_weight"] = scale_pos_weight

model_balanced = lgb.train(
    params_balanced,
    train_set,
    num_boost_round=1000,
    valid_sets=[valid_set],
    valid_names=["valid"],
    callbacks=[lgb.early_stopping(50), lgb.log_evaluation(100)],
)
重みを調整すると、少数派である離脱顧客の再現率が上がりやすくなる一方、誤検知が増えて適合率は下がる傾向があります。どちらを優先するかはビジネス上のコスト次第です。なお scikit-learn 互換 API を使う場合は、LGBMClassifier(class_weight="balanced") でも同様の調整ができます。
予測・閾値・混同行列
学習したモデルで予測を行います。predict が返すのは0から1の確率であり、そのままではクラスラベルになりません。二値分類では、確率を閾値(既定では0.5)と比較して0または1に変換します。scikit-learn 互換 API の場合は、確率を predict_proba で、閾値0.5で二値化したラベルを predict で得られます。
from sklearn.metrics import (
    accuracy_score, precision_score, recall_score, f1_score,
    roc_auc_score, confusion_matrix,
)

y_proba = model.predict(X_test, num_iteration=model.best_iteration)
y_pred = (y_proba >= 0.5).astype(int)

print(f"Accuracy : {accuracy_score(y_test, y_pred):.4f}")
print(f"Precision: {precision_score(y_test, y_pred):.4f}")
print(f"Recall   : {recall_score(y_test, y_pred):.4f}")
print(f"F1       : {f1_score(y_test, y_pred):.4f}")
print(f"AUC      : {roc_auc_score(y_test, y_proba):.4f}")

cm = confusion_matrix(y_test, y_pred)
tn, fp, fn, tp = cm.ravel()
print(f"\n混同行列  TN={tn}  FP={fp}  FN={fn}  TP={tp}")
混同行列は、予測と実際の組み合わせを真陰性(TN)・偽陽性(FP)・偽陰性(FN)・真陽性(TP)の4区分で表します。離脱予測では、離脱しそうな顧客を見逃す偽陰性(FN)が事業上の損失に直結するため、この値を注視するとよいでしょう。適合率や再現率も、すべてこの4つの値から導かれます。
閾値の調整
閾値は0.5に固定する必要はありません。見逃しを減らしたい(再現率を上げたい)なら閾値を下げ、誤検知を減らしたい(適合率を上げたい)なら閾値を上げます。ここでは F1 スコアが最大となる閾値を探してみます。
thresholds = np.arange(0.10, 0.90, 0.05)
scored = [(t, f1_score(y_test, (y_proba >= t).astype(int))) for t in thresholds]
best_threshold, best_f1 = max(scored, key=lambda x: x[1])

print(f"F1 が最大となる閾値: {best_threshold:.2f} (F1={best_f1:.4f})")
最適な閾値は0.5から離れることが珍しくありません。とくにクラス不均衡がある場合、閾値の見直しはモデルの再学習をせずに性能バランスを調整できる有効な手段です。運用時は、実際の意思決定コストに照らして閾値を決めるのが実務的です。
ROC 曲線と AUC
AUC は閾値に依存せずモデルの識別力を評価できる指標で、ROC 曲線の下側の面積として求められます。閾値をどう動かすかを決める前に、モデル自体の素性を確認するのに向いています。
from sklearn.metrics import roc_curve, auc

fpr, tpr, _ = roc_curve(y_test, y_proba)
print(f"ROC-AUC: {auc(fpr, tpr):.4f}")
AUC は0.5でランダム、1.0で完全な識別を意味します。値だけでなく、必要に応じて fpr と tpr を描画し、どの動作点で運用するかを検討すると理解が深まります。
多クラス分類への拡張
ここまでは二値分類を扱ってきましたが、3クラス以上の多クラス分類も設定を少し変えるだけで対応できます。objective を multiclass にし、num_class でクラス数を指定します。予測結果は各クラスの確率が並んだ配列になるため、最も確率の高いクラスを argmax で選びます。
from sklearn.datasets import load_iris

iris = load_iris()
Xm_train, Xm_test, ym_train, ym_test = train_test_split(
    iris.data, iris.target, test_size=0.2, random_state=42, stratify=iris.target
)

mc_params = {
    "objective": "multiclass",   # 多クラス分類
    "num_class": 3,              # クラス数
    "metric": "multi_logloss",
    "learning_rate": 0.05,
    "num_leaves": 15,
    "verbose": -1,
    "seed": 42,
}

mc_train = lgb.Dataset(Xm_train, label=ym_train)
mc_model = lgb.train(mc_params, mc_train, num_boost_round=200)

proba = mc_model.predict(Xm_test)     # 形状は (サンプル数, クラス数)
pred = np.argmax(proba, axis=1)
print(f"正解率: {accuracy_score(ym_test, pred):.4f}")
多クラスでは、二値の適合率・再現率・F1 をクラスごとに算出したうえで平均をとります。scikit-learn の classification_report を使うと、クラス別のスコアと平均を一度に確認できて便利です。目的関数と評価指標さえ問題に合わせれば、学習・予測・評価の流れは二値分類とほとんど変わりません。
まとめ
第2回では、LightGBM を使った分類問題の実装と評価をひと通りたどりました。要点を振り返ります。
- 目的関数は問題に合わせて選び、二値分類は
binary、多クラス分類はmulticlassとnum_classを指定する。 - 不均衡データでは正解率だけで判断せず、適合率・再現率・F1・AUC を組み合わせて多面的に評価する。
predictが返す確率は閾値で二値化する。閾値は再学習なしで性能バランスを調整できる有効な手段である。- クラス不均衡には
is_unbalanceやscale_pos_weightで対処し、混同行列で誤りの内訳を確認する。
次回の第3回では、回帰問題への適用とパラメータチューニングを取り上げます。分類で身につけた評価の考え方を土台に、モデルの性能をさらに引き出す調整の勘所を掘り下げていきます。
エンハンスド株式会社では、分類・回帰といった予測モデルの構築から、データ活用基盤の整備、業務システムへの組み込みまでを一貫してご支援しています。離脱予測や需要予測などの機械学習の導入、既存分析の高度化をご検討の際は、ぜひお気軽にご相談ください。
本連載の全体像は Python×LightGBM入門(第1回 基礎と環境構築) にまとめています。
本連載「Python×LightGBM入門」全6回
- 第1回 勾配ブースティングの基礎と環境構築
- 第2回 分類問題の実装とモデル評価(本記事)
- 第3回 回帰問題とハイパーパラメータ調整
- 第4回 特徴量エンジニアリングと重要度分析
- 第5回 交差検証とアンサンブル学習
- 第6回 実践応用とベストプラクティス
この記事をシェア
関連記事
Python×LightGBM入門 第1回 勾配ブースティングの基礎と環境構築
表形式データの予測タスクにおいて、 勾配ブースティング決定木 は現在でも最も信頼される手法のひとつです。なかでも LightGBM は、学習の速さと精度の高さを両立し、…
【Python×LightGBM入門】第3回 回帰問題とハイパーパラメータ調整
本連載「Python × LightGBM 入門」の第3回です。前回は二値分類を題材に、データの前処理からモデル評価までの流れを確認しました。今回は 回帰問題 への適用と、…
【Python×LightGBM入門】第4回 特徴量エンジニアリングと重要度分析
第3回までで、LightGBM の学習・評価とパラメータ調整の基本を扱ってきました。第4回のテーマは、モデルの精度を最終的に左右する 特徴量エンジニアリング です。…