はじめに
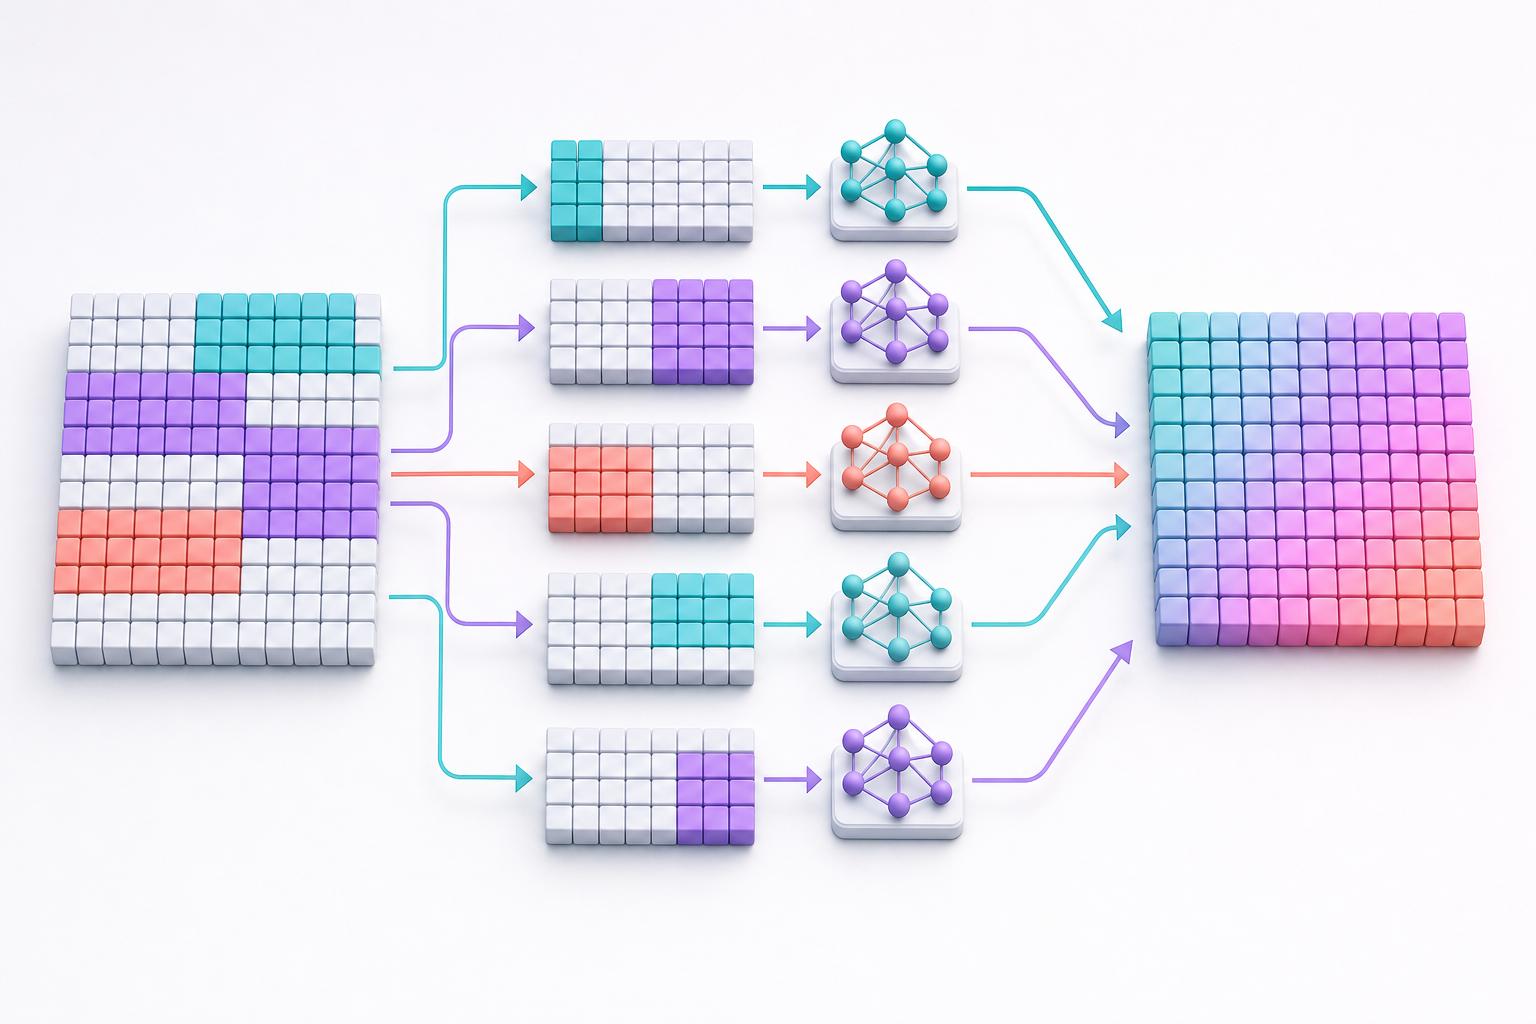
本記事は全6回でお届けする「Python × LightGBM 入門」の第5回です。第4回までで、分類・回帰の実装から特徴量エンジニアリングと重要度分析までを扱ってきました。今回のテーマは、モデルの実力を正しく測るための交差検証と、複数のモデルを束ねて精度と安定性を引き上げるアンサンブル学習です。
単一のホールドアウト検証だけでは、たまたま都合のよい(あるいは悪い)分割に当たっただけなのか、それとも本当に汎化する性能なのかを見分けにくいという課題があります。交差検証はこの不確かさを和らげ、スコアのばらつきまで含めてモデルを評価する枠組みです。さらに、交差検証で得られた複数のモデルや予測をそのままアンサンブルの材料として活用できます。今回は、この二つを一続きの流れとして丁寧に組み立てていきます。コードは LightGBM 4 系と scikit-learn 1.5 以降を前提としています。
題材データと交差検証の分割設計
今回は信用リスク評価(与信判定)を題材にした二値分類を扱います。まず、以降のコードで共通して使うデータと特徴量を準備します。実データの代わりに、リスク要因から確率を組み立てた合成データを用います。
import numpy as np
import pandas as pd
import lightgbm as lgb
from sklearn.model_selection import (
    KFold, StratifiedKFold, GroupKFold, TimeSeriesSplit, train_test_split,
)
from sklearn.metrics import roc_auc_score
from sklearn.preprocessing import LabelEncoder

rng = np.random.default_rng(42)
n = 10000

data = pd.DataFrame({
    "age": rng.integers(20, 70, n),
    "annual_income": rng.lognormal(10.5, 0.6, n),
    "employment_years": rng.exponential(5, n),
    "credit_utilization": rng.beta(2, 5, n),
    "num_late_payments": rng.negative_binomial(1, 0.3, n),
    "debt_to_income": rng.beta(2, 8, n),
    "branch_id": rng.integers(0, 50, n),       # 顧客が属する支店(グループ分割に使用)
    "application_month": rng.integers(0, 24, n),  # 申込月(時系列分割に使用)
    "employment_type": rng.choice(
        ["Full-time", "Part-time", "Self-employed", "Unemployed"], n,
        p=[0.6, 0.15, 0.2, 0.05]),
})

# リスク要因からデフォルト確率を組み立てる
prob = (
    0.10
    + 0.30 * (data["debt_to_income"] > 0.4)
    + 0.20 * (data["num_late_payments"] > 2)
    + 0.15 * (data["credit_utilization"] > 0.8)
    + 0.10 * (data["employment_type"] == "Unemployed")
    - 0.10 * (data["annual_income"] > 100000)
)
data["default"] = rng.binomial(1, np.clip(prob, 0, 1))

data["employment_type"] = LabelEncoder().fit_transform(data["employment_type"])

feature_cols = [c for c in data.columns if c != "default"]
X, y = data[feature_cols], data["default"]
print(f"サンプル数: {len(X)} / デフォルト率: {y.mean():.2%}")
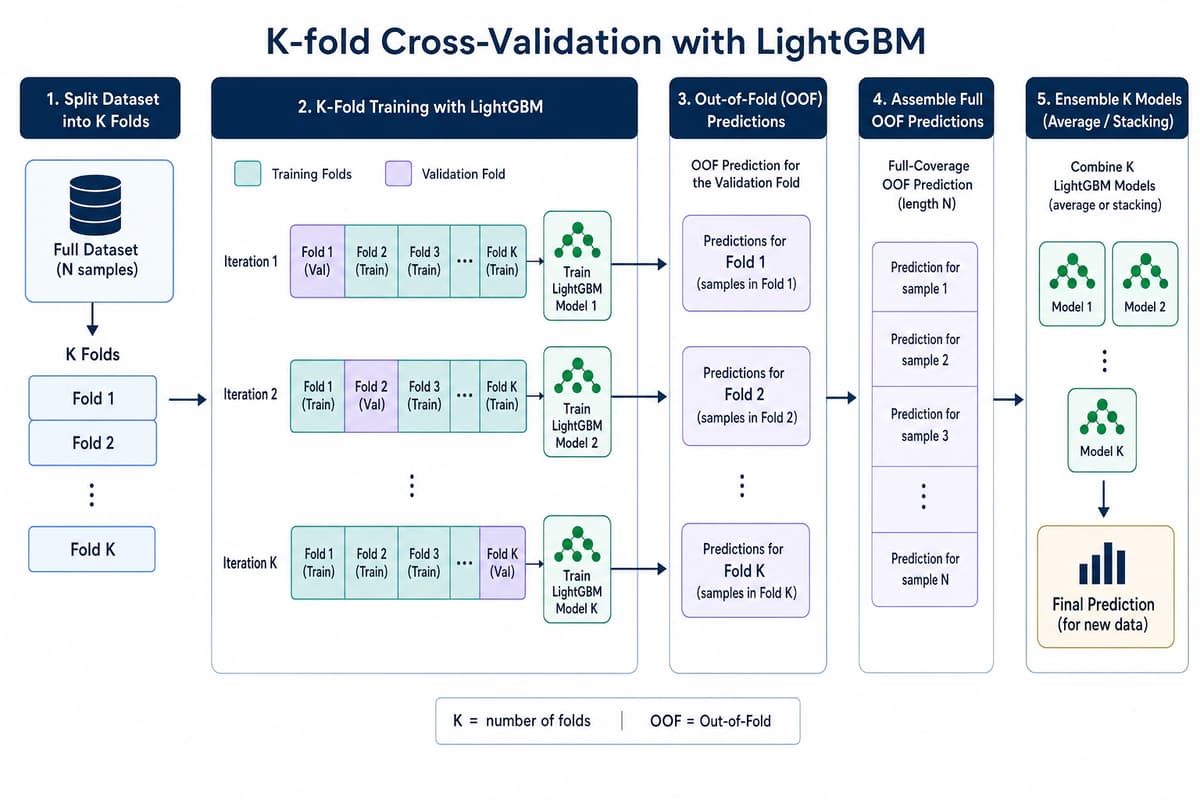
交差検証は「データをどう分割するか」で性質が大きく変わります。代表的な四つの分割を、それぞれ適した場面とあわせて整理します。
- KFold — 単純にデータを K 個に等分する基本形。サンプルが独立同分布とみなせる場合の標準的な選択肢です。
- StratifiedKFold — 各 fold のクラス比率を全体に揃える層化分割。今回のようにクラスが偏った分類では既定で選びたい方法です。
- GroupKFold — 同じグループ(同一顧客や同一支店など)が訓練と検証にまたがらないように分割する方法。グループ単位でしか汎化を語れない場面で使います。
- TimeSeriesSplit — 時間順を保ち、過去で学習して未来を検証する分割。申込月のように時間構造を持つデータで必要になります。
次のコードは、それぞれの分割が生成する fold のクラス比率やグループの重なりを確認するものです。分割器を差し替えるだけで挙動を比べられます。
# 層化分割: 各 fold のデフォルト率が全体とほぼ一致する
skf = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)
for i, (tr, va) in enumerate(skf.split(X, y), 1):
    print(f"[Stratified] fold{i} 検証デフォルト率: {y.iloc[va].mean():.2%}")

# グループ分割: 支店 ID が訓練と検証に重複しないことを確認
gkf = GroupKFold(n_splits=5)
for i, (tr, va) in enumerate(gkf.split(X, y, groups=data["branch_id"]), 1):
    overlap = set(data["branch_id"].iloc[tr]) & set(data["branch_id"].iloc[va])
    print(f"[Group] fold{i} 支店の重複数: {len(overlap)}")  # 常に 0

# 時系列分割: 検証区間は必ず訓練区間より後の申込月になる
order = data["application_month"].argsort()
tscv = TimeSeriesSplit(n_splits=5)
for i, (tr, va) in enumerate(tscv.split(order), 1):
    print(f"[TimeSeries] fold{i} 訓練 {len(tr)} 件 / 検証 {len(va)} 件")
lgb.cv と早期終了で反復回数を決める
アンサンブルの前に、まず適切な木の本数(num_boost_round)を見積もる必要があります。ここで役立つのが lgb.cv です。指定した分割で交差検証を行いながら、各反復での検証スコアを集計し、早期終了と組み合わせて最適な反復回数を教えてくれます。個別に fold を回すよりも簡潔に書けます。
params = {
    "objective": "binary",
    "metric": "auc",
    "boosting_type": "gbdt",
    "num_leaves": 31,
    "learning_rate": 0.05,
    "feature_fraction": 0.9,
    "bagging_fraction": 0.8,
    "bagging_freq": 5,
    "verbose": -1,
    "seed": 42,
}

dtrain = lgb.Dataset(X, label=y)

cv_result = lgb.cv(
    params,
    dtrain,
    num_boost_round=2000,
    folds=StratifiedKFold(n_splits=5, shuffle=True, random_state=42),
    callbacks=[lgb.early_stopping(100), lgb.log_evaluation(0)],
    return_cvbooster=True,
)

mean_auc = cv_result["valid auc-mean"]
best_round = len(mean_auc)
print(f"最適反復回数: {best_round}")
print(f"CV 平均 AUC: {mean_auc[-1]:.4f} (+/- {cv_result['valid auc-stdv'][-1]:.4f})")
ここで得られた best_round は、後続の学習で反復回数の目安として使えます。valid auc-mean と valid auc-stdv の両方を見て、平均だけでなくばらつきの大きさも確認しておくと、モデルの安定性を判断しやすくなります。標準偏差が不自然に小さい場合は、後述するリークを疑う手がかりにもなります。
学習率を下げるほど必要な反復回数は増え、精度も伸びやすくなりますが、そのぶん学習時間と過学習のリスクが上がります。まずは learning_rate を 0.05 前後に固定して lgb.cv で反復回数の当たりを付け、その後に num_leaves や正則化パラメータを調整するという順序で進めると、探索の見通しが立てやすくなります。パラメータ調整の詳しい手順は第3回で扱った内容とあわせてご確認ください。
Out-of-Fold 予測を軸に据える
交差検証の副産物として得られる Out-of-Fold(OOF)予測は、アンサンブルを設計するうえで中心的な役割を果たします。OOF 予測とは、各サンプルを「そのサンプルが検証側に回った fold のモデル」だけで予測した値のことです。どのサンプルも学習に使われていないモデルから予測されるため、訓練データ全体に対して漏れのない検証スコアを得られます。同時に、各 fold のモデルはテストデータへの予測を平均する形でそのまま推論に使えます。
def train_oof(X, y, params, n_splits=5, num_boost_round=500, seed=42):
    """OOF 予測と各 fold のモデルを返す"""
    skf = StratifiedKFold(n_splits=n_splits, shuffle=True, random_state=seed)
    oof = np.zeros(len(X))
    models = []

    for tr, va in skf.split(X, y):
        dtr = lgb.Dataset(X.iloc[tr], label=y.iloc[tr])
        dva = lgb.Dataset(X.iloc[va], label=y.iloc[va], reference=dtr)
        model = lgb.train(
            params, dtr,
            valid_sets=[dva],
            num_boost_round=num_boost_round,
            callbacks=[lgb.early_stopping(100), lgb.log_evaluation(0)],
        )
        oof[va] = model.predict(X.iloc[va], num_iteration=model.best_iteration)
        models.append(model)

    print(f"OOF AUC: {roc_auc_score(y, oof):.4f}")
    return oof, models


def predict_folds(models, X_new):
    """各 fold モデルの予測を平均して推論する"""
    preds = [m.predict(X_new, num_iteration=m.best_iteration) for m in models]
    return np.mean(preds, axis=0)


oof_lgb, lgb_models = train_oof(X, y, params)
この OOF スコアは、テストデータに対する性能の妥当な推定値になります。以降で扱うスタッキングやブレンディングも、この OOF 予測をメタ特徴量として組み立てていきます。
アンサンブルの実践
アンサンブルの狙いは、誤りの傾向が異なるモデルを組み合わせ、互いの弱点を打ち消し合うことにあります。逆に言えば、多様性が乏しく同じような誤り方をするモデルをいくら束ねても効果は限られます。多様性は、乱数シードを変える、学習器の種類を変える、使う特徴量を変えるといった方法で生み出せます。効果を確認するときは、束ねたあとのスコアだけでなく、モデル間の予測がどれだけ相関しているかにも目を向けると判断しやすくなります。ここでは、実務で使いやすい三つの方法を順に見ていきます。
複数シードのバギング平均
最も手軽で効果が安定しているのが、乱数シードだけを変えて学習した複数モデルの予測を平均する方法です。LightGBM は特徴量サンプリングやバギングに乱数を使うため、シードを変えるだけでも少しずつ異なるモデルが得られます。これを平均すると、分割や初期値に由来する分散が減り、スコアが安定します。
seeds = [42, 43, 44, 45, 46]
oof_bag = np.zeros(len(X))
bag_models = []

for s in seeds:
    p = {**params, "seed": s, "bagging_seed": s, "feature_fraction_seed": s}
    oof_s, models_s = train_oof(X, y, p, seed=s)
    oof_bag += oof_s / len(seeds)
    bag_models.append(models_s)

print(f"単一シード OOF AUC : {roc_auc_score(y, oof_lgb):.4f}")
print(f"5 シード平均 OOF AUC: {roc_auc_score(y, oof_bag):.4f}")
スタッキング
スタッキングは、複数のベースモデルの OOF 予測を入力特徴量として、もう一段のメタモデルに学習させる方法です。ベースモデルには、傾向の異なる学習器を並べると効果が出やすくなります。ここでは LightGBM に加えてロジスティック回帰とランダムフォレストを用い、メタモデルにはロジスティック回帰を使います。メタ学習に OOF 予測を使う点が重要で、これによりリークを避けたまま二段目を学習できます。
from sklearn.linear_model import LogisticRegression
from sklearn.ensemble import RandomForestClassifier

def oof_sklearn(estimator, X, y, n_splits=5, seed=42):
    """scikit-learn 推定器の OOF 確率を返す"""
    skf = StratifiedKFold(n_splits=n_splits, shuffle=True, random_state=seed)
    oof = np.zeros(len(X))
    fitted = []
    for tr, va in skf.split(X, y):
        est = estimator.__class__(**estimator.get_params())
        est.fit(X.iloc[tr], y.iloc[tr])
        oof[va] = est.predict_proba(X.iloc[va])[:, 1]
        fitted.append(est)
    return oof, fitted

oof_lr, _ = oof_sklearn(LogisticRegression(max_iter=1000), X, y)
oof_rf, _ = oof_sklearn(RandomForestClassifier(n_estimators=300, random_state=42), X, y)

# ベースモデルの OOF をメタ特徴量にする
meta_X = np.column_stack([oof_lgb, oof_lr, oof_rf])
meta_model = LogisticRegression()

# メタモデル自体も交差検証で評価する
oof_stack = np.zeros(len(X))
skf = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)
for tr, va in skf.split(meta_X, y):
    meta_model.fit(meta_X[tr], y.iloc[tr])
    oof_stack[va] = meta_model.predict_proba(meta_X[va])[:, 1]

print(f"スタッキング OOF AUC: {roc_auc_score(y, oof_stack):.4f}")
ブレンディング
ブレンディングはスタッキングを簡略化した方法です。訓練データからブレンド用のホールドアウトを切り出し、その予測だけでメタモデルを学習します。fold ごとの学習を繰り返さないぶん実装が軽く、時間の制約が厳しい場面に向きます。一方で、メタ学習に使えるデータが減るため、データ量が少ないときはスタッキングのほうが安定します。
X_tr, X_blend, y_tr, y_blend = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y)

base = {
    "lgb": lgb.LGBMClassifier(n_estimators=300, num_leaves=31, random_state=42),
    "rf":  RandomForestClassifier(n_estimators=300, random_state=42),
    "lr":  LogisticRegression(max_iter=1000),
}

blend_feats = []
for name, est in base.items():
    est.fit(X_tr, y_tr)
    blend_feats.append(est.predict_proba(X_blend)[:, 1])

blend_X = np.column_stack(blend_feats)
blender = LogisticRegression().fit(blend_X, y_blend)
blend_pred = blender.predict_proba(blend_X)[:, 1]
print(f"ブレンディング AUC: {roc_auc_score(y_blend, blend_pred):.4f}")
リークを防ぐ検証設計
交差検証やアンサンブルの精度は、分割の設計を誤ると簡単に見かけ倒しになります。検証スコアが実運用で再現しない最大の原因はデータリーク、つまり本来知り得ない情報が学習に紛れ込むことです。設計時に押さえておきたい要点を整理します。
- 前処理は fold の内側で行う — 標準化や欠損補完、ターゲットエンコーディングは、訓練 fold だけで統計量を計算し、検証 fold に適用します。全データで先に計算すると検証情報が学習に漏れます。
- グループ構造を尊重する — 同一顧客や同一支店が訓練と検証にまたがると、モデルは汎化ではなく記憶で当ててしまいます。単位が明確なときは GroupKFold を選びます。
- 時間順を崩さない — 未来のデータで学習して過去を当てる分割は、本番では起こり得ない有利さを生みます。時系列データでは必ず時間順の分割を使います。
- スコアが良すぎるときこそ疑う — 実務の相場からかけ離れた高スコアや、極端に小さい fold 間のばらつきは、多くの場合リークの兆候です。
アンサンブルはこれらの前提の上で初めて意味を持ちます。健全な OOF 予測を土台に据えていれば、多シード平均やスタッキングは素直に効果を発揮します。
まとめ
第5回では、交差検証の設計から、それを土台にしたアンサンブルの組み立てまでを一続きの流れとして扱いました。要点を振り返ります。
- 分割はデータの性質で選ぶ。クラス不均衡には StratifiedKFold、グループ構造には GroupKFold、時間構造には TimeSeriesSplit を用いる。
lgb.cvと早期終了を組み合わせると、反復回数の見積もりと交差検証を同時に進められる。- OOF 予測は漏れのない検証スコアであり、スタッキングやブレンディングの共通の土台になる。
- アンサンブルは多シード平均から始め、必要に応じてスタッキングやブレンディングへ広げると扱いやすい。
- 前処理の位置、グループ、時間順に注意し、リークのない検証設計を保つことが精度の再現性を支える。
次回は最終回として、これまでの内容を統合した実践的な応用例とベストプラクティスを取り上げます。データ準備からモデル運用までを見据えた進め方を整理していきます。
エンハンスド株式会社では、機械学習モデルの構築から検証設計、データ活用基盤の整備、業務システムへの組み込みまでを一貫してご支援しています。予測モデルの精度改善や、既存の分析フローの信頼性向上をご検討の際は、ぜひお気軽にご相談ください。
参考リンク
本連載の全体像は Python×LightGBM入門(第1回 基礎と環境構築) にまとめています。
本連載「Python×LightGBM入門」全6回
- 第1回 勾配ブースティングの基礎と環境構築
- 第2回 分類問題の実装とモデル評価
- 第3回 回帰問題とハイパーパラメータ調整
- 第4回 特徴量エンジニアリングと重要度分析
- 第5回 交差検証とアンサンブル学習(本記事)
- 第6回 実践応用とベストプラクティス
この記事をシェア
関連記事
Python×LightGBM入門 第1回 勾配ブースティングの基礎と環境構築
表形式データの予測タスクにおいて、 勾配ブースティング決定木 は現在でも最も信頼される手法のひとつです。なかでも LightGBM は、学習の速さと精度の高さを両立し、…
【Python×LightGBM入門】第4回 特徴量エンジニアリングと重要度分析
第3回までで、LightGBM の学習・評価とパラメータ調整の基本を扱ってきました。第4回のテーマは、モデルの精度を最終的に左右する 特徴量エンジニアリング です。…
Python×LightGBM入門 第2回 分類問題の実装とモデル評価
本記事は全6回でお届けする「Python × LightGBM 入門」の第2回です。第1回では勾配ブースティング決定木の考え方と環境構築、最小構成での学習・予測までを扱いました。…