社内に蓄積されたドキュメントを、そのままLLMの回答根拠として活用したい。こうした要望に応える現実的な選択肢が、OSSのLLMアプリ開発プラットフォームである Dify です。ビジュアルなワークフローエディタとナレッジ(RAG)機能を組み合わせることで、コードを書かずにRAGアプリを構築し、APIやWebアプリとして公開できます。本稿では、2026年時点の Dify を前提に、ナレッジベースの作成から検索方式の設計、オーケストレーション、公開、運用までを実務ガイドとして整理します。
Dify とは何か
Dify は、LLM を用いたアプリケーションを設計・運用するためのオープンソースプラットフォームです。単なるチャットボットビルダーではなく、次の要素を一つの管理画面から扱える点が特徴です。
- ワークフロー / Chatflow — ノードをつなぐ形で処理フローを設計する。分岐や変数、複数ノードの連携をビジュアルに構成できる
- Agent — ツール呼び出しを伴う自律的なタスク実行を組み込める
- ナレッジ(RAG) — ドキュメントの取り込み、チャンク分割、インデックス化、検索設定、リランクまでを内蔵する
- モデルプロバイダ — OpenAI、Anthropic(Claude)、Azure OpenAI、およびローカルモデル(Ollama や vLLM 経由)などを差し替えて接続できる
- ツール / プラグイン — 外部APIや検索、コード実行などを部品として追加できる
提供形態は二つあります。手元やクラウド上に Docker Compose で構築するセルフホストと、運用をベンダーに委ねる Dify Cloud です。機密性の高い社内データを扱う場合や、モデル接続先・ネットワークを厳密に制御したい場合はセルフホストが適します。まず小さく試したい、インフラを持ちたくないという場合は Dify Cloud が手軽です。本稿では応用の効くセルフホストを中心に説明します。
セルフホスト環境を構築する
セルフホストは Docker と Docker Compose が動作する環境があれば始められます。公式リポジトリの docker ディレクトリに Compose 定義がまとまっており、環境変数ファイルをコピーして起動する流れです。
git clone https://github.com/langgenius/dify.git
cd dify/docker

# 環境変数ファイルを用意する
cp .env.example .env

# 起動
docker compose up -d

# 稼働中コンテナを確認する
docker compose ps
本番運用に向けては、初期パスワードや署名鍵などの秘匿値を必ず変更します。デフォルト値のまま公開すると不正ログインの温床になります。
# .env の主要項目(抜粋)
SECRET_KEY=<十分に長いランダム文字列>
# 外部公開URL。リバースプロキシ配下ではその外形URLを指定する
CONSOLE_API_URL=https://dify.example.com
APP_API_URL=https://dify.example.com
# 公開ポートを変えたい場合
EXPOSE_NGINX_PORT=8080
起動後、ブラウザで公開URLにアクセスすると初期管理者アカウントの作成画面が表示されます。ポート競合が起きる場合は、既存サービスと重ならないよう EXPOSE_NGINX_PORT を変更してください。運用ではこのコンテナ群の前段にリバースプロキシ(Nginx や各種ロードバランサ)を置き、TLS 終端と認証を組み合わせる構成が一般的です。
ナレッジベースを作成しRAGを設計する
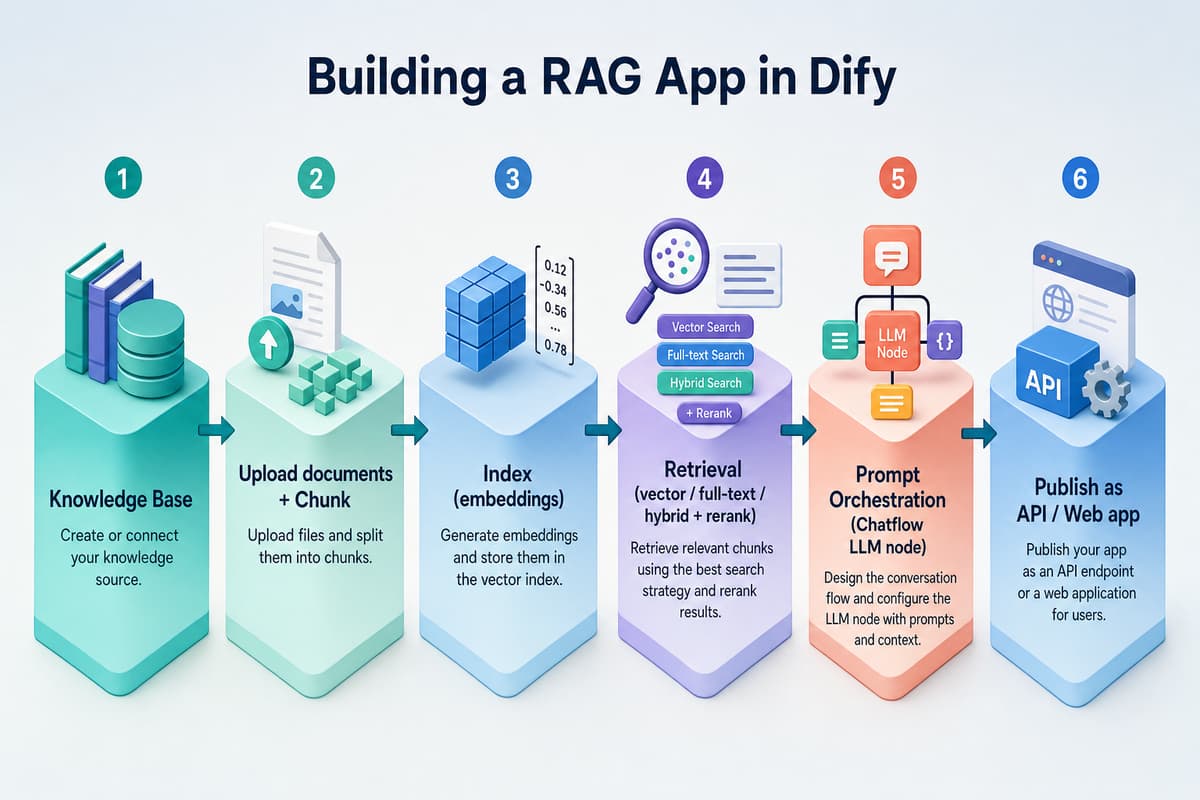
RAGアプリの品質は、ナレッジ(知識)側の設計でほぼ決まります。Dify では管理画面の「ナレッジ」から、文書のアップロードとインデックス化を対話的に進められます。手順の骨格は次のとおりです。
文書のアップロードとチャンク分割
PDF、Word、Markdown、テキスト、HTML などをそのまま取り込めます。取り込み時にドキュメントはチャンクと呼ばれる小さな単位に分割され、この単位で検索されます。チャンクの粒度が検索精度を大きく左右するため、次の観点で調整します。
- チャンクサイズ — 一般的な文書では数百トークン前後が扱いやすい。大きすぎると無関係な文脈が混ざり、小さすぎると意味の切れ目で情報が欠ける
- オーバーラップ — チャンク間で一部を重複させ、文の途中で切れた際の文脈欠落を緩和する
- 区切りルール — 見出しや段落など、文書構造に沿った分割を選ぶと意味的なまとまりを保ちやすい
Dify には自動でチャンクとインデックスを最適化するモードと、区切りやサイズを明示指定するカスタムモードがあります。まず自動で試し、想定した粒度で検索されない場合にカスタムへ切り替える進め方が現実的です。
インデックス方式と検索方式
インデックスには、埋め込みモデルでベクトル化する高品質モードと、キーワード主体の軽量な経済モードがあります。検索精度を重視するなら高品質モードを選び、埋め込みモデルをモデルプロバイダ設定で指定します。検索方式は用途に応じて次から選択します。
- ベクトル検索 — 埋め込みの類似度で意味的に近いチャンクを取得する。言い換えや同義語に強い
- 全文検索 — キーワードの一致で取得する。型番や固有名詞、コードなど厳密一致が効く場面に向く
- ハイブリッド検索 — 上記を組み合わせ、両者のスコアを統合する。多くの社内ナレッジでは第一候補になる
さらにリランクを有効にすると、一次検索で集めた候補をリランクモデルで並べ替え、本当に関連度の高いチャンクを上位に押し上げられます。Top-K(取得件数)とスコア閾値も併せて調整し、ノイズの混入と情報の取りこぼしのバランスを取ります。
アプリのオーケストレーションと公開
ナレッジが整ったら、それを使うアプリを組み立てます。RAG用途では、対話フローに検索と分岐を組み込める Chatflow が扱いやすい選択肢です。基本構成は、ユーザー入力を受ける開始ノード、ナレッジ検索ノード、取得結果を文脈として回答を生成するLLMノード、結果を返す終了ノードという流れになります。
回答の質を安定させる要はプロンプト設計です。取得したチャンクを文脈として渡し、根拠のない生成(ハルシネーション)を抑える指示を明示します。
あなたは社内ドキュメントに基づいて回答するアシスタントです。
以下の【参照文脈】に含まれる情報だけを根拠として回答してください。

- 参照文脈に記載がない場合は、推測せず「資料に記載がありません」と答える
- 回答の末尾に、根拠とした資料名を明記する
- 専門用語は必要に応じて平易に補足する

【参照文脈】
{{#context#}}

【質問】
{{#query#}}
LLMノードのモデルは、モデルプロバイダで接続済みのものから選びます。要約や整形が中心なら軽量モデル、複雑な推論を伴うなら高性能モデルというように、コストと品質の兼ね合いでノード単位に選定できます。
完成したアプリは、そのまま公開できます。ホスト型のWebアプリとして即座に共有するか、Webサイトへ埋め込む方法、そしてバックエンドから叩くService API があります。API はアプリ単位のキーで認証します。
curl -X POST 'https://dify.example.com/v1/chat-messages' \
  -H 'Authorization: Bearer app-xxxxxxxxxxxxxxxx' \
  -H 'Content-Type: application/json' \
  -d '{
    "inputs": {},
    "query": "経費精算の締め日はいつですか",
    "response_mode": "streaming",
    "user": "user-001"
  }'
この API を自社の業務システムや社内ポータルから呼び出せば、既存のUIにRAGの回答機能を組み込めます。
運用で押さえるべき論点
RAGアプリは公開して終わりではありません。情報の鮮度と回答品質を保つには、継続的な運用が前提になります。
権限とアクセス制御
ナレッジには機密文書が含まれ得るため、誰がどの知識にアクセスできるかの設計が欠かせません。セルフホストでは前段のプロキシで認証(SSO 連携など)をかけ、公開範囲を社内ネットワークに限定する構成が基本です。Dify のワークスペースやメンバー権限と組み合わせ、編集者と閲覧者の役割を分けます。
監視とログ
Dify には会話ログとアノテーション機能があり、実際の質問と回答を確認しながら改善点を洗い出せます。回答が的外れになった事例を収集し、チャンク設定・検索方式・プロンプトのどこに起因するかを切り分けると、改善が体系立ちます。取り込み済み文書の更新やアーカイブも定期的に行い、古い情報と新しい情報の混在を防ぎます。
コスト管理
コストは主に、埋め込みと生成にかかるモデル利用料、およびセルフホストのインフラ費で構成されます。ハイブリッド検索とリランクは精度を上げる一方で呼び出し回数が増えるため、Top-K や対象モデルを見直して無駄を抑えます。ローカルモデルを埋め込みや一部の生成に充てれば、外部API費用を圧縮できる場面もあります。
エンハンスド株式会社では、Dify をはじめとするOSSプラットフォームを活用し、生成AIアプリの内製化を支援しています。ナレッジ設計や検索精度のチューニング、セルフホスト環境の構築、既存システムとのAPI連携まで、要件整理から運用定着まで一貫してご相談いただけます。社内データを安全に活かすRAG基盤づくりをお考えでしたら、お気軽にお問い合わせください。
このテーマの全体像は .NET × AI 活用 完全ガイド にまとめています。
この記事をシェア
.NET / C# 案件のご相談はお気軽に
レガシー移行からクラウドネイティブ開発まで、
プロフェッショナルエンジニアが無料でご相談を承ります。
最短当日中にご返信。オンライン面談・NDA 締結にも対応します。
関連記事
.NET × Azure OpenAI で作る RAG 実装ガイド
RAG(Retrieval-Augmented Generation、検索拡張生成)は、LLM の生成能力に社内文書などの外部知識を組み合わせ、最新かつ根拠のある回答を生成する手法である。…
.NET × AI 活用 完全ガイド — アプリ組み込みからAI駆動開発まで
AI を「アプリに組み込む」側と、AI で「開発そのものを速くする」側——その両方をまとめた入り口ページです。 Azure OpenAI や RAG の実装、各種 LLM API の統合、…
Azure OpenAI と AI Search で作る RAG の実装ガイド
大規模言語モデルは一般的な知識には強い一方で、社内規程や製品仕様、契約書といった組織固有の情報は持ちません。この差を埋める手法が RAG(Retrieval-Augmented Generation、…